1.95亿步CS:GO多智能体数据集开源:模仿学习新测试平台

1.95亿步CS:GO十智能体状态-动作数据集,专为模仿学习与多智能体研究设计,免费开放。
cs-5v5-bots 是一个专为强化学习与模仿学习研究设计的大规模游戏行为数据集,包含1.95亿个时间步、9515场CS:GO机器人对局、约3958小时游戏数据。数据以16Hz频率采样,每个时间步记录动作、状态与伤害归因标签,14%的对局还附带逐帧对齐的十个第一人称视角视频。数据集刻意采用「窄域」设定——专家机器人、单一地图、仅使用手枪——以提供变量可控、噪声低的算法测试平台,而非模拟真实人类对局。数据以Parquet与webdataset格式提供,托管于Hugging Face,采用CC BY-NC 4.0许可开放使用,适合行为克隆、逆强化学习、多智能体建模与多模态学习等研究方向。
一个为模仿学习与多智能体研究量身打造的数据集
强化学习与模仿学习研究长期面临一个核心痛点:缺乏规模足够大、标注足够完整、噪声足够可控的行为数据。近期,一个名为 cs-5v5-bots 的新数据集在 Reddit 的强化学习社区发布,试图填补这一空白。这份数据集包含 1.95亿个时间步 的 10 智能体 CS:GO 状态-动作数据,并附带伤害标签,面向研究用途免费开放。
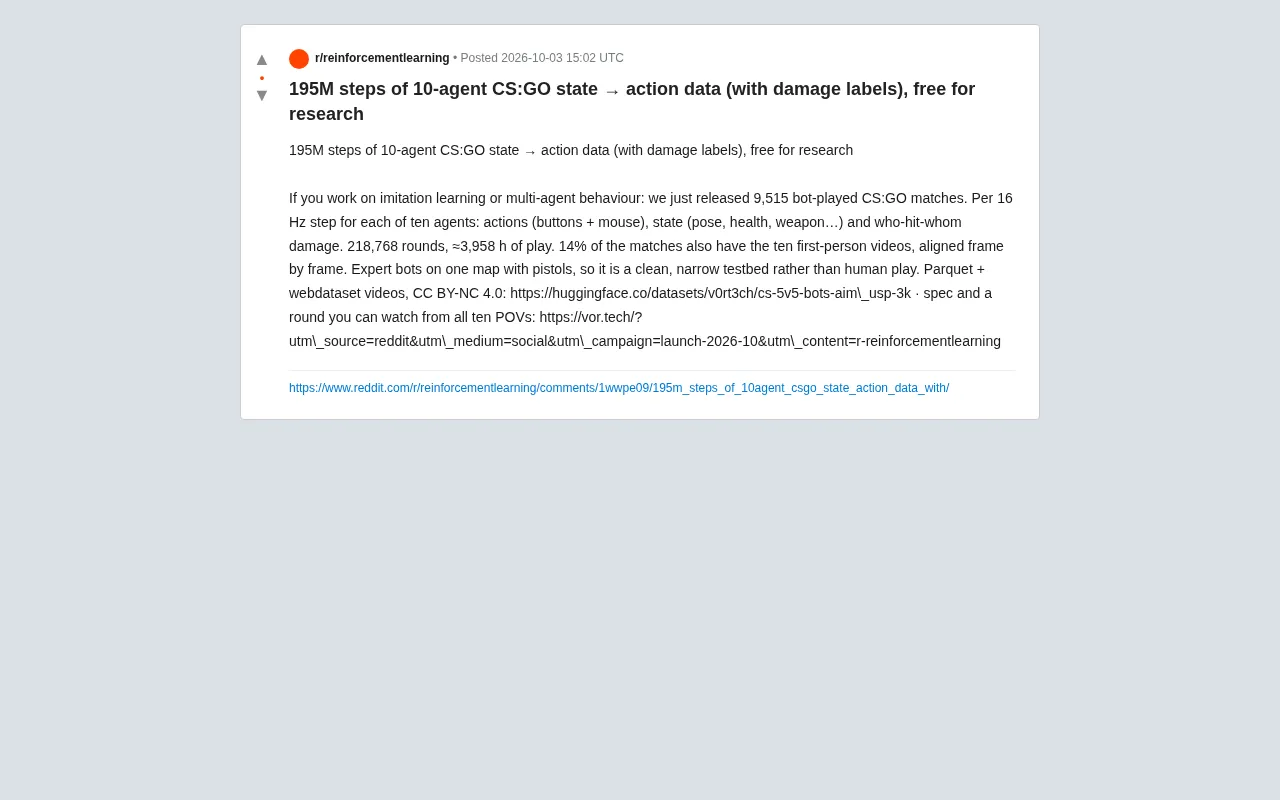
发布方 v0rt3ch 将其定位为一个 干净、窄域的测试平台(clean, narrow testbed),而非人类对局的真实复现。这种定位本身就透露出设计意图——它不追求模拟真实玩家行为的复杂性与不确定性,而是提供一个可控、可复现的环境,让研究者能够聚焦算法本身。
数据规模与采集细节
这份数据集的体量相当可观。具体数字包括:
- 9,515 场 机器人对局
- 218,768 个回合(rounds)
- 约 3,958 小时 的游戏时长
- 每个智能体以 16 Hz 的频率采样
对于十个智能体中的每一个,每个时间步都记录了三类信息:动作(按键输入 + 鼠标移动)、状态(姿态、血量、武器等)以及 谁击中了谁的伤害标签(who-hit-whom)。这种细粒度的伤害归因标注在同类游戏行为数据集中并不常见,它为研究对抗性多智能体交互、信用分配(credit assignment)等问题提供了直接的监督信号。
值得关注的是,其中 14% 的对局 还附带了十个第一人称视角视频,并且做到了 逐帧对齐。这意味着研究者不仅能拿到结构化的状态-动作数据,还能将其与原始视觉输入关联,为视觉模仿学习、从像素到动作的端到端训练等方向提供了难得的多模态素材。
信用分配(Credit Assignment)是多智能体强化学习中的经典难题:当多个智能体共同完成一个任务时,如何将最终的团队奖励拆解并分配给每个个体的具体动作?例如,一场团队配合击杀,究竟是发起突破的智能体功劳更大,还是提供掩护的智能体贡献更关键?传统方法往往只能依赖全局奖励信号进行模糊归因,训练效率低下。who-hit-whom 伤害标签直接提供了细粒度的个体行为结果,使得每个智能体的每次攻击行为都有明确的后果记录,为解决信用分配问题提供了天然的监督信号,可以显著降低多智能体训练中的方差,加速策略收敛。
为什么选择「窄域」而非真实对局
数据集的采集设定非常明确:专家机器人、单一地图、仅使用手枪。这种刻意收窄的配置是一个重要的设计决策。
人类对局数据虽然更贴近真实应用,但往往充满了技能水平波动、非理性决策、网络延迟等难以建模的噪声。而专家机器人在固定规则下的行为更加一致和可预测,这让数据集成为一个理想的 算法基准测试环境。研究者可以在一个变量相对受控的环境中验证模仿学习或多智能体协作算法的有效性,再逐步推广到更复杂的场景。
这种取舍也意味着使用者需要清醒认识其边界:基于这份数据训练出的模型,其能力上限受限于专家机器人的行为模式,而非人类玩家的创造性策略。它更适合作为方法论验证的「干净靶场」,而不是直接迁移到实战 AI 的训练集。
行为克隆(Behavior Cloning)是模仿学习中最基础的方法:将专家演示视为监督学习问题,直接用状态作为输入、动作作为标签训练策略网络。其核心缺陷是「复合误差」——智能体一旦偏离训练分布,后续的误差会不断累积放大。而逆强化学习(Inverse Reinforcement Learning, IRL)则走另一条路:不直接复制动作,而是从专家行为中反推出潜在的奖励函数,再基于该奖励函数优化策略,理论上具有更强的泛化能力。这两类方法都对数据质量高度敏感——噪声大的人类对局数据会让行为克隆学到错误模式,也会让IRL无法准确重建奖励信号。窄域机器人数据集的价值恰恰在于:行为高度一致、噪声来源可控,能让研究者把算法本身的缺陷与数据噪声带来的干扰清晰地分开。
数据格式与开放许可
在工程落地层面,这份数据集也考虑了可用性。结构化数据以 Parquet 格式提供,便于高效读取与大规模处理;视频则采用 webdataset 格式,适配现代深度学习的数据加载流水线。
许可方面,数据集采用 CC BY-NC 4.0 协议,即署名、非商业使用。这一许可对学术研究和非商业实验相当友好,但商业应用者需要注意其限制。数据集已托管在 Hugging Face(v0rt3ch/cs-5v5-bots-aim_usp-3k),发布方还在官网 vor.tech 提供了完整规格说明,以及一个可以从全部十个视角观看的回合示例。
Parquet 是一种面向列存储的开源数据格式,由 Apache 基金会维护。与传统的行存储格式(如 CSV)相比,列存储在读取特定字段时只需扫描对应的列,大幅减少 I/O 开销,且内置高效压缩,非常适合存储时序状态-动作数据这类列数固定、行数极多的结构化数据。webdataset 则是专为大规模深度学习训练设计的数据格式,将大量小文件打包成 tar 归档流,支持流式读取,与 PyTorch DataLoader 深度集成,能够在多 GPU 分布式训练场景下高效加载视频帧序列,避免海量小文件带来的文件系统瓶颈。两种格式的组合选择体现了数据集对工程实践的充分考量。
它能支撑哪些研究方向
综合来看,这份数据集的价值主要体现在几个研究方向上:
模仿学习:大规模、高频率、带完整动作标注的轨迹数据,正是行为克隆(behavior cloning)和逆强化学习所需的核心资源。
多智能体行为建模:10 个智能体同场竞技,加上伤害归因标签,为研究智能体间的协作、对抗与交互动态提供了结构化样本。
多模态学习:14% 带逐帧对齐视频的子集,让从视觉输入到控制动作的端到端学习成为可能。
当然,这份数据集的局限同样清晰——窄域设定决定了它更偏向方法验证而非通用能力训练。但对于需要一个干净、大规模、标注完整的基准测试平台的研究者而言,它提供了一个颇具吸引力的起点。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。