1.9M参数语音克隆TTS引争议:Kyutai新模型被指自审查

Kyutai 的 1.9M 参数 Pocket TTS 因自动过滤脏话引发开源社区对模型内嵌审查的争议。
Kyutai Labs 的 Pocket TTS 以 190 万参数和支持语音克隆重新受到关注,极小的体量使其适合智能家居、嵌入式设备等本地低功耗场景。但社区发现新版模型会自动将脏话替换为无意义词,旧版则不会,相关 GitHub issue 被标记为 not planned 关闭且未说明原因。用户质疑内容过滤应放在文本前端而非烧进模型权重,并指出过滤标准不一致。文章认为,轻量 TTS 的竞争不仅需要自然度、实时因子和说话人相似度的公开基准,也需要透明、可配置的内容策略与更充分的社区沟通。
Kyutai Labs 的 Pocket TTS 模型近期以 190 万参数(1.9M)的体量重新进入社区视野,并声称支持语音克隆。极小的模型尺寸意味着它可以在本地设备上流畅运行,对智能家居、嵌入式语音交互等场景非常有吸引力。但 Reddit 社区的一则讨论揭示了另一个焦点:用户发现新模型在合成语音时会自动「净化」脏话,而旧版模型不会。这一变化将技术性能与内容审查的边界问题同时推到了台前。
1.9M 参数背后的技术意义
从参数规模看,190 万参数的 TTS 模型属于极轻量级。作为参照,社区中常见的 Kokoro 单语言变体可以压缩到约 9MB 的模型体积,而 Pocket TTS 在体积上仍有竞争力。对于需要完全本地推理、低功耗运行的场景,这种级别的模型能够显著降低部署门槛。
发帖用户也承认尺寸「令人印象深刻」,但同时指出更关键的评估维度尚未被充分讨论:自然度、实时因子(RTF)以及不同说话人之间的语音相似度。语音克隆模型如果参数极少,音色保真度和跨说话人泛化能力往往是薄弱环节。目前社区缺乏公开的基准测试数据来回答这些问题,这使得 1.9M 参数更多是一个工程亮点,而非经过验证的产品优势。
实时因子(RTF) 是衡量 TTS 系统推理效率的核心指标,定义为合成一段语音所需的计算时间与语音时长的比值。RTF 小于 1 表示推理速度快于实时播放,是流式语音交互(如智能音箱、车载助手)的硬性门槛。对于 1.9M 参数这类极小模型,RTF 通常表现优异,但自然度与音色保真度往往同步下降,因此文章强调需要同时评估多项指标而非只看参数规模。
说话人相似度(Speaker Similarity) 在语音克隆任务中通常用嵌入向量余弦相似度或主观 MOS 分衡量,反映合成语音与目标说话人音色的接近程度。参数压缩会直接削弱声学模型的表征能力,使相似度成为轻量语音克隆模型最易暴露短板的维度——这也是社区呼吁公开基准数据的直接原因。
脏话被「净化」:是功能还是缺陷?
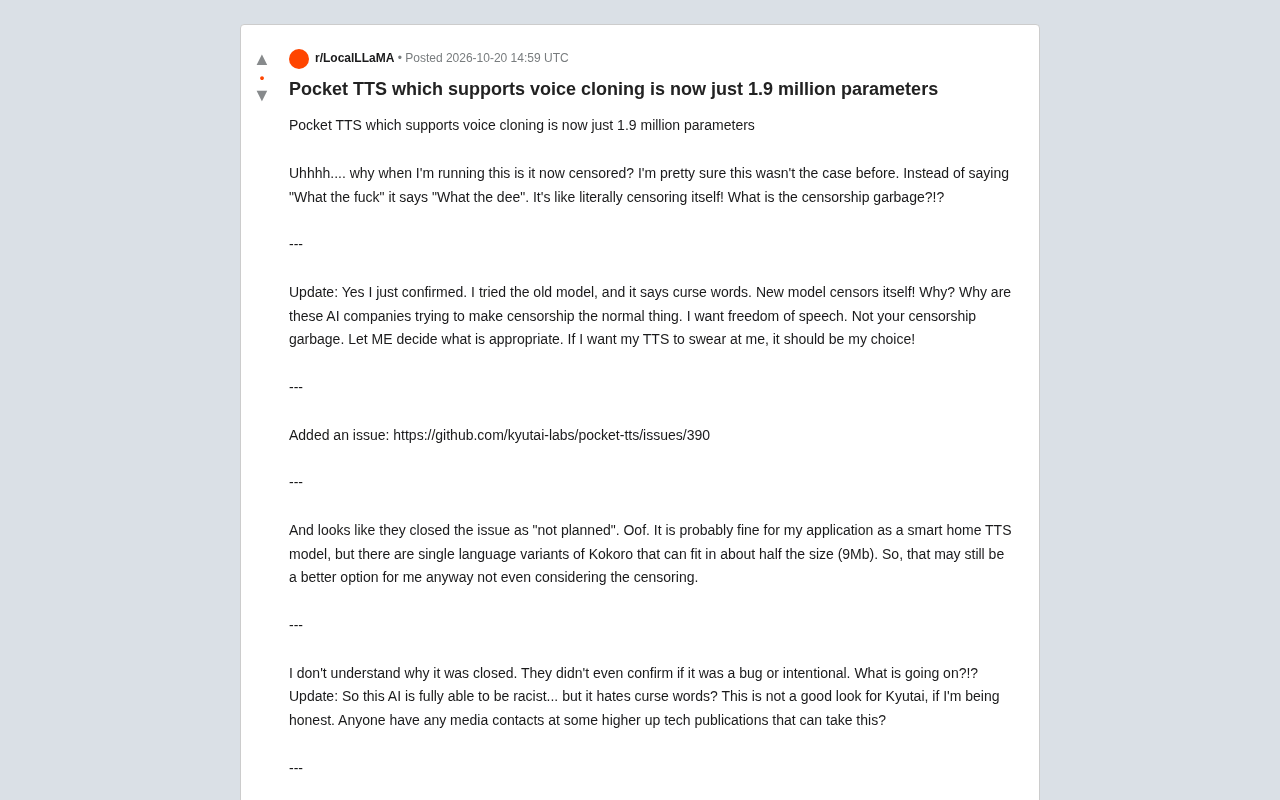
引发讨论的核心事件是:用户运行新版 Pocket TTS 时,发现模型会将粗口替换为发音相近但无意义的词。例如输入包含「What the fuck」的文本,输出变成「What the dee」。用户随后用旧版模型做了对照实验,确认旧模型会正常说出脏话,而新模型会自我审查。
该用户将问题提交到 Kyutai Labs 的 GitHub 仓库(issue #390),但该 issue 被标记为「not planned」并关闭。这一处理方式进一步激化了不满——关闭理由没有说明这是 bug 还是有意设计。从社区推测看,比较合理的解释是:Kyutai 正在将 Pocket TTS 的定位向企业级用户倾斜,因此默认加入了内容过滤,以牺牲爱好者社区的灵活性为代价。
用户的质疑:过滤应该发生在哪一层?
发帖用户提出了一个值得认真对待的工程观点:如果目标客户是企业环境,内容过滤本应在文本进入 TTS 模型之前完成,而不是内嵌在声学模型中。在管线前端做过滤,策略可配置、可审计、可替换;把过滤烧进模型权重里,则让所有下游使用者失去了选择权。
更让用户困惑的是过滤标准的不一致:模型据称可以生成种族歧视内容,却对脏话格外敏感。这种选择性审查在社区看来缺乏逻辑一致性,也对 Kyutai 的品牌形象不利。
文中提到的 GitHub issue #390 被标记为「not planned」,是 GitHub 仓库维护者关闭 issue 时的一种状态标记,表示该问题不会被纳入开发计划。它不同于「bug」或「duplicate」标签,本身不携带原因说明,因此当维护者未附加评论时,提交者无法判断该行为是刻意设计、训练数据副作用还是暂不处理的遗留问题。在开源治理实践中,这种「静默关闭」常被视为沟通不足,容易激化社区对厂商意图的猜测。
开源模型的内容策略困境
这起争议触及了一个更普遍的问题:开源 AI 模型是否应该内置行为约束。
从厂商角度,内置安全过滤可以降低滥用风险,也更容易满足企业采购的合规要求。但从使用者角度,开源的核心价值之一就是可修改、可定制。当模型权重本身承载了不可见的审查逻辑,用户即使拿到代码和权重,也难以轻易移除这层行为——除非重新训练或寻找社区分支。
发帖用户的立场很直接:成年用户应当自行决定 TTS 输出什么内容,并承担相应后果。他提到两个可能的出路——删除当前模型,或者等待社区 fork 出一个「解放版」。这种反应折射出开源社区对厂商单方面施加价值判断的敏感。
替代方案的现实考量
抛开审查争议,发帖用户也提到 Kokoro 的单语言变体在体积上约为 9MB,对智能家居 TTS 场景可能仍是更合适的选择。这意味着 Pocket TTS 即便在性能维度上,也面临成熟轻量模型的直接竞争。
模型 fork 指开发者复制开源仓库(含代码与权重)后独立维护的分支。对于内嵌审查逻辑的模型,fork 并不能直接解决问题:若过滤行为源于训练数据分布或对齐微调写入的权重,仅复制代码无法移除,需要重新训练或对权重做定向微调,成本较高。这正是文章所说「即使拿到代码和权重,也难以轻易移除这层行为」的技术原因,也是社区期待「解放版」分支却难以快速实现的关键障碍。
社区需要什么样的轻量 TTS
这场讨论最终指向两个需求:一是透明的性能基准,二是可预期、可配置的内容策略。
对于 1.9M 参数这样激进的压缩,社区需要看到自然度、实时因子和说话人相似度的量化对比,才能判断它是否真的可用。对于内容过滤,开源项目至少应该明确说明过滤的存在、范围和关闭方式,而不是让用户在不知情的情况下遭遇输出偏移。
Kyutai 关闭 issue 的方式留下了沟通缺口。无论过滤是刻意设计还是训练数据带来的副作用,一个明确的公开说明都比「not planned」更能维护社区信任。轻量 TTS 的竞争正在升温,技术指标之外,治理方式同样是开发者选择模型时的考量因素。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。