10分钟用Python调用决策模型Jev:让AI做选择与评分
Jev决策模型以极低成本完成分类、判断与评分,结合置信度阈值可安全自动化AI客服收件箱。
文章介绍了一种轻量化的AI决策方案:使用专为决策设计的模型Jev,通过Python几行代码即可完成No(是/否)、Choice(多选一)、Score(量表评分)三类结构化判断,而非生成自然语言文本。作者以Open Router为提供商演示了退款判断、团队路由和紧急程度评分,单次决策成本可低至不到一美分的千分之一。核心亮点在于将三种问题类型组合进同一请求,构建自动路由的AI客服收件箱,并用置信度阈值兜底:低于阈值转人工,高于阈值才允许AI处理。这种“不确定时诚实表达”的设计,使得模型无需永远正确,也能在极低成本下安全自动化大量常规决策。
当大语言模型被用来处理海量简单决策时,成本和延迟往往成为瓶颈。B站视频教程展示了一种更轻量的思路:使用专为决策设计的模型Jev(字幕中音译为Jav/Jab/Jace),通过Python几行代码完成分类、判断与评分,并串联成可落地的AI客服收件箱。
Jev是什么:不生成文本,只做决策
据B站视频教程介绍,Jev是一个决策模型,它的输出不是自然语言文本,而是针对某个状态给出的结构化判断。使用时你提供一段状态(比如一条客户消息),然后围绕这个状态提出三类问题:No(是/否问题)、Choice(在给定选项中选择一个类别或标签)、Score(按量表给某物打分)。
这种设计让Jev在处理大量常规决策时非常精准且极其便宜。视频强调,当你需要做出大量通常不想交给大语言模型处理的决策时,Jev是一个极佳的选择。
决策模型(Decision Model) 是一类专门为结构化判断任务设计的机器学习模型,与生成式大语言模型形成对比。传统LLM通过自回归方式逐token生成文本,推理成本高且输出需要额外解析;而决策模型通常直接输出概率分布或类别标签,针对分类、排序、评分等任务做了专门优化。这类模型往往参数更少、推理更快,适合高频、低复杂度的决策场景。Jev即属于此类,其输出不是自然语言,而是可直接消费的结构化结果(如布尔概率、选项概率、量表加权分),从而省去后处理步骤并大幅降低单位决策成本。
第一次调用:几行代码完成退款判断
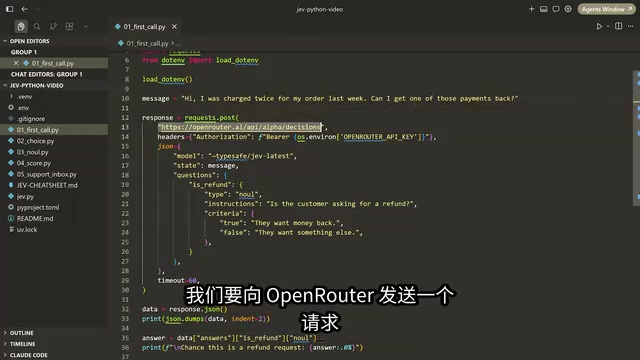
视频演示了通过Open Router发送请求的完整流程。作者推荐使用Open Router作为Jev提供商,注册账号、获取API密钥后即可开始。代码需要引入json、os和requests等模块,把客户消息作为Message传入——示例内容是“你好,我上周的订单被扣款了两次,我可以退回其中一笔付款吗”。
请求中需要指定模型,然后传入状态和一个问题数组。每个问题可以起任意有意义的名称,比如标记为“Refund”,类型设为No;在指令中写明“根据这个状态,客户是否在要求退款”,并给出True/False的标准。据视频演示,Jev返回的No值是一个0到1之间的数字,1代表True,0代表False,即模型认为该判断为真的概率。
运行代码后,响应中的Is_Answer_Refund类型为No,No值为0.98,意味着模型判断这是退款请求的概率为98%,可以把工单路由到退款团队。响应里的Usage字段还显示了成本——不到一美分的千分之一。作者建议封装一个Ask辅助函数,统一处理请求发送,后续示例都基于它展开。
Open Router 是一个聚合多家模型提供商的API网关,开发者通过单一API密钥即可调用不同厂商的模型,并按用量计费。它统一了请求格式(如兼容OpenAI的chat/completions结构),简化了多模型切换与对比的流程。在Jev的示例中,Open Router作为提供商负责将请求路由到Jev模型,响应中返回结构化决策结果及Usage成本字段。使用聚合网关的好处是无需分别注册各厂商账号,但需注意不同提供商对同一模型的支持程度和计费方式可能存在差异。
Choice:从多个选项中选择团队
Choice类型用于选择一个选项。视频示例中准备了多条客户消息,提出问题“哪个团队应该处理这条客户消息”,并提供四个选项及描述:Shipping、Tech、Billing、Sales。Jev会根据描述值判断消息应归类到哪一类。
据演示,示例消息包括“我的包裹显示已送达但门口没有”“我无法登录,一直说密码错误”“为什么我的套餐是29美元却收了49美元”等,模型分别给出了对应的团队归类。Choice的答案包含所选项和一个概率列表;如果模型信心不足,会给出非1的置信度,各个选项的概率值相加等于1,形成概率分布。
概率分布(Probability Distribution) 在这里指Choice类型返回的各选项概率值之和为1的归一化结果。例如四个团队选项分别得到0.1、0.7、0.15、0.05,表示模型认为Tech团队处理该消息的概率最高。这种输出比单一硬标签包含更多信息:最高概率即为所选类别,其数值本身可视为置信度。当最高概率接近1时模型非常确定;当多个选项概率接近时则表明模型犹豫。开发者可利用这一分布设置动态阈值,仅在最高概率超过阈值时才自动路由,否则转人工复核。
Score:用加权平均给出紧急程度
Score类型用于按量表评分。视频以工单紧急程度为例,指令为“这个支持工单有多紧急”,标准传入一个包含三个值的数组,分别对应量表上的0、1、2,即不紧急、正常、紧急。如果有四个标准,量表范围就会扩展到0到3,标签均匀分布在量表上。
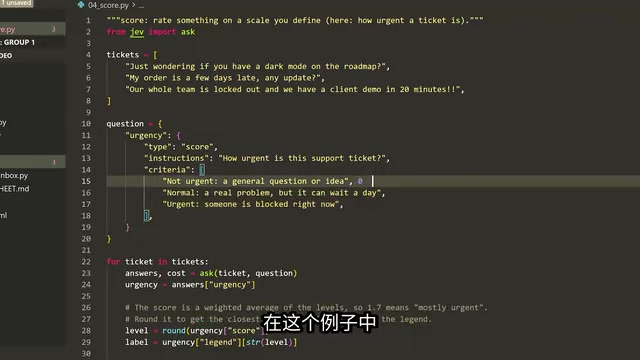
Jev返回的评分是各个级别的加权平均值。例如评分0.96,表示它被评为0的概率是0.96、被评为1的概率是0.05,加权平均后总分约0.96,同时给出约93%的置信度。演示消息中,“想知道路线图上有没有深色模式”被评为0(一般问题),“我的订单晚了几天,有任何更新吗”评分0.96(正常但可等),“整个团队被锁在外面而且20分钟后有客户演示”评分2(极其紧急)。
加权平均(Weighted Average) 在Score类型中用于将离散量表上的概率分布转换为连续评分。假设量表标签为[0,1,2],模型返回各级别概率[p0,p1,p2],则最终评分为0×p0+1×p1+2×p2。这种做法的好处是保留了对不确定性的表达:若模型认为某工单“正常”和“紧急”各占一半,评分会落在中间值附近,而非武断地取整。同时,最高概率值可作为置信度参考。开发者需注意,加权平均分可能落在非整数位置,业务侧应定义好分数区间的解释规则(如低于0.5视为不紧急)。
多问题组合:构建一个简单AI客服收件箱
视频最后把三种问题类型整合进同一个请求:对每张工单同时询问应分配给哪个团队(Choice)、是否想要退款(No)、紧急程度如何(Score),并计算总成本。作者加入了一个实用的兜底逻辑——当置信度低于某个预值时不信任AI的判断,转交人工处理;高于阈值才允许AI实际处理。
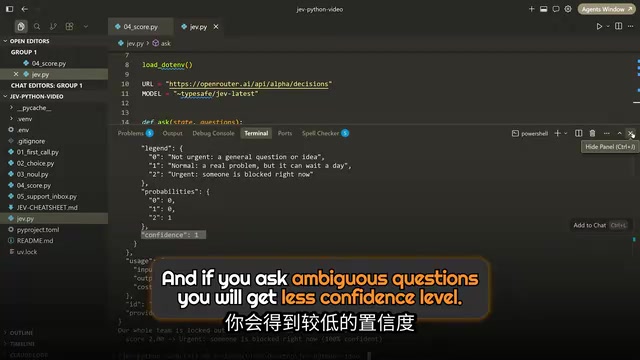
实际运行结果覆盖了多种场景:本月订阅被扣两次费,团队Billing、退款True、紧急程度94%,进入退款队列;App在Android打开设置页崩溃,团队Tech、退款False、紧急程度1.63;询问团队计划的消息置信度仅44%,退款False、紧急程度0.14,因不确定而转人工;“整个公司无法登录”则拿到2的高紧急程度和100%置信度。作者提到,分类这些工单的总花费大约在千分之一甚至万分之一美分级别。
这种置信度驱动的分流是整套方案最值得借鉴的部分:模型不需要永远正确,只要在不确定时诚实表达、把决定权交还给人,就能在成本极低的前提下安全地自动化大量常规决策。
实操注意事项
- 问题名称要起得有语义,便于从响应中按名称取值。
- 问题类型只能是No、Choice、Score三种之一,量表标签数量决定评分区间。
- 提供商不限于Open Router,Jev官方API或任何你习惯的服务均可,请求结构保持一致。
- 复杂或模糊的问题会导致置信度下降,务必用阈值兜底而不是全盘信任。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。