141份实测揭秘:你的显卡跑大模型到底有多快?

社区141次显卡跑分揭示:显存决定大模型速度,双卡是救援非倍增,4090性价比最高。
一项由社区普通人完成的显卡跑分实验,在三周内收集了141次提交,覆盖45种显卡,从Tesla P40到RTX 5090。基于90份有效数据,核心结论是:显存容量与解码速度中等相关(R=0.41),而内存总容量几乎无关(R=0.13),16G到24G显存速度提升73%。双卡并行仅提升1.22-1.81倍,两张卡是甜点。版本迭代中位提升仅1.08倍,且可能翻车。RTX 4090以118.0中位速度和9份样本成为最可信的性价比之王,RTX 5090以168.0居首。社区提交中58%超过60 tok/s,对话体验流畅,但仅20%达到100 tok/s以上的丝滑水平。
一场由普通人完成的显卡跑分实验
没有厂商发布会,没有统一的测试环境,三周内141次提交、2156个文件,来自一群普通人在自己家里用同一款大模型跑出的真实数据。这些数据覆盖了从2016年早该回收的Tesla P40到刚上市还需加价的RTX 5090,共45种显卡。
很多人以为跑本地大模型的门槛是钱,但翻完这批数据后,一个更扎心的结论浮出水面:真正卡住人的不是预算,而是你根本不知道自己的显卡能跑多少。据B站UP主“Strata”整理,这141份提交中,社区贡献了103份,官方验收报告15份,内核验证25份。不过,能明确显卡型号的只有124份,能算出解码速度的仅90份——不少提交只丢了个日志,没写清配置。因此,后续核心结论均基于这90份有效数据。
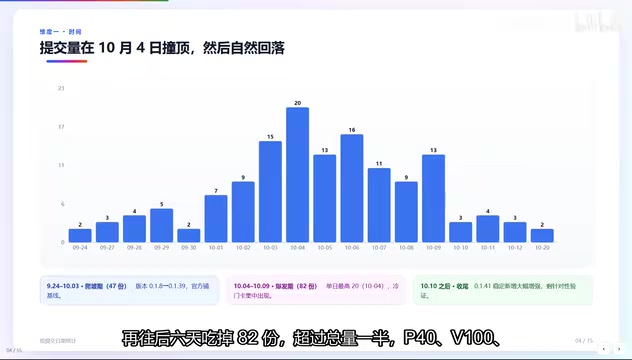
提交节奏:不是慢慢渗透,而是突然爆发
提交量的增长曲线很有意思。前10天只有47份,官方铺基线、社区官网陆续跟进;到了某一天,单日突然冒出20份;再往后6天吃掉82份,超过总量一半。P40、V100、MI50这些老卡全挤在这几天出现,随后热度迅速冷却。
这种节奏很像开源项目的典型扩散模式:不靠缓慢渗透,而是等某个版本刚好跨过“能用”那条线,大家一窝蜂涌进来。版本号本身不解释任何东西,但版本迭代带来的性能变化却值得细看。
版本迭代:小步快跑,但新版本真会翻车
26个版本中,提交量最集中的是0.1.38、0.1.39各20份,加上0.1.11的15份。很多人第一反应是“越新越快”,但7组同级跨版本对比(硬件差异全部排除)显示:5组变快,2组变慢。表现最好的是双RX 6900XT,快了三分之一还多;但RTX 4090跑俄语反而慢了一点,ARC Pro B65掉了11%。中位数只有1.08倍——说白了,版本迭代是小步快跑,而且新版本真会翻车,别无脑升。
tok/s(tokens per second) 是大模型推理中衡量解码速度的核心单位,表示每秒生成的 token 数量。一个 token 大致对应一个英文单词或半个汉字,因此 tok/s 直接决定了对话的流畅度:低于 10 tok/s 时输出会明显卡顿,30 tok/s 左右接近正常阅读速度,60 tok/s 以上则感觉几乎即时响应,100 tok/s 以上属于“丝滑”水平。文中所有速度数据均以此为单位,且通常指解码阶段(生成阶段)的速度,不包括预填充(处理输入提示)阶段。
显卡反差:旗舰不是主力,专业卡不等于快
提交量第一的是RTX 4090(12份),第二是RX 6900XT(11份),RTX 5090只有10份。社区主力根本不是旗舰卡,4090和6900XT才是大家手里真有又愿意折腾的卡。
速度上,旗舰档中位116,高端档71.5,主流档59.6。最意外的是服务器和专业卡档,中位只有32.4。V100、P40、P100二手便宜、显存又大,很多人觉得是捡漏,可它们是2016、2017年的架构。专业卡不等于跑得快,买之前看清年份。
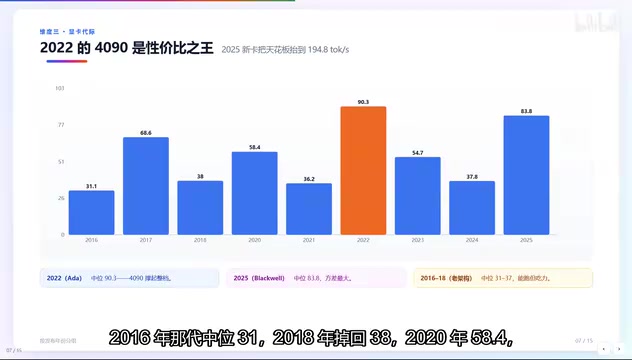
按年份排一排,规律就出来了:2016年那代中位31,2018年回到38,2021年58.4,2021年另一批36.2,2022年一下跳到90.3(全场最高),2025年83.8。2022年的尖峰几乎就是RTX 4090一张卡撑起来的,到现在它还是性价比之王。2025年为什么反而低?这一代什么都有——既有能冲到194.8的5090,也有入门卡、笔记本和核显,平均下来就被拉低了。所以看代际级别,不能只看中位数,得看分布,同一代里最快最慢能差好几倍。
反直觉发现:决定速度的是显存,不是内存
这是整个项目最想讲的结论,因为它推翻了“内存越大越好”的直觉。显存和速度的相关系数R是0.41,中等相关,说明显存确实有用;但显存加内存的总容量和速度的R只有0.13,基本等于没关系。
128到191G那档中位是47.5,而64到95G那档反而是75.7——大内存反而慢。原因挺朴素:会堆128G内存的人,配的往往是V100、Pro非AI这类老卡,还有三台是核显机器,128G统一内存却没独立显存。而显存这条线很干脆:16G到24G,中位从56.8跳到98.3,快了73%。决定你能跑多快的是显存,不是内存条。
显存(VRAM) 是显卡上专用的高速内存,直接与 GPU 芯片相连,负责存放模型权重、KV 缓存和中间计算结果。当模型规模超过显存容量时,系统会被迫将部分层或缓存卸载到主内存(RAM)甚至硬盘,导致速度急剧下降——这就是“能不能跑起来”的阈值。而内存(RAM) 是主板上的系统内存,容量再大也无法直接加速 GPU 计算,除非用作显存不足时的溢出缓冲区。因此,显存容量决定了模型能否完全放入 GPU 以及能支持多长的上下文,是解码速度的首要硬件瓶颈;内存容量则主要影响多任务处理和模型加载,对纯推理速度贡献甚微。
你的卡能跑多少:42张卡的速度表
42张卡按速度排好了,能收型号,按厂商筛、按显存筛,点开就能横看每次跑分。几个常被问的:RTX 5090是168.0,目前天花板;RTX 4090是118.0,样本最多9份,最可信;RX 6900XT是50.0,能跑但不轻松;V100只有29.8,二手捡漏的可以冷静一下。
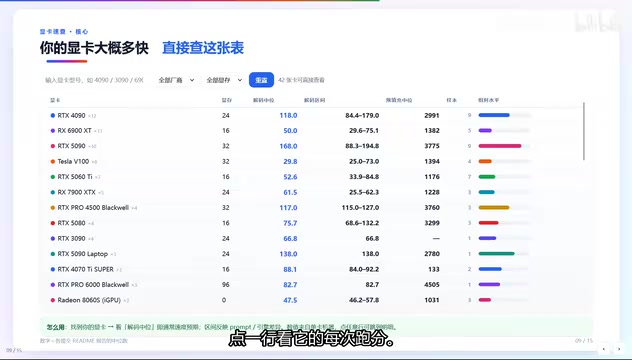
一定要强调区间:同型号最快最慢能差两三倍,中位数是通常水平,区间是你可能遇到的最好和最坏。冷门亮点是5090 Laptop笔记本版也能跑到138。最快的10张里,第一名没悬念是5090中位168.0、峰值194.8;第二名不是另一张桌面卡,而是5090笔记本版138。Blackwell这代确实领先,4090最值得买,118的中位、9份样本,数据最扎实。
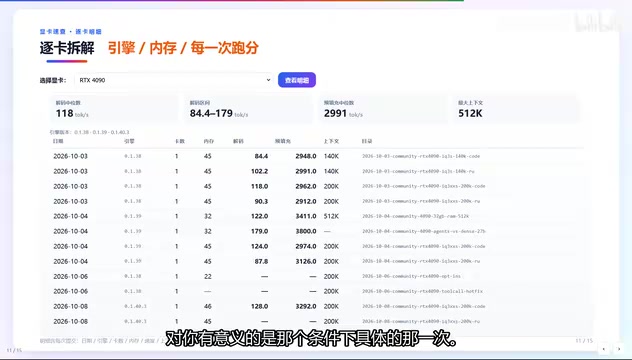
从体验线看,58%的提交超过60 tok/s,对话体验其实流畅;但跑到100以上、算得上丝滑的只有20%。这页是给已经有卡、想知道细节的人准备的:选一张卡点开,能看到解码中位区间、预填充、最大上下文,下面还有一张表列出每一次提交——哪天跑的、什么引擎、几张卡、多少内存。
为什么要单独做一页?因为中位数天然会骗人。某张卡中位118看着很稳,可翻明细会发现它有一次只有84,另一次冲到179。你要是正好打算用某种量化、某个上下文长度,对你有意义的是那个条件下具体的那一次。建议三层看:上一页找卡,这页确认条件,最后去Excel翻原始记录。
双卡:是救援,不是倍增器
很多人觉得差两张卡不就快一倍吗?四组实验全部同级、同版本、同提示词,只改卡数:Pro 4500跑Q4,单卡61.5,双卡111.0,1.81倍提升最大;Tesla P40从19.6到34.8,1.78倍——单卡49.6基本没法用,双卡才勉强能接受;另外两组是1.48和1.22倍。越快的卡,加卡收益越小,因为第二张卡能分担的活变少了。加第三张解码只多1%,还有反效果;128K域填充从57掉到22.95,直接腰斩。双卡能救“跑不动”,救不了“已经够快”,两张就是甜点。
双卡并行 在本地大模型推理中通常指将模型按层拆分到两张显卡上(张量并行或流水线并行),或使用两张卡分担计算。理想情况下速度可接近翻倍,但实际受限于卡间通信开销、负载均衡和任务粒度:当单卡已经能较快完成任务时,第二张卡可分担的计算比例下降,加速比随之降低;增加第三张卡时,通信与同步成本可能超过收益,甚至因调度冲突导致性能反降。此外,双卡对预填充阶段(处理长上下文输入)的加速往往不如解码阶段明显,文中 128K 域填充速度腰斩即为例证。
五条结论,记住就够
- 显存决定上限,内存只决定能不能跑起来:16G到24G快73%,内存相关系数只有0.13。
- 老卡堆内存是白花钱:128G档中位47.5,还不如64到95G档的75.7。
- 双卡是救援不是倍增器:1.22到1.81倍,两张是甜点。
- 版本是小步快跑:中位1.08倍,新版本可能翻车。
- 社区已经跑完了:89%超过30 tok/s,58%超过60 tok/s。
一句话:先看显存够不够装小模型,再看单卡能不能跑到30,不够加第二张卡。至于内存条,它真不是解药。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。