Battle Royale:16智能体大逃杀MARL竞技联赛解析
当强化学习遇上「大逃杀」
多智能体强化学习(MARL)一直是AI研究中最具挑战性的方向之一。与单智能体环境不同,MARL需要处理智能体之间复杂的博弈、协作与对抗关系,这使得训练和评估都变得异常困难。回顾MARL的发展历程,从早期的矩阵博弈、网格世界,到DeepMind的星际争霸AlphaStar、OpenAI的Dota 2 AI「OpenAI Five」,研究者们一直在寻找能够充分测试多智能体交互能力的环境。MARL面临的核心挑战包括:环境的非平稳性(每个智能体的策略都在变化,导致其他智能体面对的「环境」也在不断变化)、信用分配问题(在多智能体协作中,如何判断某个智能体对最终结果的贡献)、以及策略空间的指数级爆炸。这些挑战使得传统的单智能体RL算法——如PPO、SAC等——在直接应用于多智能体场景时往往效果不佳,催生了QMIX、MAPPO、MADDPG等专门针对多智能体场景的算法。
其中,这些专用算法各有不同的设计哲学。QMIX由牛津大学提出,采用集中式训练-分布式执行(CTDE)范式,通过一个混合网络将各智能体的局部Q值单调地组合为全局Q值,从而在保证可分解性的同时实现协调。MAPPO则是将单智能体PPO算法扩展到多智能体设定,利用共享的全局状态信息作为中心化critic的输入,在实践中表现出令人意外的强大性能,甚至在许多基准上超越了专门设计的MARL算法。MADDPG由OpenAI提出,将Actor-Critic框架扩展到多智能体连续动作空间,每个智能体拥有独立的Actor但Critic可以访问所有智能体的观测和动作信息。这些算法的共同思想是在训练时利用额外的全局信息来稳定学习过程,而在执行时仅依赖局部观测来做决策。
最近,一个名为 Battle Royale 的项目在 Reddit 机器学习社区引发讨论——它把「大逃杀」游戏机制搬进了强化学习竞技场,创造出一个持续运行的16智能体在线联赛。
这个项目的核心设定极具张力:每一局比赛(episode)中有 16 个 AI 智能体同场竞技,采用部分可观测(partial observability)设定,每个智能体只有一条命,并且不断收缩的安全区会强制智能体们发生接触和冲突。单局时长约 150 秒,所有对局都可回放,联赛通过 Elo 评分系统持续运行。
Elo评分系统最初由匈牙利裔美国物理学教授阿帕德·埃洛(Arpad Elo)在1960年代为国际象棋设计,其核心思想是通过对手的强弱来动态调整选手的分数——击败高分对手获得更多积分,输给低分对手则扣除更多积分。其数学基础建立在对数概率模型之上:两名选手之间的预期胜率由双方分差决定,分差每增加400分,预期胜率约为10:1。在AI领域,Elo系统已被广泛用于评估智能体水平,例如DeepMind在AlphaGo和AlphaStar的论文中都使用Elo来衡量不同版本模型的相对强度。对于多智能体场景,Elo系统的优势在于它不需要一个绝对的评价标准,而是通过大量对局的相对胜负来逼近每个智能体的真实水平。不过,传统Elo是为1v1设计的,在16人混战的「大逃杀」场景中,通常需要采用多人Elo变体(如将每局中的排名转换为两两对比的胜负记录)来进行评分。值得一提的是,Elo系统的一种重要推广——Bradley-Terry模型——为多选手场景提供了更严谨的数学框架,它通过最大似然估计来同时拟合所有选手的能力参数,这也是Chatbot Arena等现代评估平台所采用的核心统计模型。
为什么这个MARL环境值得关注
真实的开放元博弈
Battle Royale 最有趣的地方在于它的「开放元博弈」(open meta)。项目允许提交任意代码作为策略——脚本化的启发式基线(scripted baselines)被视为「一等公民」,与训练出来的神经网络策略平等竞争。
所谓「元博弈」(metagame),是博弈论中的一个重要概念,指的是在一组可选策略之上形成的「策略选择的博弈」。在竞技场景中,如果策略A克制策略B,策略B克制策略C,而策略C又克制策略A,就会形成类似「石头剪刀布」的元博弈循环。在传统的封闭实验中,研究者通常预设固定的对手策略池,元博弈的结构是静态的。而在开放元博弈中,任何人都可以随时提交新策略,这意味着元博弈的结构是动态演化的——一个曾经的最优策略可能因为新策略的出现而被「克制」,进而引发整个策略生态的连锁反应。这种动态性与进化博弈论中的「红皇后效应」高度吻合:你必须不断奔跑(进化),才能维持在原地(保持竞争力)。纳什均衡在这种开放环境中可能是不断漂移的,这为研究MARL中的策略鲁棒性和泛化能力提供了极其丰富的实验素材。
从更深层的理论角度看,开放元博弈的动态演化与「经验博弈论分析」(Empirical Game-Theoretic Analysis, EGTA)密切相关。EGTA由密歇根大学的Michael Wellman等人系统化提出,其核心思想是:当博弈的完整策略空间过于庞大而无法直接分析时,可以先收集有限策略集合之间的对局数据,构建一个经验收益矩阵(empirical payoff matrix),然后在这个简化的博弈上寻找纳什均衡或其他解概念。Battle Royale的持续联赛天然地在生成这样的经验数据——每一轮对局都在丰富策略之间的交互信息,使得社区可以对元博弈的结构进行量化分析。
开发者观察到一个耐人寻味的现象:在开放的竞技环境中,手写的启发式规则策略正在被训练出来的策略「吃掉」。这本身就构成了一场生动的实验——它直观地展示了在复杂博弈环境下,学习型策略相较于人工设计规则的优势演化过程。这一现象也回应了AI研究中一个经久不衰的辩论:在多大程度上,人类的领域知识(以手工规则的形式体现)能够与数据驱动的学习方法竞争?AlphaGo的发展史提供了一个经典的参照——早期版本AlphaGo Fan大量依赖人类棋谱的监督学习,而后期的AlphaGo Zero完全通过自博弈从零开始学习,最终远远超越了依赖人类知识的版本。Battle Royale中启发式策略被逐渐淘汰的过程,可能正在小尺度上重现这一规律。对于研究者而言,这种真实、动态的对抗生态远比静态基准测试更有说服力。
部分可观测与强制冲突机制
从环境设计角度看,几个关键机制值得强调:
-
部分可观测性:智能体无法看到全局信息,必须在不确定性下决策,这更贴近现实世界问题。在强化学习的理论框架中,完全可观测的环境被建模为马尔可夫决策过程(MDP),其中智能体能够获取完整的环境状态信息。然而,部分可观测环境对应的是部分可观测马尔可夫决策过程(POMDP),智能体只能获得状态的一个局部观测——类似于人类在战争迷雾中作战。POMDP在计算上比MDP难度大幅增加,因为智能体需要维护一个关于环境真实状态的「信念」(belief),并基于这个不确定的信念来做决策。精确的信念更新需要对所有可能的隐藏状态维护一个概率分布,并在每一步根据新观测进行贝叶斯更新,其计算复杂度随状态空间大小指数增长。在实践中,常见的处理方法包括使用循环神经网络(如LSTM或GRU)的隐藏状态作为信念的隐式表示——网络通过端到端训练自动学习将历史观测压缩为对决策有用的表征。近年来,Transformer架构也被引入这一领域,其自注意力机制能够更灵活地关注历史中的关键时刻,Decision Transformer等工作已经展示了这一方向的潜力。Battle Royale的16人大逃杀环境中,部分可观测性意味着智能体不知道视野外其他对手的位置和状态,这迫使智能体学习主动探索、信息收集和风险评估等高级行为——例如,智能体可能需要记住几十秒前在某个方向看到的对手、推断安全区收缩后对手可能的移动方向,这些都对记忆架构提出了很高的要求。
-
收缩安全区:这一机制借鉴了《PUBG》和《Fortnite》等大逃杀游戏的经典设计,强制智能体产生接触,避免了「消极躲避」的退化策略,确保每局都有充分的博弈互动。从强化学习的角度看,收缩安全区本质上是一种「课程设计」——随着时间推移,可用空间的缩小迫使智能体从低冲突的「探索阶段」过渡到高冲突的「决战阶段」,这种自然的难度递增对策略的鲁棒性提出了更高要求。这种设计在RL文献中与「课程学习」(curriculum learning)的思想不谋而合:通过逐步增加任务难度来引导智能体的学习过程,避免一开始就面对过于困难的场景而导致训练信号稀疏。不同的是,收缩安全区是环境内置的动态机制,而非训练流程中人为设置的阶段性调整。
-
单一生命值:一次死亡即出局,提高了每个决策的权重,也考验策略的长期规划能力。这与许多RL训练环境中允许频繁重生形成鲜明对比——在只有一条命的设定下,智能体必须学会权衡风险与收益,避免贪婪的短视行为。从技术角度看,单一生命值意味着每个episode的长度是可变的(被早期淘汰的智能体episode更短),这对价值函数的估计提出了额外挑战。同时,由于无法通过「多次尝试取平均」来消除随机性,智能体的策略必须对不利的随机事件具备足够的鲁棒性——这与金融领域的风险管理有相似之处,一次灾难性的损失无法通过后续的收益来弥补。
-
15 个未知对手:面对一个由 15 个未知策略组成的对手场,智能体必须具备泛化和适应能力,而不能只对特定对手过拟合。这一设定直接挑战了MARL中一个核心难题——对手建模(opponent modeling)。智能体是否应该在对局中实时推断对手的策略类型并做出相应调整?还是应该训练一个对所有可能对手类型都足够鲁棒的通用策略?这两种哲学路线在MARL研究中一直存在争论。前者的代表工作包括LOLA(Learning with Opponent-Learning Awareness)和ToMnet(Theory of Mind Network),它们试图让智能体学会预测对手的行为甚至对手的学习动态;后者则更接近「极大极小」(minimax)的思想,追求最坏情况下的最优表现。在16人混战的场景中,实时建模每一个对手的策略可能计算上不可行,但对不同「类型」的对手(如激进型、防守型、游击型)进行粗粒度的分类和适应,可能是一个实用的折中方案。
这些设计共同构成了一个高维、动态、充满对抗的测试床,对当前的多智能体强化学习算法提出了实实在在的挑战。
极低的参与门槛:零GPU也能玩转MARL
对于想要尝试的开发者和研究者,这个项目在工程上做了大量降低门槛的工作:
- 免费参与:无需付费即可进入联赛。
- 托管评估:所有评估(evals)都在服务端运行,参与者不需要自己准备 GPU,这大幅降低了实验成本。
- 快速上手:据开发者介绍,提交第一个策略只需要一段 Claude Code 或 Codex 的提示词(prompt),几分钟即可完成。
这种「零基础设施」的设计思路意义重大。传统的多智能体强化学习实验对算力的需求往往令人望而却步:OpenAI Five训练Dota 2 AI使用了256块GPU和12.8万个CPU核心,累计消耗了数百petaflop-days的算力;DeepMind的AlphaStar也使用了多达数千个TPU。即使是较小规模的MARL实验,在训练阶段也通常需要同时模拟多个环境实例来收集经验数据,这对GPU和内存都有较高要求。Battle Royale将评估计算完全托管在服务端,参与者只需要提交策略代码(可以是预训练好的模型权重加推理代码,也可以是纯规则脚本),这使得更多缺乏算力资源的个人开发者和学生也能参与到MARL研究和实践中来。
这种模式并非完全首创——Kaggle平台上的一些AI竞赛(如Connect X、Hungry Geese等)以及Lux AI挑战赛也采用了类似的托管评估方式,但Battle Royale在多智能体数量(16个)和环境复杂度上更进一步。值得注意的是,这种托管评估模式在技术上需要解决一个关键问题:推理延迟。在实时对战环境中,每个智能体需要在严格的时间限制内(通常是几十毫秒)返回动作决策,这意味着提交的策略不能使用过于庞大的模型——这在客观上形成了一种有趣的约束:参与者需要在模型能力和推理速度之间找到平衡,这与实际机器人控制和自动驾驶等领域面临的工程约束高度一致。相比动辄需要大规模集群的传统多智能体强化学习实验,这种托管式竞技平台无疑降低了探索的成本。
即将开赛的锦标赛
开发者透露,一个新的锦标赛赛季即将开启,并设有小额现金奖励。这种带有奖金激励的「强制函数」(forcing function),往往能有效激发社区的参与热情和策略创新。项目地址为 br-open.vercel.app。
开发者在帖子结尾提出了一个开放式问题:面对一个由 15 个未知对手策略组成的战场,机器学习社区会尝试怎样的方法?这也正是这类开放竞技平台的价值所在——它把研究问题转化为一个持续演化的公共实验,任何人的创意都可能改变整个元博弈的格局。从技术路线的角度,社区可能尝试的方法包括:基于自博弈(self-play)训练的策略,借鉴AlphaGo/AlphaStar的成功经验在训练中与自身的历史版本对弈以提升鲁棒性;基于群体训练(population-based training, PBT)的方法,同时维护多个策略的种群并让它们相互竞争和进化;以及近年来兴起的将大语言模型(LLM)与RL结合的方法,利用LLM的推理能力来生成高层战术规划,再由底层控制器执行具体动作。
自博弈(self-play)的核心思想可追溯到Tesauro在1990年代用TD-Gammon训练西洋双陆棋的开创性工作。现代自博弈通常维护一个历史策略池,当前策略在训练时从池中采样对手,这样可以避免策略的循环遗忘(catastrophic forgetting)——即新策略只学会了击败最新版本的自己,却忘记了如何应对早期版本的策略。群体训练(PBT)由DeepMind在2017年提出,其灵感来自进化算法:同时训练一群智能体,定期评估它们的表现,淘汰弱者并用强者的超参数和权重变异产生新个体。PBT不仅能发现好的策略,还能自动调优学习率、折扣因子等超参数,在AlphaStar的训练中发挥了关键作用——AlphaStar的联赛训练(League Training)正是PBT思想的大规模实践,通过维护主智能体(main agent)、联赛利用者(league exploiter)和主利用者(main exploiter)三类角色来避免策略的循环覆盖,确保最终策略能够击败策略空间中的绝大多数对手。至于LLM与RL的结合,这是一个极具前景但仍处于早期探索阶段的方向——例如「Voyager」项目展示了GPT-4可以为Minecraft中的智能体生成可执行的探索代码,而在Battle Royale这样的实时对抗环境中,LLM的推理延迟和上下文理解能力都将面临严峻考验。
对MARL研究基础设施的启发
从更宏观的角度看,Battle Royale 代表了多智能体强化学习研究基础设施的一种新趋势:将评估从封闭的实验室搬到开放的、持续运行的在线竞技场。这类平台的意义不仅在于降低参与门槛,更在于它能产生真实、动态的对抗数据——策略之间的相互适应、元博弈的演化、意外涌现的战术,这些都是静态基准无法捕捉的宝贵信息。
这一趋势实际上呼应了AI评估领域更广泛的范式转变。传统的AI基准测试(benchmark)——如Atari游戏、MuJoCo物理仿真等——提供了标准化的评估环境,但它们是静态的,容易被「刷榜」优化。Atari基准自2013年DeepMind发表DQN论文以来一直是深度RL的标准评估平台,但研究者们逐渐发现,在Atari上取得高分的算法并不一定具备真正的泛化能力——一些方法通过记忆特定的状态序列而非学习通用策略来「作弊」。MuJoCo环境同样面临类似问题:在固定的物理参数和任务设定下,算法可能过度拟合到特定的环境动力学。研究者们越来越意识到,真正衡量智能体能力的方式不是在固定测试集上取得高分,而是在开放的、不断变化的对手生态中持续保持竞争力。这与软件工程中从「单元测试」到「生产环境监控」的转变有异曲同工之妙。类似的平台级评估思路也出现在其他AI子领域:例如Chatbot Arena通过真人盲评来持续评估大语言模型的对话能力,其Elo排名已成为LLM领域的重要参考指标。Chatbot Arena由UC Berkeley的LMSYS团队创建,其核心机制是让用户同时与两个匿名的LLM对话,然后选择哪个回答更好,这种盲评方式有效避免了品牌偏见。截至2024年,Chatbot Arena已收集超过百万次人类投票,其排名被广泛视为LLM领域最可信的第三方评估之一。这种众包评估的理念——让社区参与者既是被评估者也是评估数据的贡献者——与Battle Royale的模式高度相似。
当然,作为一个个人开发者发起的项目,它的长期活跃度、评估的公平性以及防作弊机制等仍有待观察。在防作弊方面,由于参与者提交的是可执行代码,平台需要考虑代码安全性(沙箱隔离)、计算资源限制(防止提交占用过多CPU/内存的策略)、以及策略共谋(多个账号提交协同策略来互相「喂分」)等问题。沙箱隔离在技术上通常通过容器化技术(如Docker)或系统调用级别的安全限制(如seccomp)来实现,确保提交的代码无法访问主机系统或干扰其他智能体的运行。策略共谋则是一个更微妙的问题——在大逃杀场景中,如果两个智能体能够识别彼此(例如通过特定的行为暗号)并达成不攻击协议,它们可以联手消灭其他对手后再决斗,从而提高各自的平均排名。这类问题在博弈论中被称为「联盟博弈」(coalition game),在开放竞技平台中需要通过机制设计来加以防范,例如随机化对局配对、限制同一用户的提交数量等。但无论如何,这种「开放入场 + 托管评估 + Elo 天梯」的模式,为 MARL 的社区化研究提供了一个值得借鉴的样本。对于想快速验证多智能体强化学习想法、又不想在基础设施上耗费精力的研究者来说,这或许是一个不错的试验田。
核心要点
核心要点
相关推荐
用DeepSeek搭建AI智能体+个人知识库全流程指南
本文梳理基于DeepSeek R1模型搭建AI智能体与个人知识库的完整学习路径,涵盖智能体核心要素、私有知识库搭建、低阶与高阶实现方式及工作流编排,适合零基础入门者建立系统认知。
Harness驾驭工程实战:企业级多Agent智能体架构拆解
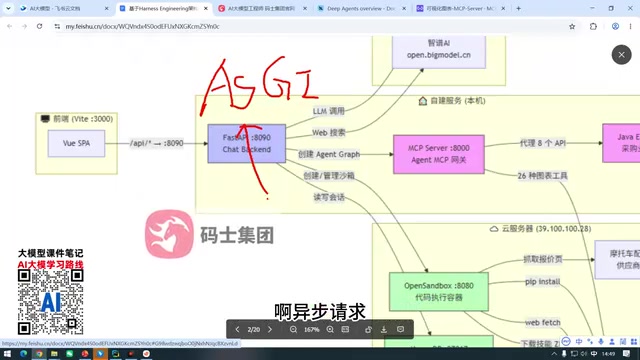
深入拆解基于Harness驾驭工程架构的企业级多Agent智能体项目:Vue前端、FastAPI/ASGI后端、DeepSeek多模型编排、MCP协议对接ERP、沙箱容器隔离等企业级落地方案全解析。
LangChain框架入门:从核心库到AI Agent开发全解析
LangChain是专为大模型应用开发设计的开源框架。本文详解LangChain Core、LangGraph、LangServe、LangSmith等核心库的分工,帮助开发者理解如何结合RAG与AI Agent搭建企业级智能应用。