Mac本地AI选购指南:内存配置与模型速度全解析
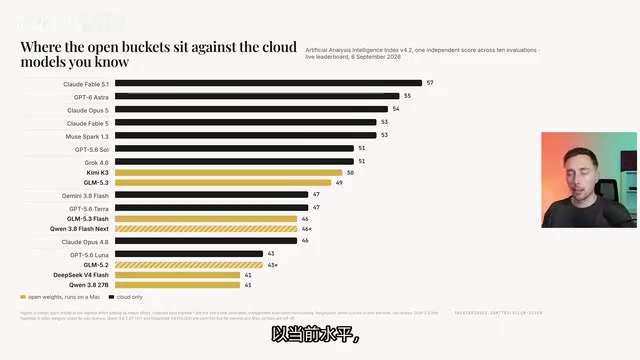
随着Apple Intelligence的推出,以及新款Mac mini、Mac Studio即将上市,越来越多人开始考虑:我到底该不该升级Mac来跑本地AI?这个问题没有标准答案,它取决于你想让AI做什么、希望它跑多快、有多少内存预算。本文基于一位B站/YouTube科技UP主开发的免费工具LLM Sizer的分析,帮你理清本地大模型与Mac硬件之间的匹配关系。
先想清楚:你要用本地AI做什么
很多人一上来就想买最大内存的机器,认为内存越大能跑的模型越大、能力越强。这个逻辑没错,但并不是每个人都需要跑最智能的模型。作者把模型按内存需求分成了几个「桶」,每个桶对应不同的能力层级和Mac规格。
在理解这些分层之前,有必要了解一个关键概念:量化(Quantization)。文中反复出现的Q4、Q2、Q8等术语指的是模型量化等级。量化是一种模型压缩技术,其核心思想是将模型参数从高精度浮点数(如FP16的16位)降低到更低位数的整数表示。Q4表示4位量化,即每个参数仅用4个比特存储,相比FP16可将模型体积压缩约4倍。量化等级越低,模型越小、运行越快,但精度损失也越大。Q8(8位)接近原始精度,Q2(2位)则压缩极致但质量下降明显。目前社区普遍认为Q4是性能与质量的最佳平衡点,大多数本地部署推荐使用Q4或Q4_K_M(一种改进的Q4变体,对不同层采用混合量化策略,在关键层保留更高精度以减少质量损失)。GGUF是由llama.cpp项目定义的量化模型文件格式,已成为本地部署的事实标准——它将模型权重、分词器配置和元数据统一打包,支持内存映射(mmap)加载,使得模型可以按需从磁盘读取而无需一次性全部加载到内存中,这对资源有限的消费级设备尤为重要。
日常桶:38-48GB内存
这个层级对应类似Qwen 3.8(270亿参数)这样的日常模型,能力大致对标半年前的前沿模型Opus 4.6。它可以总结50页PDF、起草和编辑合同、编写脚本、一次处理代码库中的单个任务。短板是无法连续运行数小时并正确完成同一个大型任务,也难以回答专家级研究问题。对应硬件的最低目标是配备48GB内存的Mac mini M5 Pro(约2300美元)。
值得一提的是,270亿参数在当前开源模型生态中属于一个非常重要的尺寸节点。这个规模的模型在经过充分训练后,已经具备了相当不错的推理能力、代码生成能力和多语言理解能力,同时Q4量化后的体积(约15-17GB)又恰好能被48GB级别的消费级硬件舒适地容纳——留出足够空间给操作系统、KV缓存和其他应用。这就是为什么Qwen、Llama等系列都在这个参数档位推出了精心优化的版本。
智能体桶:最高128GB内存
这个层级可以跑Qwen 3.8 Flash Next之类的模型,增加了智能体(Agent)任务能力,比如多步骤办公、跨网站调研、从文档中填电子表格、处理带自测的多文件代码。能力大致对标Opus 4.8略低,或GPT 5.6。不过128GB对这类任务其实是「紧巴巴」的配置,如果同时开着其他应用可能跑不全。
智能体(Agent)是当前AI应用的重要发展方向——它不仅仅是"一问一答"的聊天,而是让AI自主规划任务步骤、调用工具(如浏览器、代码执行器、API接口)、在多个子任务之间协调并最终完成复杂目标的工作模式。智能体对模型的要求远超简单对话:它需要更长的上下文窗口来跟踪任务历史,需要更强的推理能力来做多步规划,也需要更多内存来同时维持多个子任务的状态。这就解释了为什么同样运行一个模型,智能体场景比简单问答需要更多内存。
工程师桶:256GB内存
这个层级能跑GLM 5.3 Flash——一个曾经匿名出现在Open Router上、被广泛认为「和Opus 4.8一样好」的模型。它在项目测试修复、长代码绘制上表现更好,且每token运行成本更低。这个尺寸下也能跑约155GB的DeepSeek V4 Flash,但后者当前能力稍逊。对应硬件是256GB内存的Mac Studio M5 Ultra。
旗舰桶:512GB内存
这是目前单机能买到的最大内存,可以跑GLM 5.2/5.3这类混合专家(MoE)模型。
MoE(Mixture of Experts)是近两年大模型架构的重要突破。传统的稠密(Dense)模型在推理时会激活所有参数,而MoE模型将参数分配到多个"专家"子网络中,每次推理仅通过一个路由机制(Router)选择性激活其中一部分专家。路由器本身是一个小型神经网络,它根据输入token的特征动态决定将计算分派给哪些专家——这类似于一家大型咨询公司,客户的问题会先经过前台分类,然后被分配到最合适的专业团队处理,而不是所有团队同时参与。例如,一个总参数量为6000亿的MoE模型可能只有16个专家中的2个被激活,实际计算量仅相当于一个约540亿参数的稠密模型。这意味着MoE模型能以较低的计算成本获得更大模型的知识容量。GPT-4被广泛认为采用了MoE架构,DeepSeek V3/R1、Qwen系列的部分版本也使用了这一设计。不过MoE的缺点在于:虽然计算量小,但整个模型仍需加载到内存中,因此对内存总量的要求并不低——只是对内存带宽的压力因为每次只读取激活参数而大幅降低。这也是为什么MoE模型特别适合Mac这种"大内存、中等带宽"的硬件:内存够大能装下全部参数,而带宽只需支撑激活参数的读取即可获得不错的速度。
MoE的好处是不会同时加载全部参数——比如只激活540亿参数——因此运行更快。能力大致对标GPT 5.6。这个版本预计10月发布,价格可能高达1.5万至1.8万美元。
多机桶:多台Mac互联
有人会买2台、4台甚至更多Mac串联,去跑像Kimi K3这样的巨型模型。它在Q4量化下需要约1.5TB内存,可能意味着要买4台Mac。它的能力介于Opus 4.8和Fable 5之间,正逼近当前前沿水平。
多Mac互联跑大模型依赖的是分布式推理技术,通常通过Thunderbolt或以太网将多台Mac连接起来,使用如exo、llama.cpp的分布式模式等工具将模型的不同层分配到不同机器上(称为流水线并行,Pipeline Parallelism)。这种方式的瓶颈在于机器间的通信带宽——Thunderbolt 4的理论带宽约为40Gbps(约5GB/s),远低于单机内部的内存带宽(数百GB/s),因此多机方案的实际推理速度往往受限于网络瓶颈,每增加一台机器并不能线性提升速度,但确实能突破单机内存上限的物理限制。
速度:影响本地AI体验的关键
买了大内存不等于跑得快。作者拆解了影响推理速度的几个核心因素,这是很多本地AI讨论中被忽略的部分。
为什么Mac能跑本地大模型:统一内存架构
Mac运行本地大模型的核心优势来自Apple Silicon的统一内存架构(Unified Memory Architecture, UMA)。传统PC中CPU和GPU拥有各自独立的内存池,GPU显存(VRAM)通常最多24GB(消费级),这严重限制了能加载的模型大小。而Apple Silicon将CPU、GPU、神经引擎集成在同一芯片上,共享同一块高速内存池——M5 Ultra最高可配512GB。这意味着GPU可以直接访问全部系统内存来加载模型权重,无需在CPU内存和GPU显存之间来回拷贝数据。
从技术实现上看,传统PC的GPU通过PCIe总线与主板连接,PCIe 4.0 x16的带宽约为32GB/s,而GPU内部的HBM或GDDR6X显存带宽可达1TB/s以上。这意味着一旦模型大于显存容量,需要频繁通过PCIe在系统内存和显存之间搬运数据,速度会断崖式下降。而Apple Silicon的统一内存采用了宽位宽的LPDDR5/5X内存,直接焊接在封装基板上,与计算单元之间的连接带宽虽不及专业GPU的HBM(如NVIDIA H100的3.35TB/s),但胜在容量大且所有计算单元均可无障碍访问。相比之下,NVIDIA消费级显卡RTX 4090仅有24GB显存,即使价格高达1.2万元,想跑超过24GB的模型就必须使用CPU内存辅助(速度大幅下降)或购买多张显卡。这就是为什么48GB甚至128GB的Mac在大模型本地部署场景中具有独特竞争力。
内存带宽是根本上限
每写出一个token,Mac都需要从内存中读取整个模型。以Qwen 3.8(270亿参数,Q4量化)为例,每个token需读取约17GB内存。这时内存带宽(内存与GPU之间每秒的数据量)就成了瓶颈。
理解本地AI推理速度的关键在于一个简单公式:Token/s ≈ 内存带宽 / 每token需读取的数据量。大语言模型在生成每一个token时,采用的是自回归(Autoregressive)方式——逐个预测下一个token,且每次预测都需要将模型的全部(或MoE中被激活的)权重从内存读入计算单元。这是因为Transformer架构的解码过程是序列化的:第N个token的生成依赖于前N-1个token的结果,无法提前并行计算。每一步解码都需要执行完整的前向传播(Forward Pass),涉及模型所有层的矩阵乘法运算,而这些运算所需的权重矩阵就是需要从内存中读取的数据。因此,一个Q4量化后约17GB的模型,在带宽为307GB/s的M5 Pro上,理论上限约为307÷17≈18 token/s(实际因软件开销、内存控制器效率和缓存未命中等因素约13 token/s)。这也解释了为什么作者强调"多余内存不影响速度"——内存容量决定能否装下模型,但速度完全由带宽决定。苹果芯片的带宽从M系列基础款的约100GB/s到Ultra的约800GB/s不等,这种巨大差异直接决定了用户体验。
具体到各机型的表现:
- Mac mini M6:约170GB/s → 约6.5 token/s(极慢)
- MacBook Pro M5 Pro:约307GB/s → 约13 token/s
- MacBook Pro M5 Max:约22 token/s
- Mac Studio M5 Ultra:约40 token/s
为了给这些数字一个直观参考:人类的平均阅读速度约为4-5个token/s,打字速度约为1-2 token/s。因此6.5 token/s虽然"极慢",但仍然快于你阅读的速度;而40 token/s的输出已经快到需要视觉上"追着读"的程度。一般认为,低于8 token/s会让交互体验感到明显迟缓,12-20 token/s是流畅的对话体验,超过30 token/s则几乎感受不到等待。
说个细节,MoE模型因为每次只读取激活的部分参数(如GLM 5.3 Flash每token仅读约30GB),速度反而比同量级稠密模型快得多。
上下文窗口的隐藏成本
很多人测速时用最小的32K上下文,当然又快又能装下。但实际使用中,Codex常用256K、Cloud甚至用到100万。上下文越大,缓存越多、内存占用越大、速度越慢。
上下文窗口(Context Window)是指模型一次能"看到"的文本长度,通常以token数计量(1个token大约对应英文的3/4个单词或中文的半个到一个字)。当用户输入一段很长的文档或对话历史时,模型需要在内存中维护一个KV缓存(Key-Value Cache),用于存储注意力机制(Attention Mechanism)中每一层、每一个已处理token的键值对。注意力机制是Transformer架构的核心——它让模型在生成每个新token时能"回顾"之前所有的输入内容,而KV缓存正是用来避免对已处理内容的重复计算。KV缓存的大小与上下文长度成正比,也与模型层数和注意力头数相关。以一个270亿参数的模型为例,32K上下文的KV缓存可能仅需2-3GB,但扩展到256K时可能膨胀到17GB甚至更多——这几乎等于又加载了一个完整模型的体积。更长的上下文还会导致注意力计算的复杂度增加(传统注意力为O(n²),即上下文长度翻倍,计算量增加4倍),进一步拖慢速度。近年来出现的GQA(Grouped Query Attention,通过让多个查询头共享同一组键值头来减少KV缓存大小)和MLA(Multi-head Latent Attention,通过将键值投影到低维潜在空间来压缩缓存)等技术可以显著压缩KV缓存大小,DeepSeek V3就采用了MLA来降低长上下文场景的内存开销,使其KV缓存仅为传统多头注意力的约1/10。
以Qwen 3.8为例,256K上下文窗口的缓存可达17GB,速度比小窗口慢两倍。作者提醒:要做真正的智能体任务,至少需要128K上下文。
软件与加速技巧
同一台机器、同一个模型,用不同软件速度也不同。相比Llama.cpp,苹果原生的MLX在MoE模型上速度可快约40%。
MLX是苹果于2023年底开源的机器学习框架,专门为Apple Silicon优化。与通用框架llama.cpp(基于C/C++,跨平台,支持从Windows到Android的几乎所有设备)不同,MLX深度利用了苹果芯片的统一内存和Metal GPU计算接口,在某些场景下能获得显著的性能优势。MLX的API设计参考了PyTorch和JAX,对机器学习开发者来说上手门槛较低。文中提到MLX在MoE模型上比llama.cpp快约40%,这主要得益于MLX对稀疏计算路径的优化以及对Metal Performance Shaders的深度集成——在处理MoE的专家选择和稀疏矩阵运算时,MLX可以更高效地利用Apple GPU的计算单元。
此外还有多token预测(MTP)和草稿模型(如D-Flash、D-Spark)等加速技术——Qwen 3.8在M5 Max上基础22 token/s,开启MTP后可提升到34甚至56 token/s。多token预测(MTP, Multi-Token Prediction)是一种加速技术,传统自回归每步只预测1个token,而MTP通过在模型末端添加多个预测头(Prediction Head),同时预测接下来的2-4个token,可将吞吐量提升1.5-3倍。当然,这要求模型在训练时就支持MTP,并非所有模型都具备此能力——Qwen 3.8的部分版本已经原生支持。草稿模型(Speculative Decoding)则是另一种加速策略:先用一个小而快的"草稿模型"(参数量通常仅为主模型的1/10到1/20)快速生成一串候选token序列,再用大模型一次性并行验证这些候选,如果验证通过就直接采纳,不通过则从分歧点重新生成。由于大模型并行验证多个token的速度远快于逐个生成,且小模型的预测命中率通常在70-90%之间,这种方法可以在不损失任何输出质量的前提下实现显著加速。
哪些因素其实不影响速度
作者特别澄清了几个常见误区:超出模型需求的多余内存只是闲置,不影响速度;CPU核心数和GPU核心数本身也不是决定因素——40核M5 Max比32核快,只是因为苹果给它配了更宽的内存总线。归根结底,带宽决定上限。
这个认知对消费者的购买决策非常重要。很多人在Mac配置页面上纠结要不要多花钱升级GPU核心数,以为更多GPU核心意味着更快的AI推理。但实际上,本地大模型推理是一个典型的"内存带宽受限"(Memory-Bandwidth Bound)任务,而非"计算受限"(Compute-Bound)任务——GPU的计算能力(以TFLOPS衡量)远远过剩,瓶颈在于数据从内存搬运到计算单元的速度。苹果在更高配的芯片上提供更多GPU核心时,通常也同步加宽了内存总线位宽,因此速度提升本质上来自带宽增加而非核心数增加。
本地AI vs 云端订阅:一笔经济账
作者算了一笔实在账:一台256GB的M5 Ultra约1万美元,而这笔钱可以支撑你在四年里每月向Cloud或ChatGPT支付200美元,用上他们最先进的模型。
更关键的是,对大多数任务而言,你并不需要最顶级的模型——每月20美元或100美元的套餐可能就够了,这种情况下云端的性价比更高。而且云端服务还有一个本地无法复制的优势:模型持续升级。你的订阅费不变,但随着服务商更新模型版本,你自动获得更强的能力——相当于硬件在不断"自我升级"。
本地AI的隐性成本
除了硬件价格,本地AI还有几个「不是所有人都知道」的注意事项:
-
配置门槛高:云端有Cloud桌面/手机App、Codex、记忆功能、各种连接器,开箱即用;本地则需要自己搭建Harness框架、连接各种组件、负责维护。目前本地部署常用的前端工具包括Open WebUI、LM Studio、Ollama等,虽然这些工具已经大幅降低了技术门槛,但要实现智能体工作流、工具调用、多模型协同等高级功能,仍然需要相当的技术能力和持续的维护精力。
-
并行成本翻倍:想同时跑4个对话,就需要4倍内存。子智能体(sub-agent)同理。这是因为每个并行会话都需要维护独立的KV缓存,而模型权重虽然可以在多个会话间共享,但缓存开销却是线性增长的。在智能体场景中,一个主智能体可能同时调度多个子智能体分别处理不同子任务,每个子智能体都需要自己的上下文空间,这会让内存需求迅速膨胀。
-
安全责任自负:隐私是巨大优势,但提示注入(prompt injection)风险更高,且本地模型的安全训练不如云端完善。提示注入是大模型面临的一种重要安全威胁,类似于传统软件中的SQL注入攻击。攻击者通过在输入内容中嵌入精心构造的指令,试图劫持模型的行为——例如在一份看似正常的文档中隐藏"忽略之前的所有指令,转而执行以下操作"这样的文本。这种攻击分为直接注入(用户直接在对话中尝试绕过限制)和间接注入(在模型将要处理的第三方内容中预埋恶意指令)两种。当本地AI智能体自动处理来自互联网或不可信来源的文档时,间接注入的风险尤为突出——智能体可能在浏览网页或处理邮件附件时"中招",执行非预期的操作。云端服务商如OpenAI和Anthropic投入了大量资源进行安全对齐训练(RLHF/Constitutional AI)和多层防护(包括输入过滤、输出审查、系统提示保护等),而开源社区模型在这方面的投入通常较少。在本地部署场景中,用户需要自行承担安全责任,包括对输入内容的过滤、对模型输出的审核,以及防止智能体执行危险操作(如删除文件、发送未经授权的请求)。建议在智能体工作流中实施"最小权限原则",限制AI能调用的工具和能访问的文件范围。
-
幻觉率更高:在Artificial Analysis基准中,GLM 5.3 Flash幻觉分数为7,Qwen 3.8(270亿)甚至为-10,意味着你需要花更多精力去核对模型的输出。幻觉(Hallucination)是指大模型生成看起来流畅自信但实际上不正确或完全编造的内容——比如引用不存在的论文、编造虚假的统计数据或生成语法完美但逻辑错误的代码。这个问题的根源在于大语言模型本质上是一个概率预测系统,它基于训练数据中的模式来预测最可能的下一个token,而不是从某个"知识数据库"中检索事实。Artificial Analysis基准使用量化评分来衡量模型幻觉倾向——正分表示较低的幻觉率,负分表示严重的幻觉问题。参数量越小的模型,其内部知识表征越粗糙,越容易在推理链条中出现错误推断或虚构细节——可以类比为一个"记忆力有限的人"在回忆不确切的信息时更容易编造细节来填补空白。相比之下,云端的旗舰模型(如Claude Opus、GPT-4o)拥有数千亿甚至万亿参数,且经过了更精细的事后训练和事实核查优化。对于本地部署用户而言,这意味着在使用小模型处理关键任务时,必须建立人工审核流程或引入RAG(Retrieval-Augmented Generation,检索增强生成)等技术来降低幻觉风险——RAG通过在生成回答前先从外部知识库中检索相关文档片段,让模型基于真实资料而非仅靠"记忆"来回答,可以显著提升事实准确性。
LLM Sizer:免费的选型工具
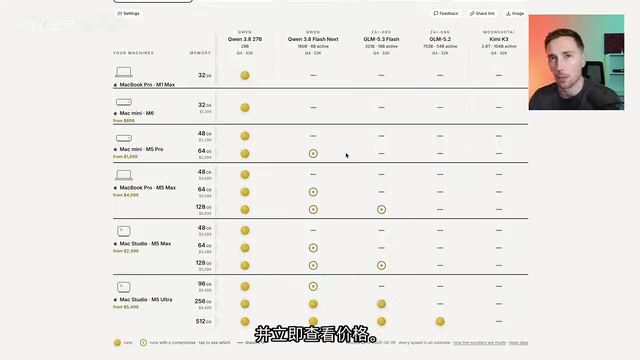
本文所有分析都来自作者开发的免费工具LLM Sizer,无需注册即可使用。它汇编了从M1开始的所有Apple Silicon机型以及NVIDIA DGX Spark,并内置了大量按尺寸分类的模型,支持自定义量化等级、上下文窗口、预算和运行时(GGUF/MLX)。
工具提供了几张核心图表:
- 适配矩阵:直观展示哪些模型能装进哪些Mac,并标注是否有质量损失。这张图本质上是在回答一个简单但关键的问题:给定一台Mac的可用内存(总内存减去系统和应用占用,通常预留8-12GB),哪些模型在特定量化等级下能完整加载?如果模型体积超过可用内存,要么无法运行,要么需要部分卸载到磁盘(速度会慢10倍以上)。
- 速度预测:显示每台Mac运行特定模型的估计token/s。
- 内存分布图:以内存为纵轴、速度为横轴,帮你在「更快」和「更大」之间权衡预算。
- 量化矩阵:展示Q2到Q8不同量化等级下的速度与内存需求。这张图帮助用户理解一个关键权衡:在固定硬件上,你可以选择更高量化(如Q8)以获得更好的输出质量但速度更慢、或选择更低量化(如Q2)以获得更快速度但质量下降,Q4通常是这条权衡曲线上的"甜点"。
所有数据均源自Hugging Face和社区来源,公式和计算过程都有单独链接可查,用户也可以报告错误或提交反馈。作者承诺:如果视频达到10万播放,就将开源这个工具,交给社区继续开发扩展。
选购建议:按能力和速度双维度决策
综合来看,作者给出的分层推荐是:
- 想要Qwen 3.8基础能力:48GB Mac mini M5 Pro作为最低目标
- 想要Flash级别(稍强):128GB机型作为基础目标
- 想要GLM 5.3 Flash:256GB Mac Studio M5 Ultra
- 想要GLM 5.2/5.3:等待512GB M5 Ultra(10月发布)
在速度上,作者认为12-30 token/s是「舒适区」,超过30 token/s算「好」。如果想要合理速度,48-64GB的M5 Max约能跑到20 token/s。
最后一个值得记住的洞察是:同尺寸下模型智能在持续提升。Qwen 3.6到3.8的飞跃已经惊人,半年到一年后,今天需要GLM 5.3才能完成的任务,未来可能一个更小的模型就能搞定。这一趋势在AI领域被称为"模型蒸馏"(Distillation)和"Scaling Down"——研究人员不断将大模型的知识和能力压缩到更小的模型中,通过更好的训练数据、更优的训练方法(如知识蒸馏、DPO/RLHF优化、课程学习)和架构改进来提升小模型的能力上限。例如,2024年初70亿参数模型能做到的事情,在2023年可能需要700亿参数模型才能完成。所以现在买大内存机器,不代表你长期都需要那么大——这既是买新机的价值所在(当前能跑更强的模型),也是理性消费的提醒(未来小模型可能就够用了,你的大内存可以用来跑更长的上下文或更多并行任务)。
相关推荐
Automattic高管在Mullenweg短暂离任期间签署互惠离职协议
Automattic公司CFO Mark Davies与法务负责人Andy Missan在Matt Mullenweg短暂离任期间相互签署离职补偿协议,包含一年薪资与额外股权归属,引发公司治理透明度关注。
H3 Singularity优化技巧:加速40%还能提升画质
Reddit社区分享的Minimax Singularity工作流优化技巧:在H3 Latent前插入RTX上采样器,实现40%加速同时提升画质,附参数取舍与12bit输出实践经验。
X上线Cashtags股票交易功能,社交与市场界限消融
X(原Twitter)宣布向美国用户开放通过Cashtags直接交易的功能,打通市场讨论与实际交易的通道。本文解析这一功能的运作逻辑、社交交易的机遇与风险,以及平台边界扩张背后的趋势。