27款模型代码写视频实测:Claude Opus 5.5登顶,性价比之王竟是它
27款模型用单文件HTML生成视频,头部模型审美领先但成本高百倍,中端模型性价比突出。
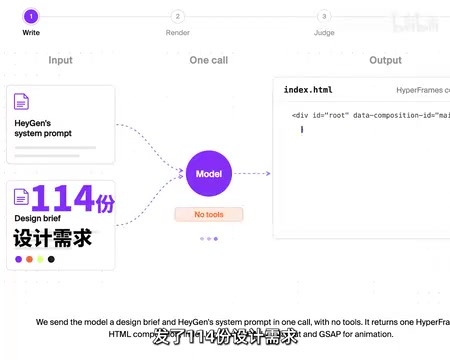
Artificial Analysis 的 Code2Video Benchmark 让全球27款主流模型在无外部工具、仅一次提交的约束下,各自编写单文件 HTML 制作视频,并由 Hyperframe 统一渲染。结果显示所有模型渲染成功率均超96%,代码能力已不再是区分点,差距转移到动画节奏、排版与视觉吸引力等审美维度。评分由 Gemini 4 Argon 在互动性、需求符合度、构图、时间一致性和制作技巧五个维度上两两对比完成。Claude Opus 5.5 以1536分居首,平均每题成本3.08美元;垫底的 Nimotron 3 Ultra 仅3美分,与第一名相差1232分。GPT 6.1 以约0.31美元排名第四,Mimo 以1美元排名第十,揭示了“审美上限”与“够用完成度”之间的成本分层。
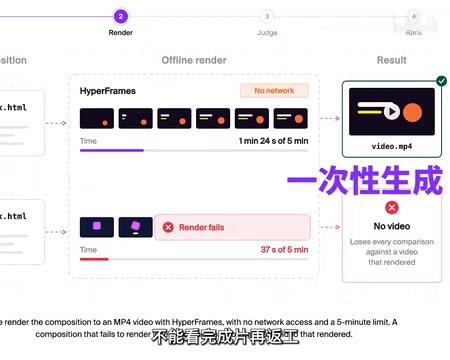
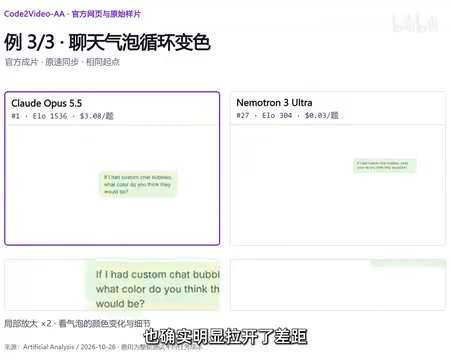
让AI用代码生成视频,成本能差出100倍——一个花3美元,一个只花3美分,成片质量究竟差多少?Artificial Analysis 发布的 Code2Video Benchmark 给出了一个相当有参考价值的答案:他们向全球主流27款模型发出114份设计需求,要求模型在不借助任何外部工具的前提下,独立编写一个HTML文件来制作视频,比如让聊天气泡循环变色,或者完成一段产品界面演示。模型负责布局与动画逻辑,再由 Hyperframe 渲染成片,且每道题只有一次提交机会,不能看成片后返工。
渲染成功率不再是门槛,审美才是
这轮测试的结果首先说明一件事:代码生成的基础能力已经不再是区分模型的主要维度。每款模型的渲染成功率都超过96%,代码基本都能跑起来。换句话说,真正的考验从"能不能做出来"转向了"做得好不好看"——动画的节奏感、视觉吸引力、排版细节,这些更接近设计审美的维度成了拉开差距的关键。这也意味着,当所有模型都能交付一个可运行的HTML文件时,评价体系的重心自然向成品质量迁移。
评分环节交给 Gemini 4 Argon,在互动性、需求符合度、构图、时间一致性和制作技巧五个维度上进行两两对比。这种成对比较的方式,比绝对打分更能反映模型之间的相对水平。
成对比较(pairwise comparison) 是一种常见的模型评测方法:评测者每次只看两个模型对同一需求产出的结果,判断哪一个更好,而不对所有结果做绝对打分。相比绝对打分,成对比较降低了评测者主观尺度漂移带来的噪声,也更适合比较风格差异明显、难以用统一量表衡量的生成内容。在 LLM 与生成式 AI 的基准测试中,成对比较的结果通常用 Bradley-Terry 模型或 Elo 评分体系聚合成全局排名,文章中的“总分1536”即是这种聚合后的相对分数,而非百分制得分。
排名格局:Opus 5.5领先,尾部差距悬殊
最终排名中,Claude Opus 5.5 以总分1536位列第一,平均任务成本3.08美元。而垫底的 Nimotron 3 Ultra 与第一名相差1232分,成本却低至3美分,与Opus形成约100倍的价格差。对比两者成片,质量差距确实肉眼可见——这也直接回应了开头那个问题:便宜确实有便宜的代价,在纯审美维度上,低价模型很难与头部模型抗衡。
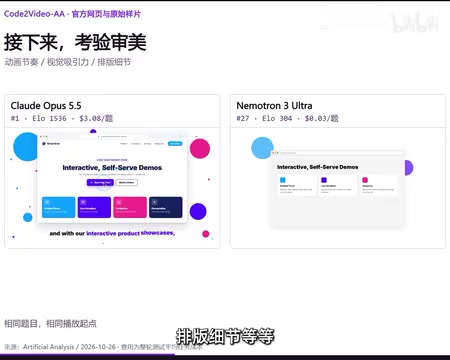
不过,头部模型的领先并非没有代价。Opus 5.5 每题3.08美元的成本,对于需要批量生成视频的场景来说并不便宜。
Hyperframe 在这类测试中承担的是“确定性渲染器”的角色:模型只输出 HTML/CSS/JavaScript 代码,由外部渲染引擎在固定视口、固定帧率下逐帧捕获并编码为视频。这样做的好处是把“代码生成质量”和“视频编码质量”解耦,避免不同模型因为调用不同的视频生成后端而产生不可比的结果。同时,渲染环节的标准化也保证了“一次提交、不能返工”的规则可以严格执行——评测方拿到的就是模型最终交付的代码,渲染结果即最终成绩。
性价比视角:GPT 6.1 与 Mimo 的另一种答案
如果换一个评价维度,结论会完全不同。GPT 6.1 总排名第四,平均每题只花0.31美元,大约是Opus的十分之一。而排名第十的 Mimo 总分1052,成本仅1美元,却远高于3美分的 Nimotron。这说明在"够用就好"的场景下,中端模型提供的性价比非常突出:花十分之一的钱拿到接近头部的排名,对成本敏感的团队来说可能是更务实的选择。
这种分层其实揭示了 Code2Video 这类任务的成本结构——高价模型买到的是审美上限,而中端模型买到的是可接受的完成度。选择哪个,取决于你的视频是要拿去做品牌级物料,还是快速验证想法。
单文件 HTML 约束看似只是工程细节,实际上对模型能力提出了几项隐性要求:模型必须把结构(HTML)、样式(CSS)和动画时序(JavaScript 或 CSS 动画)全部组织在一个文件内,不能依赖外部库、CDN 或素材资源;这意味着它要自行处理布局系统、动画循环、时间轴协调等通常由框架代劳的问题。约束越严格,越能暴露模型对前端渲染机制的理解深度,也使得不同模型之间的产出在同一渲染环境下具有可比性。
这个基准测试真正说明了什么
Code2Video Benchmark 的价值不止于一张排名表。它把"用代码写视频"拆解成可量化的工程问题:单文件HTML、一次提交、无外部工具,这几乎是最苛刻的约束条件,也因此最能暴露模型在布局理解和动画时序上的真实水平。
从结果看,模型间的竞争已经进入审美和成本的双重博弈阶段。排名靠前的模型在视觉质量上领先,但成本高出数量级;中端模型以极低成本提供可用的成片。对实际使用者而言,与其纠结谁第一,不如先明确自己的场景需要哪一种平衡。如果你的项目对视觉细节要求不高、但需要大量产出,低成本中端模型显然是更理性的起点;反之,追求品牌级视觉表现时,头部模型的溢价才有意义。
相关推荐

Cursor免费版8分钟建生产级应用,却败在同一个安全细节
Cursor免费版用8分12秒构建生产级Node+Postgres应用,22项API测试与界面检查全绿,比Copilot快6分钟,但默认密钥、无法撤销的JWT会话和登录无限流三个问题暴露了AI编程工具的安全盲区。
GoHighLevel对话AI接入MCP:智能体可调用40+外部应用
GoHighLevel 对话 AI 新增 MCP 支持,智能体可在对话中调用 40+ 外部应用完成预约、付款、表格写入等操作。了解功能限制、配置方法和上线时间。
物业管理软件为何必须拥抱AI与MCP协议
物业管理软件正转向开放生态。某系统已上线MCP服务器并筹备云端连接器,支持AI智能体接入与自定义工作流。本文分析MCP、开放API为何成为物业软件选型新标准。