27万星DeepSeek Harness拆解:从插件化Loop到自我演化野心
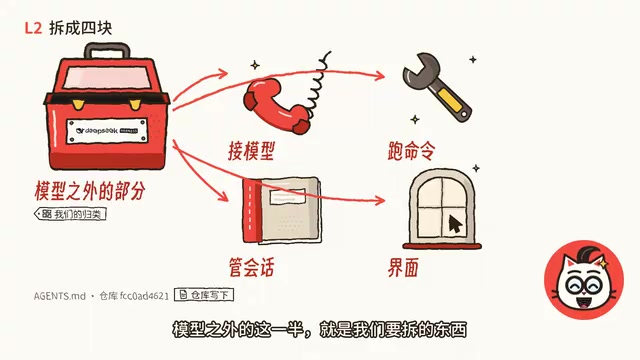
拆解DeepSeek Harness:模型之外那一半的设计、代价与自验证方法。
文章介绍了B站系列视频对DeepSeek Harness的拆解计划。Harness是模型之外负责读文件、跑命令、管会话、拼上下文与界面的开源Agent框架,其目标是让agent在运行时自我演化、编写新插件。系列用22集分六段路径,预告了六条线索:agent loop本身是插件、每个请求须能从会话日志重建、前缀缓存命中只是记账规矩的推论、官方API默认上传会话日志、大量提交疑似AI参与、42个NPM版本无一稳定却已谈Super Agent。系列以四档脚标标注证据等级,并强调可验证性本身就是设计目标,鼓励读者用命令和行号自行复现结论。
在B站,DeepSeek Harness的官方账号入驻视频播放量一度冲到约459万,弹幕里不少人叫它“大肥鱼”——肚子里装的不是模型,而是一整只工具箱。这个系列要做的,就是把这箱子一层层拆开:它为什么这样设计、代价是什么、你又该怎么自己验证。
Harness是什么:模型之外的“那一半”
仓库README开头写得很直白:DeepSeek广告 Harness是DeepSeek AI开发的开源Agent Harness。模型在服务器上负责思考,但读文件、跑命令、记住聊过什么,这些动作都需要别的东西替它完成——这个东西就是Harness。
往下拆一层,根目录的agents.md把代码按组列了出来:接模型的、跑命令的、管会话的、拼上下文的,还有界面。模型之外的那一半,就是这个系列要逐块拆解的对象。
值得留意的是它有一个更大的打算:让agent在运行时给自己写新零件。web里的“创造模式”就写着,让agent编写插件、添加新功能或界面。开头那支演示视频演的正是这个场景。这种设计有个名字,叫“自我演化的Harness”,README链接的那篇论文也拿它当动机之一。
Agent Harness 是智能体工程中的常见术语,指包裹在语言模型之外、负责把模型能力落到真实环境里的那一层运行时框架。一个典型的 Harness 至少承担四类职责:工具调用(把模型的意图翻译成读文件、执行命令、发网络请求等具体动作)、会话与状态管理(保存多轮对话、上下文窗口的拼接与裁剪)、错误处理与重试、以及对外暴露的界面或 API。它与模型本身解耦,因此同一个 Harness 可以挂不同的模型,同一个模型也能跑在不同的 Harness 上。业界常提的 Claude Code、OpenHands、SWE-agent 等都可视为同类产物。
理解这一点很关键:模型的“聪明”只是上限,Harness 决定了这个上限能被兑现多少。上下文如何组织、工具描述怎么写、失败后如何反馈给模型,都会显著影响最终任务成功率。所以拆解 Harness 并不是在看外围配件,而是在看决定实际表现的另一半系统。
拆之前先放六件:预告不展开的线索
正式开拆前,系列先摆了六件“翻到的东西”,分成三堆:插头一件、账本三件、怎么造往哪走两件。它们散在整季22集的四段路径上——全景三集、地基三集、内核四集、能力五集、插件与生态三集、方法两集、未来两集,每一段都拆到能用一句话说清为止。
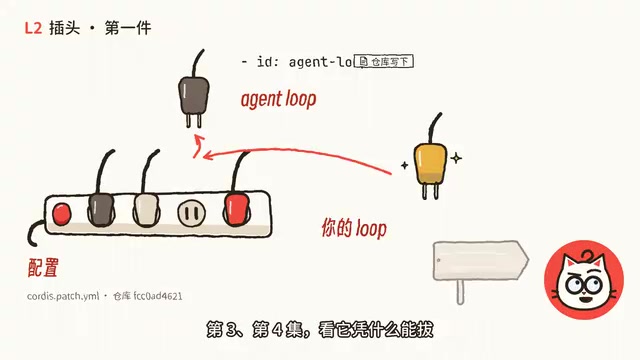
第一件,连agent loop本身都是插件。 在配置里它只是一个条目,可以拔掉换成你写的。第三、四集专门看它凭什么能拔。
第二件,每个发给模型的请求都必须能从会话日志里重建出来。 仓库把这写成硬规矩,第六集讲这本账。
第三件,前缀缓存能命中是这条记账规矩顺带的结果。 设计笔记写着它是“推论一号”,不是标题——因果方向别搞反了,第七集算这笔账。
第四件,用DeepSeek官方API时,会话日志默认跟着请求上传。 文档既写着默认开,也写着怎么关,第八集细讲。
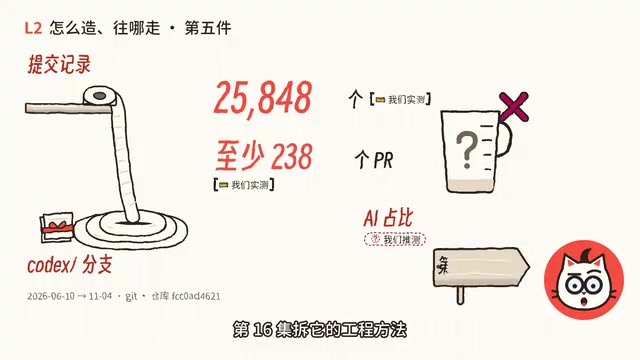
第五件,从6月10号到11月4号一共25848个提交,其中至少238个PR来自Codex开头的分支。 这些代码有多少是AI写的?Git给不出比例。第十六集拆它的工程方法。
第六件,NPM上42个版本没有一个是稳定版,官方10月31号却已经发文讲Super Agent,开头先声明它并非对现有产品功能的介绍。第十八、十九集讲这两件。
Agent loop(智能体循环)是 Harness 的心脏:它反复执行“把当前上下文发给模型 → 解析模型返回的工具调用 → 执行工具 → 把结果追加回上下文”这一循环,直到模型给出终止信号或触及步数、时间上限。循环本身不产生智能,但它决定了模型每一步能看到什么、能做什么、失败后能否自我纠正。
多数框架把 agent loop 写死在核心代码里,因为它是控制流的中枢,改动风险高。DeepSeek Harness 把它降格为配置中的一个条目,意味着循环的步数策略、终止条件乃至整体调度逻辑都可以替换。这既是“一切皆插件”理念最激进的体现,也带来了代价:插件边界、状态传递和调试复杂度都会上升。第三、四集要看的正是这种可拔插性在工程上如何成立。
前缀缓存(prefix caching) 是大模型推理侧的一项优化:当多次请求共享相同的开头 token 序列时,服务端可以复用这部分已计算的 KV 缓存,跳过重复的预填充,从而降低延迟与成本。它对 Agent 场景尤其重要,因为每一轮循环都会重发几乎相同的历史上下文,只有末尾新增了工具结果。
但前缀缓存能否命中,取决于请求的前缀是否逐字节稳定。如果 Harness 每轮都重新拼接上下文、改变系统提示或工具描述的顺序,缓存就会失效。DeepSeek Harness 把“每个请求都能从会话日志重建”立为硬规矩,客观上保证了上下文构造的确定性,缓存命中于是成为这条记账规矩的副产品,而非专门优化的目标。这个因果方向正是第七集要厘清的重点。
证据怎么挂:四档脚标与三张卡
这个系列的做法是把“证据等级”明码标出来。屏幕上的说法都挂脚标,分四档:官方名(官方账号、官方文章、API Docs和README里的自我介绍)、仓库写下(仓库里的文件以及Git原样打印的记录)、我们实测(在指定版本或日期上数出来、跑出来的)、我们推测(谁都没写、我们推出来的)。带“我们”的标签属于整理者自己的判断,视频简介和同行视频的原画都不算证据。
仓库里有一类设计记录叫Agent Note,每篇都必须写落选的替代方案——很多“被否决卡”的原画就出自这里。拆开看是三张卡、四档脚标、一类设计记录,每集最后留三张卡,第一张就是“被否决的方案”。比如第00集的特例卡,上面是出版架构文档立下的一条约束:23项MVP功能一项都不改。第二章讲代价——“一切皆插件”,Packages下面就有370个包。第三章讲你自己验证:在仓库根目录用Grab,在Base的配置文件里找Agent Loop,第530行起,整个Loop只是一个条目。
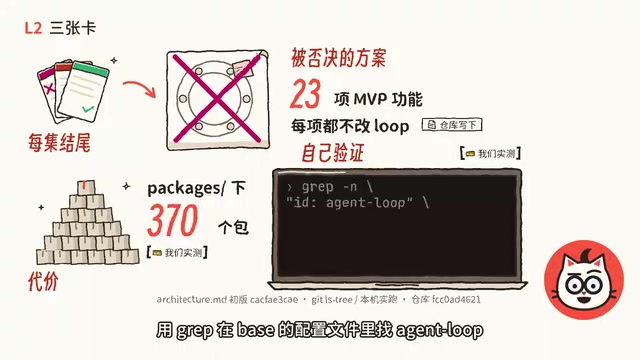
Agent Note 是仓库中一类轻量设计文档,通常用于记录某个模块或决策的背景、约束与被放弃的备选方案。要求每篇必须写明“落选的替代方案”,是一种把设计推理外化的做法:读者不仅能看到最终选择,还能看到当时被权衡掉的路径及其原因,避免后来者重复踩坑或误以为现有方案是唯一解。
这种记录方式与系列强调的“可验证性”互为支撑。被否决的方案往往正是观众最容易提出的疑问——“为什么不直接这样做?”Agent Note 提前给出了回答,而“被否决卡”则把这些内容提炼成可视化的原画。对想自行评估 Harness 设计质量的人来说,Agent Note 是比 README 更接近真实决策过程的一手材料。
为什么值得跟:可验证性本身就是设计目标
这套拆法的价值不在于把Harness讲得多神秘,而在于它把“你怎么自己验证”当成一等公民。一个连agent loop都能拔掉换掉、每个请求都能从日志重建、缓存命中只是记账副产品的系统,其设计约束是可以用命令和行号复现的。
系列反复念的那句话是:“没有什么复杂度是拆一层降不下来的,如果有,那就再拆一层。”下一集从那行命令开始上手——请勿模仿,但可以跟着拆。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。