29MB小模型Neural 3实测:端侧工具调用能否挑战大模型?
29MB的Neural 3用架构精简与语法约束,把自然语言直接转成可执行函数调用,跑在手表也够用。
Neural 3(Needle)是YC孵化的Cactus Compute推出的端侧函数调用专用模型,完整版仅29MB,最小可用版本约8MB,可在手机、手表乃至小型开发板上离线运行。其核心技术包括三点:以headband MLP替代Transformer前馈层大幅压缩参数量、将函数schema编译为字节级语法约束以保证输出始终可解析、以及「智能滑块」设计让单一文件按需截取4到20层适配不同算力。每次响应附带置信度分数,支持高置信直接执行、中置信人工确认、低置信兜底拒绝的三路分流。但宣传中的基准成绩均基于微调后模型,base模型仅是起点,开发者应视自身场景完成领域微调后再上线。
把「关掉门廊灯,顺便把烤箱调到400度」这样一句话,直接转成两个干净的函数调用——这就是Neural 3(又称Needle)要解决的问题。它不需要联网,能跑在手机、手表甚至一块小开发板上。完整版只有29MB,最小可用版本约8MB。这个由YC孵化的旧金山创业公司Cactus Compute推出的模型,在海外博主的测评中引发了「小模型吊打大模型」的热议。本文结合视频实测内容,拆解它的技术路线、真实表现与适用边界。
结构化输出:绕过JSON解析的赌注
Neural 3和同期发布的另一款模型Jav(来自TypeSafe AI)押注同一个判断:大多数软件决策根本不需要一整段文字,它们只需要一个选择——调用哪个函数、传入哪些参数。
传统语言模型逐token生成答案,你得从里面抠出JSON、做校验,有时因为它凭空捏造字段还得重试。而Neural这类模型跳过了全部流程,只产出结构化输出,代码可以直接执行。
实现这一点的核心是语法约束(grammar)。Neural会把你的函数schema编译成字节级语法,生成的每个token都必须符合该语法,所以JSON永远能解析成功。但这里要分清:结构合法不等于答案正确。如果你问了一个所有工具都处理不了的需求(比如「黄金价格」),它会返回空列表,而不是硬编一个答案。
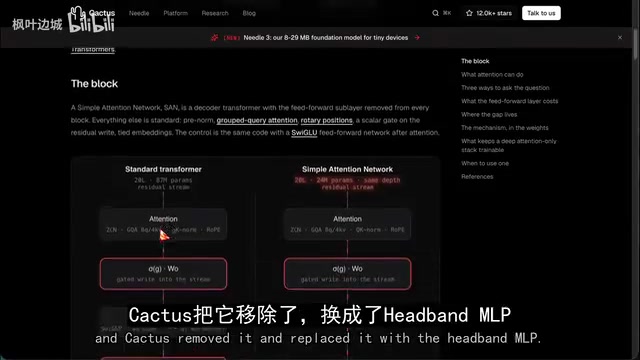
架构上,Cactus称之为「简单注意力网络」。传统Transformer里前馈层占据大部分参数,Cactus把它移除,换成headband MLP——每层仅约2.56万参数,而非470万。大部分知识改为存放在engram表中,通过哈希查找2到3个词的短片段。7080万到1.21亿的参数都坐落在这些表里,模型读取记录而非做乘法运算。结果是1.21亿参数的完整模型,实际计算量约等于一个5000万参数模型。
语法约束(grammar-constrained decoding)是一种在推理阶段强制模型输出符合特定形式的技术。其原理是将目标格式(如JSON schema)预先编译成一套有限状态机或上下文无关文法,在每一步token采样前,引擎会屏蔽掉所有当前状态下不合法的token,只允许模型从合法候选中采样。这意味着模型根本无法「写出」不符合schema的内容——括号不会不匹配,字段名不会凭空出现,枚举值不会越界。这种方法最早由llama.cpp等开源推理框架普及,后来被Outlines、Guidance等库系统化。Neural 3的做法是把schema编译到字节级别,粒度比词元更细,进一步压缩了不合法路径的搜索空间。代价是:每换一套schema,都需要重新编译语法,且对于嵌套复杂的schema,约束计算本身会带来额外延迟。
智能滑块:一个文件适配手表到笔记本
Neural 3最有意思的设计叫「智能滑块」(intelligence slider)。模型共有20层,深度2到4都能作为独立模型运行。你下载一个文件,就能切出4层版本给智能手表,或保留全部20层给笔记本。4层版本有2900万参数,每多加一层大约多消耗1MB内存。
训练技巧并不复杂:约80%的训练步骤正常训练完整模型,另外20%随机选取一个深度,只跑那些层,并让小版本去模仿完整模型的预测。第0层和第19层始终保留,中间层通过每次切分最大间隙来填充。
令人意外的是,完整模型反而因此变得更好——在他们的测试中,比不用这套「梯子式训练」的同款模型最终验证损失低了3.9。此外29MB的文件之所以这么小,是因为权重被压缩到了约每个2比特。在小开发板上,他们报告解码速度约为每秒400到4000个token。
这种训练策略在学术上与「早退网络」(Early Exit Networks)和「任意深度网络」(Any-Depth Networks)思路相近。核心思想是让网络的中间层也具备独立完成任务的能力,而不只是作为最终层的中间过渡。Cactus所用的「让小版本模仿完整模型预测」属于在线知识蒸馏的变体:完整模型同时充当教师,中间截断的子模型充当学生,两者在同一次前向传播中协同训练。这与Microsoft的矩阵化网络(Matryoshka Representation Learning)及Google的一系列弹性推理工作共享同一直觉:一个模型文件内嵌多个能力梯度,部署时按资源预算动态选取截断点,无需维护多套独立权重。完整模型性能因此提升的原因在于:中间层被迫具备更强的信息保留能力,相当于对每一层施加了额外的监督信号。
置信度与三路分流:产品化的关键
每个响应都带有一个由独立校准头给出的置信度分数。引擎默认有0.5的下限,低于此值的调用会被移进一个叫suppressed calls的字段,主调用列表返回空。
Neural给出的路由模式很实用:置信度≥0.7直接执行;处于中间区间就把调用展示给用户、请其确认;什么都没返回就回复「我做不了这个」。这个三路分流(three-way split)堪称整个方案中最有价值的部分——它把模型的不确定性显式交还给了产品逻辑。
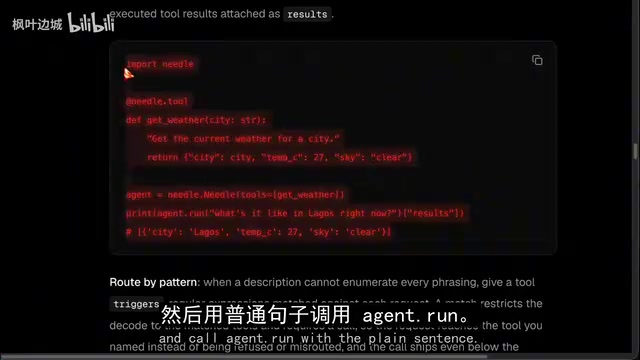
上手只需一次安装:pip install cactus-needle,推理引擎从Hugging Face下载一次并缓存。给函数加上@needle.tool装饰器后,类型提示自动成为参数类型,文档字符串成为工具描述。把工具传入Needle类,用一句自然语言调用agent.run,它会挑选函数、填充参数、执行你的代码并返回结果。如果只想拿JSON不执行,agent.complete会返回函数名、参数、一行简短推理、置信度分数,甚至峰值内存占用。
抽取(extraction)同理:定义带字段的模型,传入文本,调用needle.extract。一封物流邮件进去,承运商、运单号、送达日期作为类型化对象出来。关键在于——它填充的每个字段都是从原文复制的span,所以是「有据可依」的;但如果值没在文本里明确写出,模型就产不出来。信息分散的邮件会比干净的发票难处理得多。
基准成绩需要上下文
标题党式的宣传是「Needle 3在移动端工具调用上击败10倍于它的模型」。但看梯子训练帖里的开箱base分数:4层模型在mobile action上只有11.7分,droid call上21分;完整20层分别是86和47。
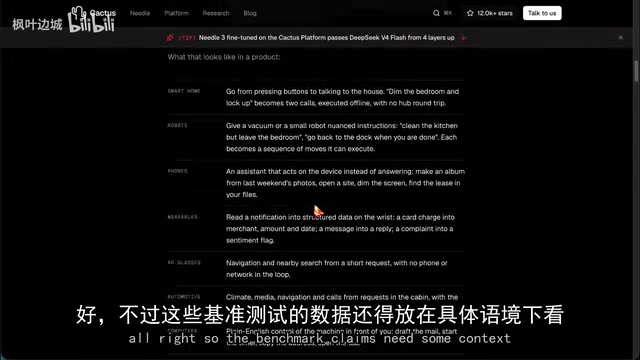
微调能把各个深度提升18到36分,连2层模型都能从基本不可用提升到56.5。但要注意droid call只有200行数据。有开发者自己跑测试只得到了32.2%。Cactus官方回应称Needle是任务专用的,上生产前应当先微调。换句话说,base模型是起点,不是成品助手。
微调本身很轻量:数据放进JSONL文件,每行包含query、工具调用和预期答案,无关样本给空答案列表。跑needle fine-tune,默认10个epoch,在冻结的base上训练一个LoRA适配器。如果没有数据,还有生成数据的命令通过OpenRouter造样本——默认用的正是deepseek广告 v4 flash,颇具反讽意味,因为那正是他们声称微调后要超越的模型。
微调完成后合并适配器,为任意深度和平台导出.cat文件。每个平台都有不到1MB的预编译引擎,覆盖macOS、Windows、Linux、Android、iOS、watchOS,甚至通过WebAssembly支持浏览器。一次微调,就能把8层版发到树莓派、把完整版发到桌面。
两种路线:Needle的「小」与Jav的「并行」
Jav(TypeSafe AI出品,创始人Diego Almeida,名字取自卡尼曼「系统1」的快速直觉思维)走的是完全相反的路线。它根本不逐字生成,而是一次并行pass产出整个结构化答案,响应时间70到500毫秒。他们的Doom演示里,Jav每秒约读取10次游戏状态,成本约每小时7美元,输入每百万token 4.2美分、输出免费。
TypeSafe声称Jav「不会幻觉」。但The Register指出,这实际只意味着它产不出非法结构,它仍可能选错选项。也有工程师认为,它的速度很大程度来自推理策略——用常规模型预填充并限制为单一常量token也能得到类似效果。
两者解决的是不同问题。Jav是大型云端模型,能处理更难的决策和海量选项(比如从上千个链接里选对一个);Needle仍是在语法约束下逐token解码,它的速度来自「体积小」,而非并行解码。Needle采用Apache 2.0开源,按次调用零成本,数据永不离开设备。Jav给的是各选项的概率,Needle给的是对调用的置信度分数。
实践中两者可以组合:Needle在手表上处理「切歌」这类命令,Jav在后端承担真正需要智能的路由决策。如果你的公司正在为「把简单命令转成函数调用」这种高频任务付前沿API的钱,这正是这两款模型瞄准的成本。
Jav所采用的「一次并行pass产出结构化答案」在机制上接近于「非自回归生成」(Non-Autoregressive Generation,NAR)。传统自回归模型逐token串行生成,每个token依赖前一个;非自回归模型则尝试在一次前向传播中并行预测所有输出位置。这种方式在机器翻译领域已有大量研究(如BERT系列的掩码预测),但在开放域生成中因为输出长度不固定、token间依赖复杂而难以推广。当输出被约束为结构化的有限选项集合时,并行解码的可行性大幅提升——因为每个字段的候选空间已知且有限,模型只需为每个槽位独立打分。这正是Jav在「选哪个选项」这类任务上能做到70-500ms响应的根本原因,而非仅仅是推理策略的差异。但其代价是无法处理需要前后token相互依赖的开放式推理场景。
适用边界:别被头条数字骗了
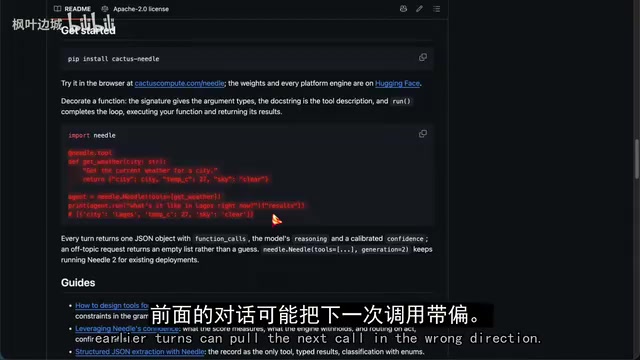
除了需要微调,Needle还有几处头条数字看不到的弱点。playground会保留对话状态,连续请求延续同一会话——如果你连发不相关命令(先调温控器、再问一个无关问题),早先的轮次可能把下一个调用带偏,独立请求之间需要reset。
工具设计是准确率的主要来源:一个动作一个工具、按用户实际说法命名、给每个必填参数留默认值。若必填参数既无默认值、句子里也没提及,Needle会扣住调用而非瞎猜——这更安全,但如果你没预期到,看起来就像失败。此外还有trigger选项(接受正则表达式),匹配到就强制调用对应工具,让描述里列不出的说法也能命中正确函数。工具列表要尽量精简,因为每多一个工具就多给模型一个选错的机会。
对想把端侧AI落地的团队来说,Neural 3代表了一条务实的路径:接受它只是「起点」,用自己的窄领域工具和微调把它养成趁手的助手,再用置信度兜住边界。它不是大模型的替代品,而是在合适场景下用29MB换来的本地化、零成本与隐私保障。
相关推荐

Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。