31B视频音频扩散模型压缩至14B:6步INT8推理

团队将视频音频联合扩散模型从31B压缩至14B、6步采样、INT8量化,大幅降低部署门槛。
在Hacker News的Show HN板块,一个团队展示了视频与音频联合扩散模型的压缩成果:参数量从31B降至14B,推理步数压缩到6步,并采用INT8量化。这同时应对了扩散模型在视频生成中的两大痛点——模型体积过大与推理步数过多。参数量减半直接降低显存占用和加载成本;6步采样大幅减少迭代去噪延迟;INT8量化进一步降低显存带宽和计算开销,但对音频模态的量化误差控制是难点。压缩后模型更易部署在单卡或边缘设备,降低批量生成视频的经济成本。不过原帖未披露具体压缩方法、质量对比和基准数据,6步INT8下的生成质量是否与原始模型可比尚待验证。
从31B到14B:扩散模型压缩的工程突破
在Hacker News的Show HN板块,一个团队展示了他们对视频与音频联合扩散模型的压缩成果:将参数量从31B降至14B,同时把推理步数压缩到6步,并采用INT8量化。这一进展直接回应了扩散模型在视频生成领域的两大痛点——模型体积过大与推理步数过多。
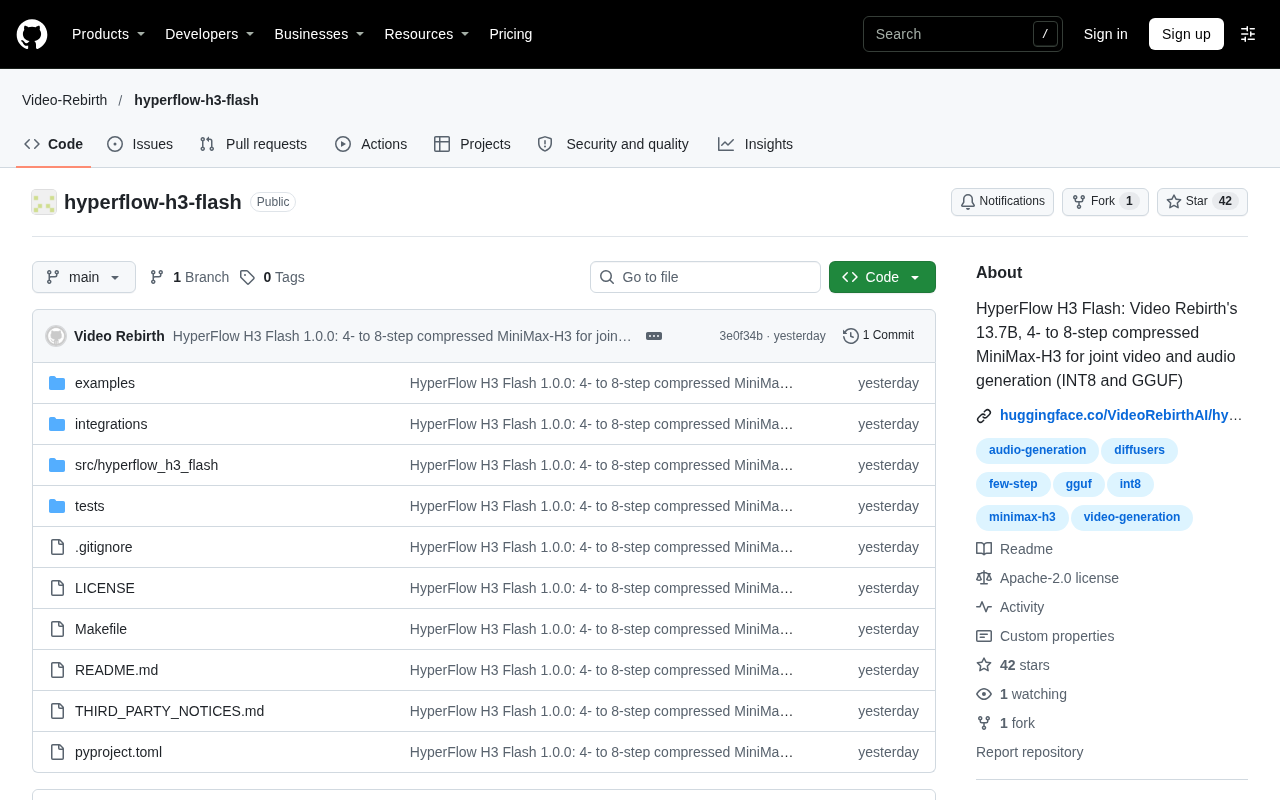
据该团队在Hacker News上的描述,他们把原本31B的模型压缩到了14B,并且只需要6步就能完成采样,模型以INT8精度运行。这意味着模型体积减少了超过一半,而推理步数远低于传统扩散模型通常需要的几十步甚至上百步。对于视频+音频联合生成这类计算密集的任务,这种压缩幅度在工程上相当可观。
压缩的三个维度:参数、步数与量化
这次压缩同时从三个维度入手,每一项都对应着不同的技术挑战。
参数量减半:从31B到14B
将31B参数压缩到14B,降幅超过一半。通常这类压缩会采用剪枝、知识蒸馏或低秩分解等手段,但原帖没有披露具体方法。可以确定的是,参数减少直接降低了显存占用和加载成本,让模型更有可能在消费级或单卡工作站上运行。
知识蒸馏是一种模型压缩技术,通过让小型“学生模型”模仿大型“教师模型”的输出分布或中间特征来传递知识。在扩散模型中,蒸馏常用于将多步采样过程压缩为少步,例如渐进式蒸馏让模型学会用更少的步数复现教师模型的去噪轨迹。剪枝则通过移除冗余的权重或结构(如注意力头、通道)来减少参数量,可分为非结构化剪枝(稀疏化)和结构化剪枝(直接删除整个神经元或层)。低秩分解将大权重矩阵近似为两个小矩阵的乘积,从而降低存储和计算量。这三种方法各有优劣:蒸馏能保持较好性能但需要教师模型和训练成本;剪枝可能破坏模型结构;低秩分解对硬件友好但压缩率有限。实际压缩中常组合使用。
步数压缩:6步采样
扩散模型的核心成本之一在于迭代去噪的步数。传统文生视频模型往往需要几十步采样,而6步意味着推理延迟大幅下降。步数压缩通常依赖蒸馏或更高效的采样器设计,与参数压缩叠加后,对实际吞吐的提升是乘数级的。
扩散模型的采样过程本质上是求解一个随机微分方程或常微分方程(ODE)。传统采样器(如DDPM)需要数百步来近似这个连续过程,而高阶ODE求解器(如DPM-Solver、Heun求解器)通过更精确的数值积分,能在20-50步内达到相近质量。蒸馏方法则训练一个学生模型直接预测多步后的结果,例如一致性模型(Consistency Models)将任意时间步的噪声直接映射到干净数据,实现1-4步采样;渐进式蒸馏则逐步将步数减半。6步采样通常结合了蒸馏与高效求解器,但步数越少,对模型容量和训练数据的要求越高,且可能损失多样性。音频模态对高频细节敏感,步数压缩的难度更大。
INT8量化:精度与效率的权衡
INT8量化把权重和激活从更高精度压缩到8位整数,进一步降低显存带宽压力和计算开销。视频+音频双模态模型对量化误差尤为敏感,因为音频对细微噪声的容忍度低于图像。该团队声称在INT8下仍能保持可用质量,这是此次发布中最值得关注的技术点之一。
INT8量化将浮点权重和激活值线性映射到8位整数(范围-128到127),并在推理时用整数运算替代浮点运算,可显著提升吞吐并降低显存占用。常见方案包括训练后量化(PTQ)和量化感知训练(QAT):PTQ直接对训练好的模型做校准,简单但可能损失精度;QAT在训练中模拟量化误差,精度更高但成本大。对于扩散模型,激活值动态范围大且随时间步变化,量化误差会累积到生成结果中。音频对量化噪声尤为敏感,因为人耳对细微失真非常敏锐。团队声称INT8下保持可用质量,可能采用了逐通道量化、混合精度(对敏感层保留FP16)或QAT等技术,但原帖未披露细节。
对视频生成领域的实际意义
视频与音频联合扩散模型是生成式AI中资源消耗最大的方向之一。一个31B模型即便在高端多卡环境里训练和推理都相当昂贵,而14B、6步、INT8的组合把门槛拉低了一个档次。
这种压缩路线对落地场景的推动很直接:更小的模型更容易部署在边缘设备或单卡服务器上,更少的步数意味着更低的单次生成成本和更短的等待时间。对于需要批量生成视频内容的管线,推理成本的下降会直接改变经济性。
不过也需要保持谨慎。Hacker News帖子本身信息量有限,团队没有公开具体的质量对比数据、压缩方法细节或基准测试结果。6步INT8下的生成质量是否与原始31B模型可比,目前只能依赖团队的声明。社区评论仅有3条,尚未形成充分的技术讨论。
一个值得追踪的方向
把大模型压缩到更小、更快、更低精度,同时维持生成质量,是扩散模型走向实用化的必经之路。这次Show HN展示的31B→14B、6步、INT8组合,给出了一条清晰的工程路径。后续值得关注的是团队是否会放出权重、推理代码和与原始模型的定量对比——那才是判断这次压缩真实含金量的关键。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today