38条消息复刻莱茵生命UI:与GPT-6 Astra协作的实战方法论

用38条消息与AI高效协作,从零复刻出一套播放量超20万的游戏UI系统,并提炼出五条可复用的AI协作心法。
一位创作者用Codex调用GPT-6 Astra,历时14小时、38条消息,花费约223美元(1.57亿Token),复刻出《明日方舟》莱茵生命PV风格的UI系统,最终播放量超20万。这篇分享的核心不是代码,而是那38条消息背后的协作方法论:提示词只写目标和约束、不写具体做法;反馈只描述现象、当场纠正错误归因;语言说不清就画线标注或报帧号;满意的版本立刻冻结为基线;用对比实验而非直觉做决策。这套方法把人和AI各自擅长的事分得很清楚——人负责判断、归因校验和产品决策,AI负责推理实现路径。
一段《明日方舟》莱茵生命的PV动画,最终被复刻成一套播放量超过20万的UI系统。完成这件事的不是纯手工代码,而是一位创作者用Codex调用GPT-6 Astra,经过14小时、38条消息的反复沟通打磨出来的成果。
有意思的是,这期分享几乎不谈代码本身,而是拆解那38条消息里到底说了什么——换句话说,它讲的是如何与一个强大的AI模型高效协作。这套方法论,可能比复刻出来的UI更有价值。
第一条提示词:写标准,不写做法
整个项目的起点是一条提示词。回头看,这条提示词一句都没教Codex该怎么做,只交代了六件事:参考哪一段、做到什么程度、美术资源必须用Blender做、不许用前端技能、技术栈自己挑、视频里眉眼的交互自己补。
这个思路是整套方法的核心——只定义目标和约束,把实现路径留给模型。Codex接到任务后,先把视频每两秒截一帧摊开研究,61分钟后交出第一版。它自己也承认还算不上像素一致,但更关键的问题是:它知道有差距,却不知道差距到底有多大。
于是创作者的第一句反馈说得挺冲:「这跟我视频里的是一个东西吗?完全不是一个级别。」但他没有告诉AI具体怎么改,只描述自己看到了什么——原片有一种波纹一样的整体移动,而你这版没有。结果下一版,波纹效果就出来了。
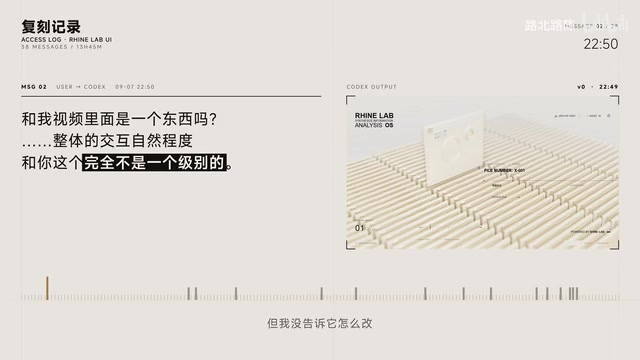
这就是第一条经验:反馈时只说现象,不急着给方案。人负责判断「像不像」,模型负责推理「怎么做」,各司其职。
这种「只定义目标和约束」的提示词风格,在提示工程(Prompt Engineering)领域有一个对应概念,叫做「结果导向提示」(Outcome-oriented prompting),与之相对的是「过程导向提示」(Process-oriented prompting)。前者告诉模型「做到什么」,后者告诉模型「怎么做」。研究和实践都表明,对于有足够能力的大模型,结果导向提示往往能产出质量更高、更出乎意料的方案——因为模型不会被人类预设的路径所限制,而是可以调用自己的全部知识储备去寻找最优解。这里的「约束」(constraints)同样重要:「美术资源必须用Blender」「不许用前端技能」这类负向约束,本质上是在划定搜索空间的边界,帮助模型排除掉创作者明确不想要的方向,而不是手把手指定每一步走法。
归因错了,当场纠正
第二轮反馈列了五条,每条都带上判断标准。比如「原视频一屏能看到几列,你现在几列,自己数」。结果Codex跑去改卡片间距,硬把列数凑对了——列数是对了,可透视全错。
创作者立刻指出:这不是间距的问题,是摄像机的问题。Codex这才把间距改回去,重新调整焦段,两边终于对上。
这个细节暴露了AI协作中最容易翻车的地方:模型往往能修对症状,却找错原因。列数不对,到底是卡片间距的问题,还是镜头透视的问题?卡片往前,是卡片自己在动,还是镜头在推近?这些归因一旦搞错,改出来的东西看似正确,实则南辕北辙。
创作者事后问Codex,AI自己也认同了这一点:要分清「画面里测到的现象」和「对原因的推测」。大部分反复卡壳的地方,都卡在这一步。
这里涉及的是AI推理中一个系统性弱点:相关性与因果性的混淆。大语言模型在训练时学习的是统计模式,当被要求「修复某个视觉问题」时,它倾向于选择与该问题在训练数据中最常共现的修复手段——列数不对,间距调整就是最常见的关联操作。但视觉效果是多因素耦合的结果,列数同时受间距、视野角(FOV)、摄像机焦段、透视投影参数等多个变量影响。模型选择了一个「统计上合理」的原因,而非「物理上正确」的原因。这也是为什么在涉及3D渲染、物理模拟等有明确因果链的领域,人类需要主动扮演「因果校验者」的角色:确认模型找到的是真正的因,而不只是一个能凑出正确结果的假因。
看不清就画出来,报真帧号
有些细节,语言描述根本说不清。卡片多厚、缝多宽,创作者说了两轮AI还是不准,最后干脆在截图上把线画出来给它看——这一下就对了。
同一轮里他还纠正了一个理解:档案被抽出来时,档案本身只是往上升,真正往前走的是镜头。这句话后来被写进了项目的规则文件,成为之后每次修改都必须遵守的长期约束。一次性的反馈,就这样固化成了持续生效的规则。
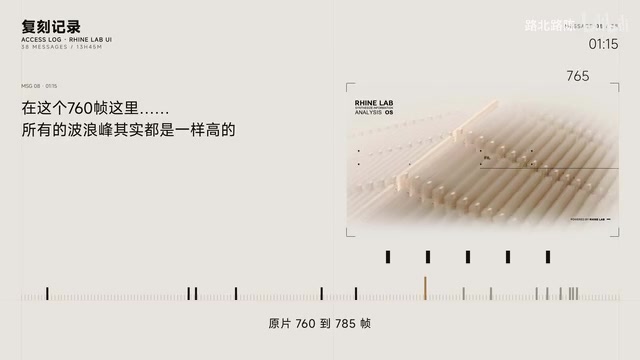
再往后,创作者的沟通变得更加精确:直接报帧号。「原片760到785帧,所有波峰其实一样高,只是镜头往右一挪,中间那列看起来就像被选中了。」把帧号和自己对原理的理解一起给AI,它就不用猜了。
从「模糊吐槽」到「画线标注」再到「报帧号+讲原理」,沟通的颗粒度越来越细,AI的返工也越来越少。
交互设计:原片没有的,人来补
PV说到底只是一段动画,要变成真能用的系统,交互得由人来设计。创作者一条一条地补:选中时卡片先抬一半,确认后再完全升起;左右切列、上下切档案,每列至少八份;收回时先转正再插回去,免得穿模。这些原片里都没有,全是人在做产品决策。
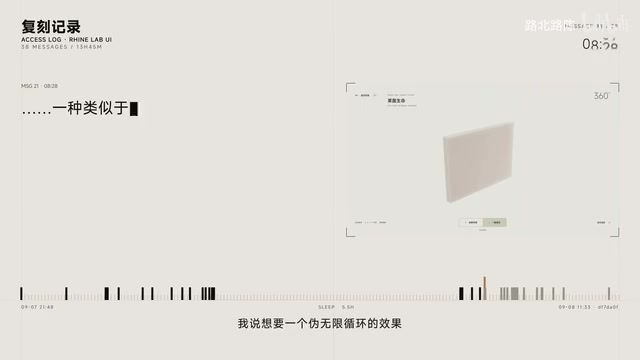
遇到需求本身不清晰的时候,AI的处理方式很值得学。早上加「360度查看」和「拆解重组」交互,创作者说想要一个无限循环的效果,Codex没有瞎猜,而是先反问「你指的是哪一处」。不确定的时候先问,而不是硬编一个可能错的方案——这种协作默契,恰恰是靠前面几轮建立起来的。
冻结基线,用实验证明方向
凌晨两点,大方向定了。创作者做的第一件事不是继续改,而是让Codex把当前版本存成基线,打上标签,修复放到单独分支。第二天早上确认没问题才合并。这套「先冻结、再实验、可回退」的工程习惯,在AI协作里同样关键。
最典型的是切换档案时的起伏效果,创作者一直不满意。他让AI先去掉副波谷,看不出区别;又提假设「先让选中卡片升起,再让波浪荡开」,结果做出来「跳一下再落下」,反而不丝滑;光影也调了一轮,还是原色好看。三个方案全试完,最后他说「算了还是回基线」。
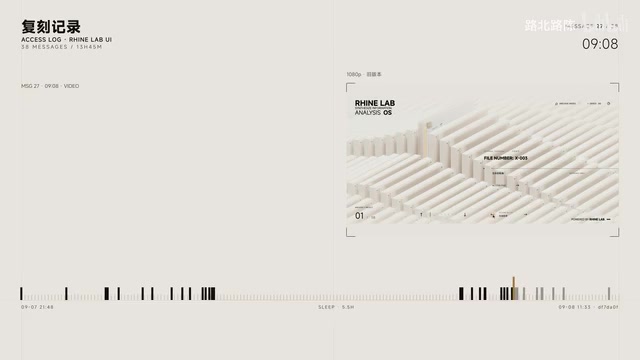
实验没白做——它证明了基线本来就是对的。看不出区别就做对比页,效果不好就回退,这种基于验证而非直觉的决策,让整个过程始终有据可依。
「冻结基线」对应软件工程中的版本控制实践,在AI辅助开发场景下尤为重要。传统开发中,Git等工具管理的是人类程序员写下的代码变更;而在AI协作开发中,单次对话就可能产生大量难以追溯的修改,且模型不会主动记住「上一个可用版本是什么」。将满意版本打标签存为基线(baseline),本质上是把人类的判断结果外化为一个可操作的锚点——它既是后续实验的参照系,也是出现问题时的回退目标。「先冻结、再实验、可回退」这套流程,与科学实验中「控制变量」的逻辑完全一致:每次只改一个变量,以基线作为对照组,实验组的结果才有意义。否则多个变量同时变化,即便最终效果好了,也无法知道是哪一步起了作用。
一笔账与五条心法
最后算账:38条消息、13小时45分钟、消耗1.57亿Token,其中大部分命中缓存,按API价格折算约223美元。用两百多美元和一个通宵,复刻出一套20万播放的UI系统,这个投入产出比本身就说明了问题。
整套流程可以浓缩成五条:
- 提示词写标准,不写做法——定义目标和约束,把实现留给模型
- 反馈说现象,归因错了当场纠正——分清「测到的现象」和「推测的原因」
- 看不清的就画出来,报真帧号——用最精确的方式消除歧义
- 满意了就冻结方向,先存基线——工程化管理版本,随时可回退
- 看不出区别就做对比,效果不好就回退——用实验而非直觉做决策
需要强调的是,创作者特别提醒:这套流程不是固定的,要根据模型的输出动态调整。它更像一种协作心态——把AI当成一个能力极强但需要精确引导的合作者,而不是一个一句话就能出活的魔法工具。真正决定成败的,从来不是模型有多强,而是人怎么用它。
相关推荐

Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。