56亿条TikTok视频元数据开源:Hugging Face上的大规模社交数据集
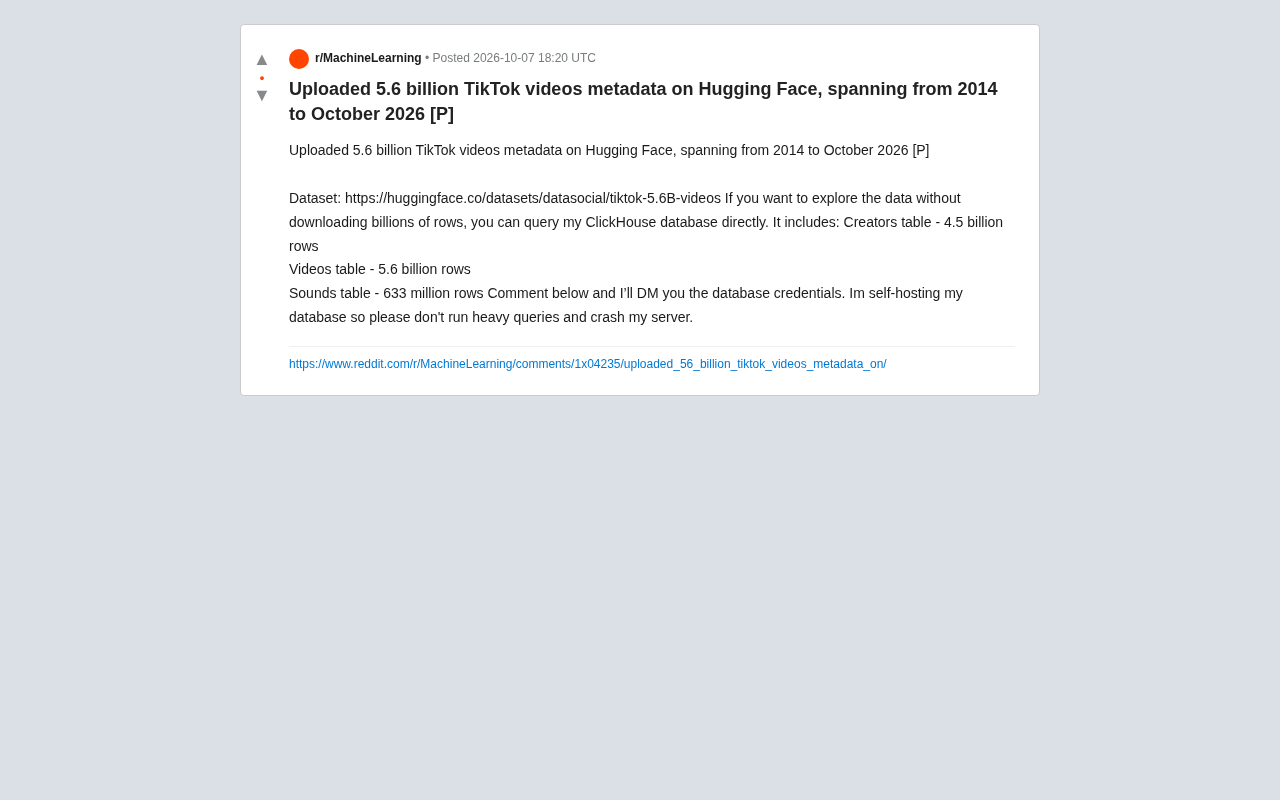
开发者公开56亿条TikTok视频元数据,覆盖2014至2026年,兼具研究价值与合规争议。
一位开发者在 Reddit 上发布了一份包含 56 亿条 TikTok 视频元数据的开源数据集,并上传至 Hugging Face,时间跨度从 2014 年延伸至 2026 年 10 月。数据集由创作者(45 亿行)、视频(56 亿行)和声音(6.33 亿行)三张表构成,完整映射了 TikTok 内容生态的核心维度。作者同时提供了全量下载与自托管 ClickHouse 在线查询两种访问方式。数据为元数据而非视频本身,虽降低了存储门槛,但其来源极可能涉及大规模爬取,在平台服务条款合规性与用户隐私保护方面存在不可忽视的法律与伦理风险,使用者需审慎评估。
一位开发者在 Reddit 上公布了一份规模惊人的开源数据集:涵盖 56 亿条 TikTok 视频元数据,并已上传至 Hugging Face。这份数据的时间跨度从 2014 年一直延续到 2026 年 10 月,几乎覆盖了 TikTok 平台从早期到当下的完整生命周期,对研究社交媒体行为、内容传播与推荐算法的人来说,是一份难得的大体量样本。
数据集的规模与结构
从作者公布的信息看,这份数据集的体量在公开社交数据领域相当罕见。它由三张核心表组成,分别对应 TikTok 生态中的不同实体:
- Creators 表(创作者):约 45 亿行,记录了平台上海量创作者的账号信息。
- Videos 表(视频):约 56 亿行,是数据集的主体,承载视频层面的元数据。
- Sounds 表(声音/音频):约 6.33 亿行,对应 TikTok 标志性的背景音乐与音效资源。
这种三表结构清晰地反映了 TikTok 内容生态的三大支柱:人(创作者)、内容(视频)和驱动传播的媒介(声音)。TikTok 的病毒式传播很大程度上依赖于同一段音频被成千上万条视频复用,因此单独建立一张 6 亿多行的 Sounds 表,对分析内容传播链条有独特价值。
需要强调的是,这份数据是元数据(metadata),而非视频文件本身。也就是说,它包含的是视频的描述性信息(如发布时间、关联创作者、使用的音频等结构化字段),而不是可播放的媒体内容。这既大幅降低了存储压力,也在一定程度上规避了直接分发版权内容的风险。
两种访问方式:下载与在线查询
面对 56 亿行这样的体量,直接下载并非所有人都能承受。作者为此提供了两条路径。
一是通过 Hugging Face 的数据集页面(datasocial/tiktok-5.6B-videos)获取完整数据,适合有足够存储和算力、需要离线批处理的团队。
二是作者自建了一个 ClickHouse 数据库,允许感兴趣的人直接在线查询,无需把数十亿行数据拉到本地。ClickHouse 是一款面向分析场景的列式数据库,擅长在海量数据上做聚合查询,选择它作为对外查询接口相当合理。作者在帖子中表示,可以通过私信向有需求的人发放数据库凭证。
不过作者也提出了明确的请求:由于数据库是**自托管(self-hosting)**的,希望使用者不要运行过重的查询,以免拖垮服务器。这句看似随意的提醒,实际上点出了这类个人开源项目的现实困境——庞大的数据诱人,但维护成本与稳定性全压在作者个人身上。
ClickHouse 由俄罗斯公司 Yandex 于 2016 年开源,专为 OLAP(联机分析处理)场景设计。与传统行式数据库不同,列式存储意味着查询时只读取涉及的列而非整行,这在"统计某类视频的点赞总量"这类聚合操作上能带来数十倍的性能提升。ClickHouse 还支持向量化执行与数据压缩,使其在单机上处理数百亿行数据时仍能保持秒级响应。正因如此,字节跳动、Cloudflare 等公司将其用于内部日志与用户行为分析。对于这份 TikTok 数据集而言,ClickHouse 的压缩特性同样有助于在有限磁盘空间内存储数十亿条记录,而无需花费与原始数据等量的存储成本。
价值与隐忧并存
从研究角度看,这类数据集的吸引力显而易见。社交平台的完整元数据对于研究内容传播规律、创作者增长曲线、音频驱动的流行趋势等课题都极具参考意义,而这些数据通常被平台牢牢掌握,外部研究者极难大规模获取。
但围绕这份数据集,隐忧同样不容忽视。首先是数据来源的合规性。TikTok 并未公开提供如此大规模的批量数据接口,56 亿行视频元数据与 45 亿行创作者信息很可能来自大规模抓取,这触及平台服务条款乃至相关法律的灰色地带。
其次是隐私问题。即便只是元数据,涉及 45 亿行创作者记录仍可能包含大量用户关联信息,公开分发存在对个人隐私造成影响的风险。研究者在使用前需要审慎评估其伦理与法律边界。
对开发者和研究者的提示
如果你打算使用这份数据集,建议关注几点:确认数据字段的具体含义与完整度;评估自身使用场景是否符合数据来源平台的条款;在涉及个人数据的分析中遵循隐私保护原则。对于只想快速验证想法的人,作者提供的在线查询入口是成本更低的起点,但要体谅个人服务器的承载能力。
这份数据集的出现,再次反映了开源社区对大规模真实世界数据的渴求,也暴露出这类数据在获取方式与合规性上的长期张力。它既是一个值得关注的资源,也是一个需要带着谨慎态度去对待的样本。
关于大规模网络爬取的法律边界,目前在不同司法管辖区存在显著差异。美国第九巡回上诉法院在 2022 年的 hiQ Labs v. LinkedIn 案中裁定,抓取公开可访问的数据不违反《计算机欺诈与滥用法》(CFAA),但这并不意味着爬取行为完全合法——平台的服务条款(ToS)仍可能构成合同层面的约束,且欧盟《通用数据保护条例》(GDPR)对涉及欧洲用户数据的处理设有更严格的要求。56 亿行创作者与视频数据若包含可识别个人身份的字段,在欧盟境内的分发和使用将面临实质性的合规挑战。这也解释了为何此类数据集往往以"研究用途"为名发布,但实际使用者仍需自行承担法律风险评估责任。
相关推荐
Gemini 4 维护 Chromium:两周完成数月代码量
开发者利用 Gemini 4 Argon 维护 Chromium 代码库,两周完成过去数月工作。AI 代理同时发起 20 个变更,全部通过数十万次测试,突破大型代码库的维护瓶颈。
Codex保姆级攻略:从安装到实战,一期精通AI桌面助手
基于B站热门教程,详解Codex从安装到实战的完整流程:与豆包的本质区别、项目概念、文件整理与仪表板生成两大实战案例,以及计划模式和桌面宠物等特色功能,帮你快速上手这款能直接操作电脑的AI助手。
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。