5B小参数大能力:Flux.3 Klein与MOSS Image在Draw Things上手指南

5B级轻量旗舰Flux.3 Klein与MOSS Image实测:协议、参数与本地部署全解析。
文章基于B站UP主「工具狂」的实测,介绍两款可在苹果生态Draw Things上本地运行的5B级图像模型:Flux.3 Klein(5.6B)与MOSS Image(5B)。二者均支持JSON结构化提示词与Bbox布局控制,但规则与Ideogram 4互不通用。协议上,MOSS Image采用Apache 2.0,Flux.3 Klein为社区许可、年营收500万美元以下可商用豁免。实测显示Flux.3 Klein人体解剖学较上代明显改善、原生支持编辑,Bbox位置编辑仅改变元素位置而不影响其他特征,M5 iPad上升图仅需10多秒;MOSS Image在文字与设计类任务上表现好,但人物生成偏「网红脸」。作者结论是把现有模型用透、沉淀工具技能。
开源图像模型正朝着「参数量更小、能力更强」的方向快速演进。最近在苹果生态的 Draw Things 上,两款 5B 级别的轻量旗舰模型——Flux.3 Klein 与 MOSS Image——相继可用,让消费级硬件跑出顶级生图与编辑能力成为现实。本文基于 B 站 UP 主「工具狂」的实测教程,梳理这两款模型的协议差异、能力特点与实战参数配置,帮助你在 Mac 与 iPad 上快速上手。
小参数趋势下的两款轻量旗舰
Flux.3 Klein 参数量为 5.6B(56 亿),MOSS Image 为 5B,二者都落在 5B 量级。这个级别的意义在于:普通消费级设备足以承载,同时模型能力并未因参数缩减而明显缩水。Flux.3 Klein 延续了上一代的双模能力,既能生成又能编辑;MOSS Image 官方暂不支持原生图像编辑,但在提示词理解、文字(含中文)生成与设计类任务上完成度不错。
两款模型都支持 JSON 结构化提示词精准控制 Bbox 位置生成,这一能力此前主要出现在 Ideogram 4 上。不过三者的 JSON 布局规则并不通用——原点位置、数值范围、坐标排列顺序完全不同,提示词不能直接照搬。UP 主为此更新了自制的 Bbox 元素定位布局工具页,并会分享相应的规则文件与提示词脚本。
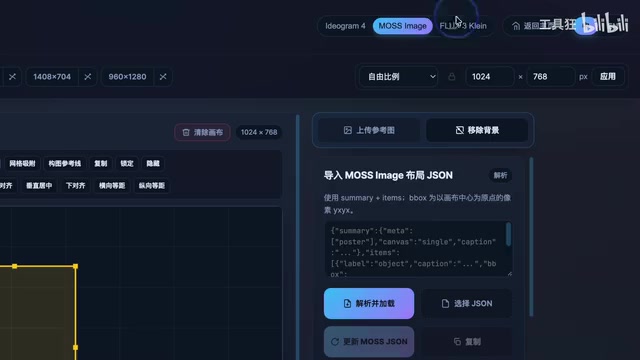
Bbox(Bounding Box,边界框) 是计算机视觉中的基础概念,指用矩形坐标框出画面中的目标区域。在文生图模型中,把 Bbox 写进提示词,就等于告诉模型「某个元素应该出现在画面的哪个位置」,从而实现精确的版面控制,而不是任由模型自由构图。常见的坐标写法有 [x1, y1, x2, y2](左上角与右下角两点)或 [x, y, w, h](左上角坐标加宽高)两种,原点可能取左上角也可能取中心。正因为这些约定没有统一标准,不同厂商的 JSON 布局规则天然不兼容,跨模型照搬提示词往往会得到完全错位的画面。
LoRA(Low-Rank Adaptation,低秩适配) 是一种轻量化的模型微调技术:它不改动原模型权重,而是在注意力层旁挂接一对小尺寸的低秩矩阵,训练时只更新这部分参数。对于文生图模型,社区最常训练的 LoRA 有两类——风格/角色 LoRA 用于教会模型特定画风或人物,加速 LoRA 则通过蒸馏让模型在 4~8 步内完成原本需要数十步的采样,从而把出图时间压到十几秒。LoRA 体积极小(通常几十到几百 MB),即插即用,在 Draw Things 这类本地客户端里可以直接加载切换。
协议与版本:商用门槛与选型建议
使用协议方面,MOSS Image 采用宽松的 Apache License 2.0,对商业应用和学术研究都友好;Flux.3 Klein 采用 Flux Community License 社区许可,总体允许非商业用途,但对年营业额低于 500 万美元的合格用户提供商业产出豁免权,更大规模的商业化需单独咨询授权。换言之,年营收 500 万美元以下的个人和中小团队可以商用无忧,大公司则需另行购买授权。
版本选择上,MOSS Image 提供 Base 与 SFT 两个版本,SFT 是监督微调版、开箱即用,一般推荐直接使用;Base 版更多用于二次开发或训练微调。即便是 SFT 版本,正常出图也建议 30 步以上,目前已有多个加速 LoRA 可用。Flux.3 Klein 则提供 Base 版与蒸馏加速版,Base 推荐 50 步,蒸馏版默认推荐 16 步。
Apache License 2.0 是业界最宽松的开源协议之一,允许自由使用、修改、再分发,包括商业用途,只要求保留版权声明与许可声明,并附带专利授权条款,因此对企业与学术团队都非常友好。相比之下,社区许可(Community License) 是一种「附条件的开放权重许可」,典型做法是按营收或用户规模划线:小规模使用者可免费商用,超过阈值则需向版权方购买商业授权。Flux 系列采用的正是这一模式,因此使用前务必核对自身的年营业额是否落在豁免区间内,否则合规风险由使用者承担。
SFT(Supervised Fine-Tuning,监督微调) 指在基座模型之上,用人工标注的高质量「指令—输出」配对数据继续训练,使模型更懂人类意图、开箱即可用;代价是可能收窄输出分布,导致风格趋同。Base 版则是未经指令对齐的原始基座,可控性与多样性更强,但需要用户自己写更精细的提示词,也更适合作为二次训练与微调的起点。选择 SFT 还是 Base,本质上是在「易用性」与「多样性/可塑性」之间取舍。
Flux.3 Klein 实战:解剖学改善与编辑能力
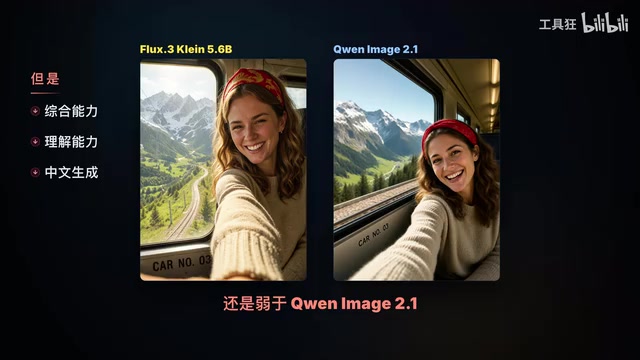
UP 主下载模型后的第一件事是测试人体解剖学理解,因为上一代在这一项上表现糟糕,直接影响生成任务的可用性。实测多张图后,仅 5.6B 参数的 Flux.3 Klein 对人物生成总体表现良好,手指、肢体、面部在一般复杂场景下都能应付。出图的质感和细节被认为在某个 2.1 版本模型之上,但综合理解能力、尤其是中文生成能力仍有差距。
参数方面,UP 主分享了三组优质出图参数:一组对应 16 步蒸馏版,另两组搭配 4 步加速 LoRA,可直接下载导入。编辑能力是 Flux.3 Klein 的强项——换头换脸、扩图原生模型即可完成,关键在于提示词写法。配合工具网站先生成扩图底板再粘贴到 Draw Things 生成,或使用专门的扩图 OutPaint LoRA,可让扩图任务更稳定。
最有意思的是 Bbox 元素位置编辑:此前的 Ideogram 4 没有编辑能力,元素位置一换、重新生成后所有元素都会变样;Flux.3 Klein 在编辑模式下改变元素位置后重新生成,仅位置变化,其他元素特征完全不变。UP 主以广告牌与闪电的位置调整为例做了演示。
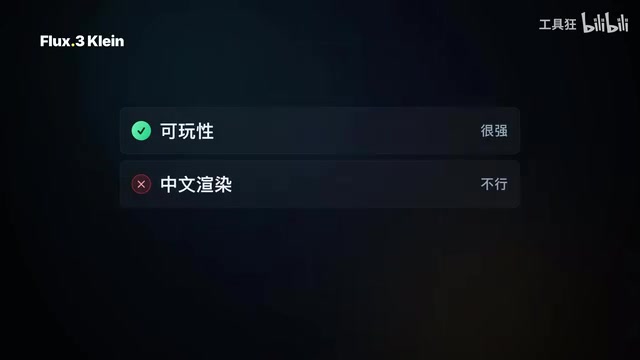
速度层面,Flux.3 Klein Base 搭配 4 步 LoRA 在 M5 iPad 上升图仅需 10 多秒,UP 主直言「这个速度让人很难不爱」,除中文渲染不行外,很多情况下会把它作为优先选择项。
MOSS Image 实战:文字见长,人物待打磨
MOSS Image 出自 OpenMOSS 团队,由上海创新研究所、复旦大学自然语言处理实验室与 MOSS.ai 联合创立,复旦大学邱锡鹏教授领衔,聚焦大模型、多模态生成及智能体等前沿领域的产学研融合与开源创新。用户一般下载后缀为 SFT 的版本。
实测感受是:该模型生成文字(包括中文)、做设计类任务时,提示词理解与生成完成度都不错;但人物生成,尤其是亚洲人面孔,多数情况下偏向「帅哥脸美女脸」,一眼 AI,有点像更早的 1.0 版本模型。UP 主猜测这与 SFT 有关,Base 版生成的人物在细节和多样性上要好很多。这一判断属于单一来源的主观体验,仅供参考。
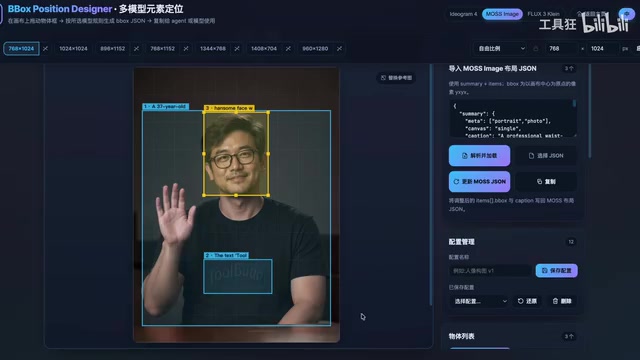
MOSS Image 同样支持 JSON 与 Bbox 提示词精准控制画面布局,规则与 Ideogram 4 不同,提示词不能通用。UP 主目前使用三个加速 LoRA,认为最佳效果是 SFT 版本加 8 步的 Chroma D-MDR LoRA,并鼓励大家分享自己的结论。官方没有编辑版,开源社区虽有魔改编辑版,但在 Draw Things 中无法使用;考虑到已有模型的原生编辑能力足够强大,也没有必要折腾魔改版。
工具技能需要沉淀
两款模型之外,开源社区紧接着又出了新的旗舰模型,UP 主坦言已有些疲倦。其结论值得记下:把现有模型用好用透,在 Draw Things 里做好恰当的组合,完全足以满足各种生图与编辑任务;最怕的是每个新模型来了浅尝辄止、新鲜一下就没有然后了。模型迭代不止,但工具技能需要沉淀。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。