60%用户双开Claude Code和Codex,真相是宕机保险
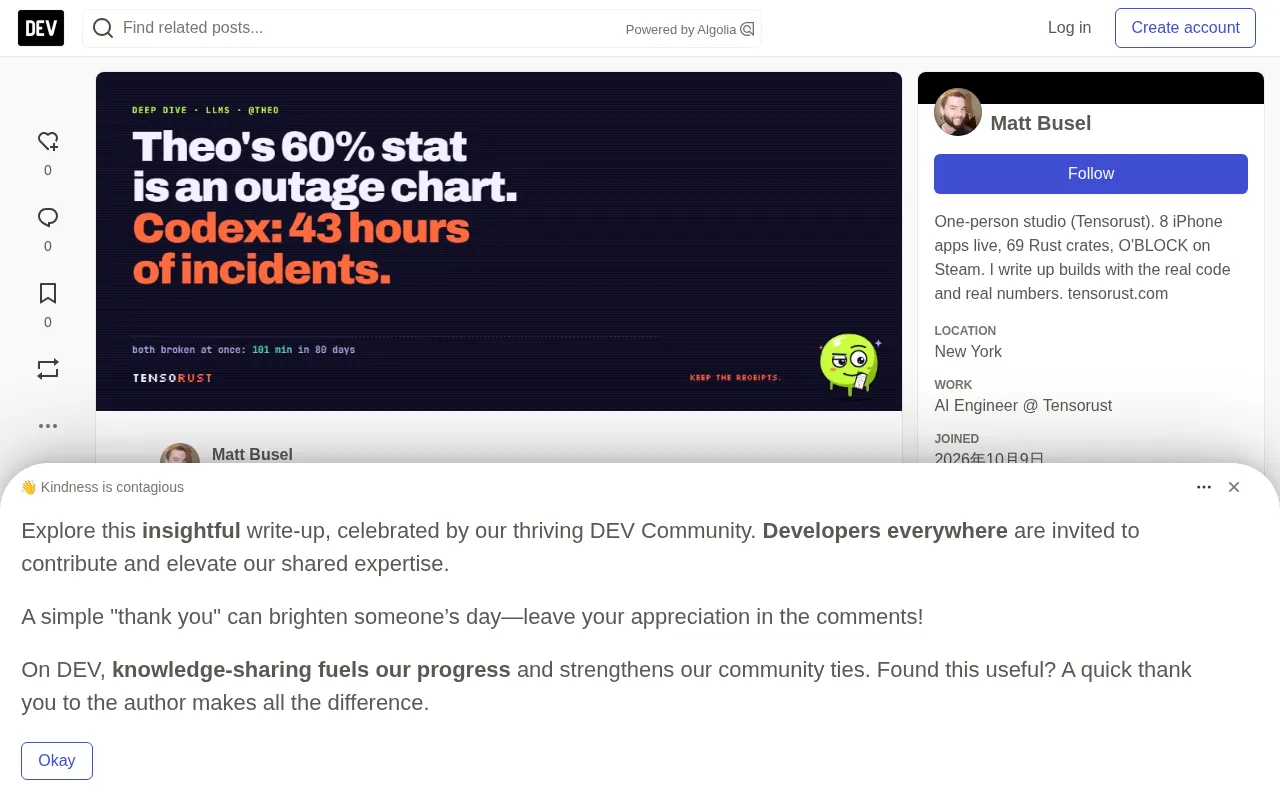
60%双开数据实为宕机保险,切换而非模型偏好。
文章拆解了T3 Code创始人Theo Browne“60%用户同时使用Codex与Claude Code”的推文,指出该数据发布时Codex正处于两周累计42.7小时的故障窗口,所谓双开并非模型偏好而是宕机应对。作者Matt Busel用约60行Python脚本分析两家状态页80天数据,发现Claude Code故障42.2小时、Codex故障56小时,但同时故障仅101分钟,交替使用可将可用性从约97%提升至99.91%。据此折算,叠加两个20美元套餐相当于每小时约1美元的宕机保险。文章还反驳了Theo对Anthropic自研git方案的引用,并公开自测LLM路由器对244个prompt全部选择同一模型,最终建议以熔断降级和状态页订阅替代“智能路由”。
一位开发者的统计数据被包装成“双模型趋势”,但当把两家公司的状态页放在一起看,结论完全反转。
一个被误读的60%
T3 Code创始人Theo Browne在X上发帖称,过去两周超过60%的T3 Code用户在用了Codex的同时也用了Claude Code,并暗示这证明了“harness才是产品”。帖子获得近7万次浏览,评论区普遍将其理解为:模型可以互换,真正有价值的是承载它们的外壳。
但独立开发者Matt Busel拉取了两家公司状态页的公开API,发现了一个关键背景:在同一时间窗口内,Codex有42.7小时处于未关闭的事故状态,占两周时间的12.7%。而Claude Code同期只有34分钟。换句话说,每八个小时里就有一个小时,Codex的状态页在报错。
“这60%不是偏好数据,是宕机数据的营销包装。”Busel在文章中直言。
80天数据:两边各自故障40小时以上
Busel用约60行Python脚本,对Anthropic的status.claude.com与OpenAI的status.openai.com接口做了区间合并和交集分析。窗口为8月1日至10月19日,约80天。
- Claude Code:28次事故,累计2533分钟(42.2小时),正常运行时间约97.79%。
- Codex:12次事故,累计3358分钟(56.0小时),正常运行时间约97.07%。
- 两者同时故障:仅101分钟,分属两次事件。
如果主用其中一个、故障时切换到另一个,覆盖率可从约97%提升到99.91%,消除96%至97%的停机时间。这解释了用户为什么“双开”——不是审美偏好,而是每次切换都在删掉几乎全部故障时长。
Busel也坦承数据局限:状态页的“degraded performance”并不等于完全中断,且状态页由公司自己维护,存在低报倾向。
状态页的“degraded performance”(性能降级)与“outage”(完全中断)在统计上通常被合并计入“未关闭事故”,但二者对开发者的实际影响差异显著:前者可能只是延迟升高或部分功能受限,后者则是服务不可用。Busel的脚本以事故状态持续时间为口径,将两类事件一并计时,这意味着42.2小时与56.0小时是“非正常状态”的上限估计,而非“完全无法使用”的精确时长。此外,状态页由厂商自行维护,事故的发现、定级与关闭均依赖其内部流程,历史上多家云服务商被指出存在低报或延迟披露的倾向,因此第三方基于状态页API的分析只能作为相对比较的参考,不宜当作绝对可用性的权威度量。
两个20美元套餐的经济账
Theo曾发帖说最常收到的私信是“哪个20美元套餐更好”。Busel用80天数据折算到月:
- Claude Code用户加订第二套餐,每月买回约15.5小时,折合每小时1.29美元。
- Codex用户加订第二套餐,每月买回约20.8小时,折合每小时0.96美元。
“如果你一小时的工作值超过一美元,第二个套餐不是奢侈品,是车库里的备用发电机。”文章写道。不需要新工具,只需要两个终端和“一卡就切”的习惯。
被误读的Anthropic工程博客
Theo置顶了一条推文,引用Anthropic自研源代码控制系统的消息,称“我们很多人最终都会走到他们那一步”。但原文明确写着:这套系统“绝不是git的通用替代品”,只适用于“拥有数万工程师或大量智能体的超大型单体仓库”。
Busel的反驳很直接:大多数开发者每天合并30次代码,不是3万次。该季度真正卡住多数人的是故障恢复,不是版本控制。GitHub状态页同期记录了4次影响Git操作的事故,共554分钟(9.2小时),远少于Claude Code的42.2小时。
自测路由器的尴尬结果
文章最有自嘲意味的部分,是作者对自己写的LLM路由库的实测。llm-router号称用五种策略把prompt分发给“合适的模型”,但跑完244个真实prompt(164个HumanEval编程题加80个MT-Bench首轮问题)后发现:每种策略都对全部244个prompt选了同一个模型。
原因藏在评分公式里:复杂度不匹配的惩罚最多将分数减半,而gpt-4o与gpt-4o-mini的价差是16.7倍。“Balanced”策略本质上就是最便宜模型选择器加了点仪式感。
“大多数号称智能的路由器都在做同样的事,只是没人公开跑过244个prompt。”Busel写道。真正有效的路由是笨办法:一家报错就转另一家。
所谓“LLM路由器”,指在应用层根据prompt特征(如长度、任务类型、预估复杂度)将请求分发给不同能力与价格档位的模型,以期在成本与质量间取得平衡。其典型评分函数会对“能力不匹配”施加惩罚,但惩罚幅度通常设有上限;当高端模型与低端模型的价格差达到十几倍时,成本项在总分中的权重往往压倒质量项,导致路由决策退化为“总是选最便宜”。要使路由真正有效,评分函数需要让质量惩罚随任务难度非线性放大,并引入对路由决策的事后评估机制;否则所谓智能路由只是给固定选择披上了一层策略外衣。
真正应该做的事
文章给出的建议朴素但可执行:
- 保持两个编程智能体同时登录,按上面的账,第二份订阅每小时成本约一美元。
- 订阅两家状态页的RSS或JSON推送,故障发生第一时间切换,而不是重试二十分钟。
- 在应用层做熔断降级,而非“智能路由”:连续失败五次后打开断路器,将流量导向另一家。
- 如果一定要按难度路由,先用公开prompt集测试,若一个模型赢下100%的决策,那就不是路由器。
- 切换之前先做带抖动的指数退避重试,多数波动是限流而非宕机。
对Theo“harness才是产品”的说法,Busel并不全盘否定——他承认同时承载两家模型的工具确实有用。分歧在于原因:是产品品味,还是宕机保险。数据站在后者一边。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。