64GB内存跑284B大模型?llama-modchip实测真相

llama-modchip 声称 284B 模型可在 64GB 内存无 GPU 运行,但速度数据未获社区复现,生产需谨慎。
llama-modchip 项目声称 DeepSeek-V4-Flash 284B 模型可在无 GPU、仅 64GB 内存的机器上运行,引发社区关注。其思路基于内存映射与专家混合(MoE)的按需调度,只将当前激活的专家权重驻留内存,其余部分通过页换入换出加载。然而,厂商报告的速度数据在 Hacker News 上未被多位尝试者复现,实际延迟与吞吐存在明显差距,原因可能在于测试场景的专家命中率较高,而实际使用中路由分布更随机,导致频繁换页。目前尚无权威第三方基准测试。文章认为,该方案更适合离线环境或研究探索,生产场景仍应优先选择托管模型,在独立基准出现前保持审慎。
从一则仓库声明说起
llama-modchip 项目近期发布声明,称 DeepSeek广告-V4-Flash 284B 模型可以在没有 GPU、仅 64GB 内存的机器上运行。这个说法在社区迅速引发讨论——284B 参数的模型通常需要远超 64GB 的显存或内存,纯靠 CPU 和内存完成推理,听起来像是把“不可能”写进了 README。
该仓库给出的路径并非传统量化,而是围绕内存映射与专家路由的重构思路,宣称在特定配置下让模型“装得下、跑得动”。但需要明确的是,仓库里写的是可行性描述,而不是经过独立复现的性能基准。速度数据来自厂商侧,并非第三方实测。
仓库到底说了什么
llama-modchip 的核心主张集中在两点:一是 284B 模型可以在 64GB 内存环境下加载,二是通过改造后的推理路径获得可用的吞吐表现。仓库提供了配置说明与运行指引,但关于“可用”的定义相对宽泛——它没有给出统一的延迟与吞吐基准,也没有公开完整的对照实验环境。
这意味着,仓库声明更接近“存在这样一条路径”,而非“这条路径在通用场景下表现良好”。对于想直接复刻的开发者,仓库的信息足以启动尝试,但不足以预判结果。这也是后续争议的根源。
厂商报告的速度,和 Hacker News 没能复现的部分
厂商报告的速度数据是这轮讨论的焦点之一。按照仓库方的说法,该方案在目标硬件上可以达到可接受的速度水平。但 Hacker News 上的讨论呈现出另一面:多位尝试者表示无法复现宣称的表现,实际运行中的延迟与吞吐与厂商描述存在明显差距。
社区反馈的分歧主要集中在几个环节:模型加载是否真正落在 64GB 边界内、推理过程中是否触发了大量内存换页、以及不同硬件配置对结果的影响。这些变量在厂商报告中未被充分披露,导致复现者面对的是一个“参数不同、结果不同”的黑箱。
补充一点,目前尚没有权威第三方对 llama-modchip 方案做系统性基准测试。Hacker News 上的反馈属于个体经验,不能等同于结论,但足以说明厂商速度数据缺乏普适性。
基准测试的可复现性:在系统性能评估中,可复现性要求实验环境、负载特征和测量方法被完整披露,以便第三方在相同条件下验证结果。厂商报告的速度数据若缺乏这些细节,复现者只能猜测配置,导致结果差异。Hacker News 上的反馈正体现了这一点:不同硬件(CPU 型号、内存带宽、磁盘类型)和不同输入序列都会影响专家路由和换页行为,从而产生截然不同的延迟与吞吐。因此,在独立基准出现前,厂商数据只能视为特定条件下的参考,而非普适性能承诺。
为什么 64GB 跑 284B 如此困难
284B 参数模型的权重体量远超 64GB,这是无法绕开的基本约束。任何让它“装进”64GB 的方案,本质上都需要在精度、稀疏化或按需加载上做取舍。llama-modchip 的思路大概率涉及专家混合结构下的按需调度——只把当前需要的专家权重驻留内存,其余部分留在磁盘或按页换入。
这种设计的代价是明显的:一旦推理路径频繁跨越专家边界,内存与存储之间的数据搬运就会成为瓶颈,延迟随之上升。厂商报告的速度之所以难以复现,很可能是因为测试场景恰好落在专家命中率较高的路径上,而社区的实际使用更接近随机分布。
专家混合(MoE)与专家路由:专家混合是一种稀疏激活架构,模型包含多个“专家”子网络,但每次前向传播只激活其中少数几个。路由网络(router)根据输入决定将 token 分配给哪些专家。这使得总参数量可以很大,而单次推理的计算量相对较小。然而,所有专家的权重仍需存储,因此内存占用并未减少。llama-modchip 的思路正是利用 MoE 的稀疏性,只将当前激活的专家权重保留在内存,其余专家权重存储在磁盘上,按需加载。这种按需调度依赖专家路由的局部性——如果输入对应的专家分布集中,换页开销就小;反之则频繁换页,导致延迟飙升。
内存映射(mmap)与页换入换出:内存映射是一种将文件或设备映射到进程地址空间的技术,允许程序像访问内存一样访问磁盘上的文件。当访问的页面不在物理内存中时,会触发缺页中断,操作系统将相应页面从磁盘加载到内存。llama-modchip 可能利用 mmap 将模型权重文件映射到内存,从而突破物理内存限制。但频繁的缺页中断会导致大量磁盘 I/O,成为性能瓶颈。尤其在专家路由随机性高时,换页次数激增,延迟显著上升。这解释了为何厂商报告的速度难以在通用场景复现——测试可能使用了专家命中率高的输入,而实际使用中路由分布更随机。
什么时候该用托管模型
如果你的目标是稳定可预期的推理服务,托管模型几乎是默认答案。云端的 DeepSeek-V4-Flash 或其他同级别模型不需要你操心内存边界、专家调度和换页策略,延迟与吞吐由服务方保障。
llama-modchip 这类方案的价值场景更窄:离线环境、数据不能出内网、或者纯粹出于研究目的验证一条技术路径。对于个人开发者做实验,64GB 内存跑 284B 模型是一个有意义的探索;但对于生产负载,把希望寄托在未经验证的 CPU 推理方案上,风险与维护成本都偏高。
理性看待“能跑”与“好用”
llama-modchip 的声明打开了一扇门,但门后并非坦途。仓库描述的是可行性,厂商报告的是特定条件下的速度,Hacker News 反馈的是复现困难——三者拼在一起,才构成完整图景。
对这类项目,合理的期待是:它可以作为研究起点,帮助你理解大模型在受限硬件上的调度边界;但它目前还不是一个可以托付生产流量的方案。在独立基准出现之前,保持审慎是更稳妥的选择。
相关推荐
5.3英寸手机众筹:小屏复兴还是599美元的无奈?
Enough Phone 在 Kickstarter 众筹,5.3 英寸小屏搭配 8GB 内存和 5000 万像素传感器,定价 599 美元。The Vergecast 讨论小屏手机能否在旗舰大屏与功能机之间找到中间地带,以及廉价手机为何越来越难做。
Asahi Linux弃用MIT转GPL:一场针对Omarchy的闹剧?
Asahi Linux将代码许可证从MIT改为GPL V2,指控Omarchy窃取代码并商业化。分析认为此举理由牵强且违反MIT协议,暴露开源社区政治分歧与AI争议。
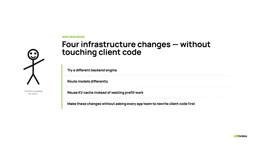
5分钟读懂NVIDIA Dynamo前端:兼容OpenAI的推理架构入口
NVIDIA Dynamo前端是什么?本文基于官方5分钟系列视频,解析它如何以OpenAI兼容API作为稳定边界,实现后端引擎替换、路由与KV缓存复用的解耦架构。