8000元法拍房数据采集单:JS加密参数逆向实战

8000元法拍房采集单的sign参数逆向全过程与代码复现。
本文完整还原了一个8000元法拍房数据采集接单项目的技术分析过程。客户需要每天采集40万条覆盖阿里、京东等平台的房产数据,并提供IP池做随机切换。核心难点在于列表页请求头中的sign参数:全局搜索定位失败后,作者通过XHR断点加调用栈回溯,成功找到加密逻辑位于某个JS文件中。断点分析确认,sign由token、时间戳和请求体拼接后经标准MD5生成,并非魔改算法。代码复现阶段因拼接符号格式和时间戳错误导致结果不匹配,修正后与目标值一致。详情页为静态HTML,直接解析即可。作者还指出,AI工具辅助定位效果有限,传统断点调试仍是逆向基本功,实际交付还需处理验证码等风控边界,并强调应遵守robots协议与相关法规。
法拍房数据采集是个典型的爬虫逆向接单场景。B站UP主“洛哥”最近接了一个8000元的客户需求,目标网站有参数加密和风控机制,但经过调试发现核心难点只有一个——请求头里的sign参数。本文完整还原这个单子的分析过程,从抓包定位到加密逻辑还原,适合正在学习爬虫、想接触真实商业项目的开发者参考。
需求拆解:这个单子到底要做什么
客户的需求很明确:采集法拍房网站的数据,开发一个带GUI界面的软件(提到PLQ65界面),每天采集两次,每次20万条,日累积40万条。数据覆盖阿里、京东等平台的房产信息。客户自己提供IP池,需要做随机切换。
从量级上看,40万条并不算大。UP主算了一笔账:一天有8万多秒,如果一秒能采30条,两小时就能满足20万条的需求。真正需要解决的是反爬机制——正常请求可能遇到加密参数、场景风控,批量跑还会触发验证码。
这类需求在接单市场上报价不低,因为它涉及真实的风控对抗,而不是简单的静态页面解析。UP主在视频里也提到,掌握这套技术“至少具备一定商业价值”。
抓包初探:列表页的加密参数定位
打开房产列表页,F12抓包后翻页,发现请求里只有一个s参数,Data部分是明文,看起来没有加密。UP主第一反应是“好像也没什么特殊的参数”。
但把参数值复制到搜索框里全局搜索,定位失败了——搜不到。换用中文关键词搜索也没有结果。UP主提到一个细节:用AI辅助定位(包括尝试MCP)也花了很长时间没搞定,最后回到传统方法,在源码面板打XHR断点,再翻页才成功断住。
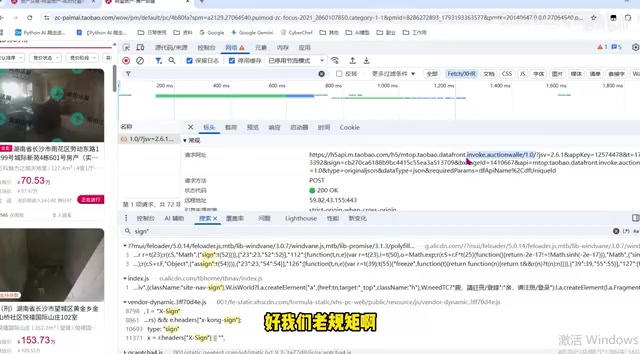
断点命中后,调用栈里能看到Data确实存在,继续往下追,定位到一个JS文件。在这个文件的执行上下文里,s参数的值已经被生成好了——说明加密逻辑就在这个文件里。
XHR断点(XMLHttpRequest Breakpoint)是浏览器开发者工具中的一种调试手段,用于在JavaScript发起Ajax请求时暂停执行。具体操作是在Sources面板的XHR/fetch Breakpoints区域添加断点,可指定URL包含的关键词,当页面发起匹配的XHR请求时,代码会自动暂停在发起请求的调用位置(通常是send方法)。这样就能在请求发出前检查当时的调用栈和变量状态,回溯到参数生成的上游代码。相比于在源码中盲目搜索,XHR断点尤其适合处理参数经过加密或动态生成、无法直接全局搜索定位的场景,是爬虫逆向中定位加密入口最常用的方法之一。
断点调试:还原sign的生成算法
接下来的关键是找到s参数的具体计算位置。UP主在调用栈里逐步跟进,打上断点观察变量值。
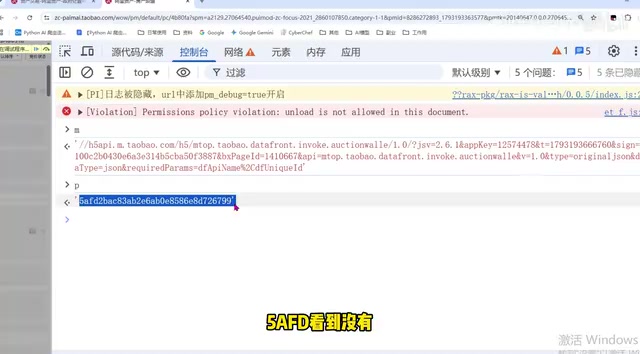
断住之后,检查几个关键变量:第一个值是token,当前为空;s是一个类似时间戳的值(125开头),可能是固定参数;data就是请求体信息。核心逻辑浮出水面——把token、时间戳、请求数据拼接后进行MD5加密,得到最终的s参数。
UP主特意确认了算法的标准性:从调用栈最上方看,这是一个比较常规的MD5实现,不是魔改版本。这意味着不需要逆向自定义哈希逻辑,套标准MD5就能还原。
MD5(Message-Digest Algorithm 5)是一种广泛使用的哈希函数,输出128位(16字节)摘要,通常表示为32位十六进制字符串。它具有雪崩效应:输入即使只改变一个字符,输出也会发生巨大变化,因此无法通过比对哈希值反推原文。在Web签名场景中,常见做法是将多个参数按约定顺序拼接后计算MD5,服务端用同样方式重算并比对,以验证请求未被篡改。需要注意的是,MD5已不再被视为安全的加密算法(存在碰撞攻击),但在防篡改签名、接口鉴权等场景中仍大量使用。还原时关键不在于算法本身,而在于拼接的原始字符串:分隔符、参数顺序、大小写、时间戳位数等细节必须与服务端完全一致。
调用栈(Call Stack)是JavaScript引擎用来追踪函数调用关系的机制:每当一个函数被调用,其执行上下文就被压入栈顶,函数返回时弹出。在DevTools的Sources面板暂停时,Call Stack区域会按“当前函数→调用者→调用者的调用者”的顺序列出整条链路。逆向分析时,可以从断点命中的位置逐层向上点击栈帧,查看每一层的局部变量和参数,从而判断加密参数是在哪一层、由哪些输入计算出来的。这种自下而上的回溯方式,能在没有源码可读、变量名被混淆的情况下,逐步还原出完整的参数生成逻辑。
代码复现:拼接与MD5的坑
进入代码实现阶段,UP主现场演示了参数构造:token用当前时间戳生成,s取固定值,data是请求体,三者拼接后做MD5。
第一次测试结果对不上,输出是30916开头,而目标值是7A开头。排查后发现两个问题:一是拼接时某个符号格式不对(目标值里有7A、677这样的片段),二是时间戳写错了。修正参数格式后,MD5结果与目标一致。
这里有个值得记录的教训:MD5本身是标准算法,但拼接字符串里的分隔符、参数顺序、时间戳精度任何一个出错,结果都会完全不同。调试时一定要逐段比对中间值,而不是只看最终哈希。
在Python中复现MD5签名常用hashlib库:hashlib.md5(拼接字符串.encode('utf-8')).hexdigest()即可得到32位小写十六进制摘要,若目标值是大写则再调用.upper()。复现时最常见的坑包括:编码不一致(UTF-8与GBK对中文请求体的字节序列不同)、拼接顺序与分隔符不匹配、时间戳单位错误(秒级与毫秒级相差1000倍)、以及十六进制大小写差异。建议在调试阶段把待哈希的原始字符串打印出来,与浏览器断点中看到的拼接结果逐字符比对,确认完全一致后再计算哈希,这样能快速定位差异来源。
详情页:静态页面直接解析
解决列表页的s参数后,详情页反而简单。刷新详情页接口发现它是静态的,没有额外加密参数,直接请求HTML解析即可拿到数据。
整个项目的技术路径清晰了:列表页带MD5签名请求分页数据,详情页直接解析静态HTML。核心工作量集中在签名参数的还原上,其余是常规的采集框架搭建和IP轮换逻辑。
这个案例的启示
从技术角度看,这个单子的加密强度不高——单一MD5签名,没有混淆、没有环境检测、没有滑块验证。但UP主在视频里也提到,批量采集时还会遇到验证码等风控,实际交付需要处理这些边界情况。
对学习者来说,这个案例的价值在于完整展示了接单项目的分析流程:抓包观察参数 → 搜索定位失败 → XHR断点回溯 → 调用栈分析变量 → 代码复现验证。UP主也坦言,AI工具在这种场景下“不一定能给你整出来”,传统调试手段仍然是基本功。
需要说明的是,本文仅记录技术分析过程,实际爬虫开发应遵守目标网站的robots协议和相关法律法规,数据采集需获得授权。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。