8GB显卡上的本地语音助手:让LLM为TTS让路,消除卡顿

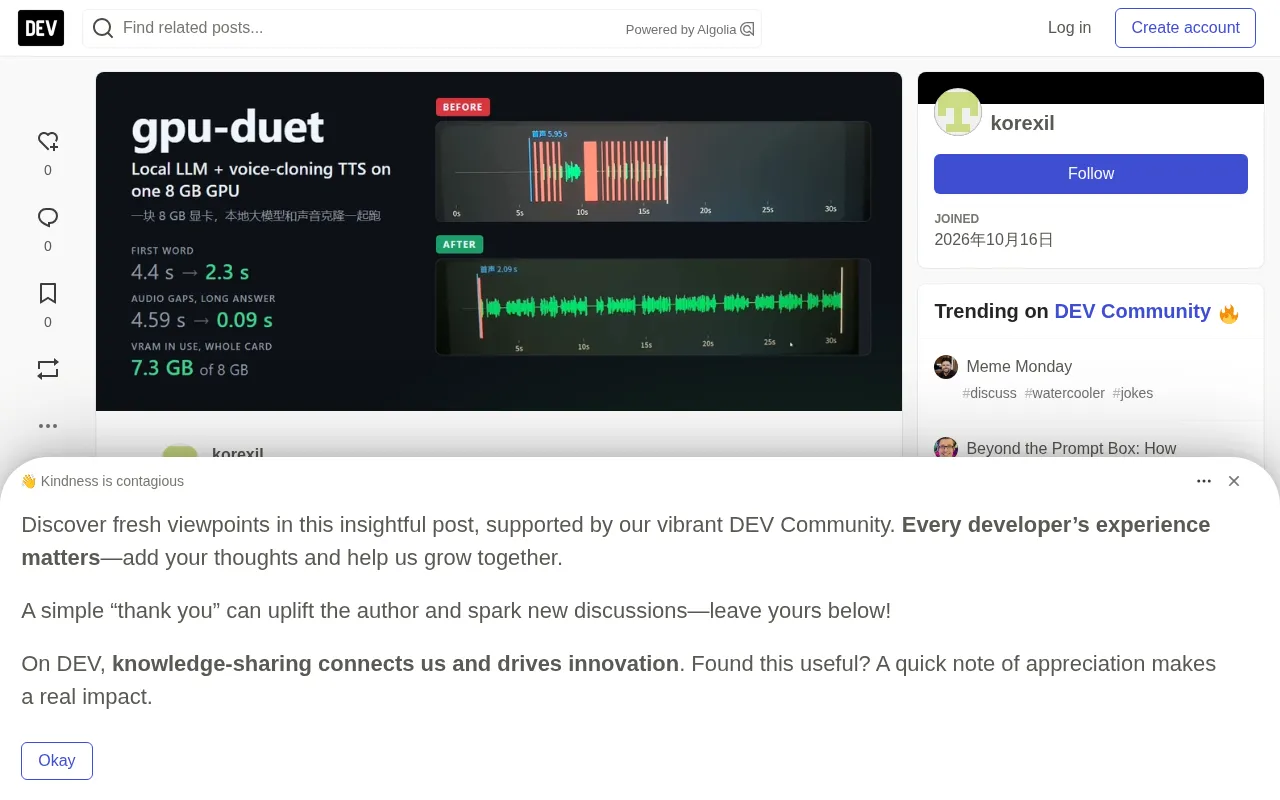
在8GB显存GPU上,让LLM与TTS轮流使用而非并行,可将首音频延迟从3.9秒降至2.3秒并几乎消除播放卡顿。
一位开发者在 RTX 4060 Laptop(8GB 显存)上搭建本地离线语音助手时发现,LLM 与 TTS 并行运行时 TTS 首句合成严重滞后,导致播放缓冲区耗尽、语音卡顿。经 PCM 追踪分析,卡顿集中在 LLM 生成的前 13 秒,TTS 逐帧解码的小内核调用在 GPU 计算队列中排队被拖延。开发者改用轮流调度:LLM 写一句即暂停,TTS 全速合成后 LLM 再继续。结果显示首音频延迟从 3.9 秒降至 2.3 秒,卡顿从平均 2.84 秒降至 0.09 秒,且通过权重去重和嵌入表放 CPU 使两个模型在 8GB 显存中稳定共存。方案已以 Apache-2.0 协议开源。
在消费级GPU上同时运行LLM和TTS,往往会遇到语音播放中途卡顿的问题。一位开发者在RTX 4060 Laptop(8GB显存)上搭建本地语音助手时发现:并行调度看似高效,实则让TTS引擎在首句合成时严重落后,导致播放缓冲区耗尽。他的解决方案出人意料——让LLM主动停下来等待TTS,用牺牲生成速度换取流畅的语音体验。
问题根源:首句合成为何跟不上
开发者的目标是让运行开源xiaozhi固件的ESP32语音助手板实现离线对话。系统由笔记本上的RTX 4060 Laptop GPU(8GB)和16GB内存驱动:语音检测和识别跑在CPU上,LLM(Gemma 4 E4B,QAT q4_0量化,基于llama.cpp)负责生成回答,语音克隆TTS(Qwen3-TTS 1.7B)逐句合成语音。
单独测试时,TTS引擎生成1秒音频仅需约0.6秒(实时因子RTF约0.6)。但一旦与LLM共享GPU,首句合成时间会膨胀到其自身长度的约1.5倍,而LLM空闲时仅需约1.0倍。生成速度慢于播放速度,缓冲区自然被掏空。
整段回答的中位每句RTF在两种模式下基本相同(0.84到0.89),瓶颈集中在首句。开发者推测,TTS逐帧解码产生大量小内核调用,每一步都在LLM的计算队列后排队。尝试限制LLM速度(20然后14 tokens/s)以及调整Windows的GPU调度优先级,均未奏效。
RTF(Real-Time Factor,实时因子) 是衡量语音合成系统速度的核心指标,定义为生成音频所需时间与音频本身时长的比值。RTF 小于 1 表示合成速度快于实时播放,理论上可以边合成边播放不卡顿;RTF 大于 1 则意味着生成速度跟不上播放速度,缓冲区迟早会被耗尽。需要注意的是,单句 RTF 达标并不代表整体流畅,因为首句往往承担了模型加载、缓存预热、计算队列排队等额外开销,其瞬时 RTF 可能远高于稳态值。这正是本文中并行模式下"中位每句 RTF 看似正常(0.84-0.89),但首句却拖后腿"现象的技术根源。
播放缓冲区(Playback Buffer) 是流式音频系统中的关键机制。发送端持续向播放设备推送音频帧,设备端维护一个短时缓冲队列(本文为 0.3 秒)。当缓冲队列被清空而下一帧尚未到达时,就会出现"断粮",表现为可听见的卡顿或爆音。缓冲区越大越能容忍生成抖动,但代价是首字延迟增加——用户需要等待更久才能听到第一声。因此流式语音系统的核心矛盾在于:缓冲区必须足够大以吸收生成波动,又必须足够小以保证交互响应。本文中"首音频延迟"与"卡顿次数"正是这对矛盾的两个极端观测值。
解决方案:轮流使用GPU
放弃并行后,开发者让LLM写一句就暂停,TTS以全速单独合成该句,然后LLM继续写下一句。在61到66 tokens/s的生成速度下,写一句的时间远短于说一句,音频始终领先于播放。
代价是LLM大部分时间在等待。在测试中,LLM完成全部写作耗时约54秒(而非12秒),而语音播放持续65到84秒。对于语音场景,这完全可以接受——听众本来就在听回答。
逐步改进的数据
开发者用相同的讲故事问题,在每一步发送文本(不含语音检测和识别),在同一时段内各测3次。"首音频"指服务器向板子发送第一帧音频的时间,卡顿由服务器根据板子0.3秒缓冲估算。
| 配置 | 首音频均值(范围) | 每次回答卡顿均值(次数范围) |
|---|---|---|
| PyTorch TTS在GPU,LLM在CPU | 4.4秒(3.5-6.0) | 4.59秒(48-60次) |
| 原生C++ TTS在GPU,LLM在CPU | 5.3秒(5.2-5.4) | 0.05秒(0-2次) |
| 两者同时跑在GPU | 3.9秒(3.8-4.1) | 2.84秒(9-17次) |
| 两者轮流跑在GPU | 2.3秒(1.9-2.7) | 0.09秒(0-1次) |
切换到原生引擎本身几乎消除了所有卡顿,但首字延迟并未改善(5.3秒对4.4秒,且基线波动很大)。PyTorch TTS进程占用约8.9GB私有内存,在16GB笔记本上大部分被换页到磁盘,因此第一行不应被解读为通用的PyTorch与原生引擎对比。将LLM移到GPU让首字更快,却带回了卡顿。轮流使用不仅让首字更快,还消除了这一退化。
另一项仅改变调度的对照测试使用日语提示、模拟0.5秒缓冲的播放器、两种模式下生成文本完全相同,各跑6次。并行时6次全部卡顿,轮流时0次卡顿。
PCM追踪揭示了什么
在Hugging Face论坛发帖后,有读者建议记录每个音频块的实际到达时间,而非只看平均值。服务器现在记录每个交给TTS的句子、每个音频块及其时长、以及每批释放给发送端的帧。
并行时,TTS在LLM生成期间持续落后。 首音频在请求后2.3到2.5秒才到达(而非1.0到1.2秒),三次运行中所有卡顿都集中在前13秒——LLM仍在写或刚写完时;之后没有卡顿。在服务器时间线上,播放器需要等待1.9到3.4秒才能完全避免卡顿。轮流模式下这个数字是0到0.12秒。这个"播放器需要等多久"的指标最适合跨GPU比较。
最后一处卡顿来自服务器自身,而非GPU。 为修剪尾部静音,服务器扣留每个分段最后1.2秒音频。TTS将首1.0到1.2秒作为一个突发交付,因此直到约0.19秒后下一块到达才发送。三次轮流运行中,有一次在此时刻只释放了单个60毫秒帧,板子断粮0.13秒。将首段按音频到达即发送的方式重放,可消除该卡顿并提前0.19秒发出首帧。
如何塞进8GB显存
TTS运行在基于qwen3-tts.cpp的修补版C++引擎上。两个补丁最关键:去重Q/K/V权重节省488 MiB显存,将文本嵌入表保留在CPU节省594 MiB。两个模型同时加载时,显卡显示8,188 MiB中占用7,448 MiB;其中约6.8GB是两个模型,其余是桌面环境。
Q/K/V 权重去重 是 Transformer 推理优化中的一个实用技巧。在多头注意力机制中,查询(Query)、键(Key)、值(Value)三个投影矩阵有时会共享部分参数或存在结构冗余。通过识别并合并这些重复或可共享的权重张量,可以在几乎不损失精度的前提下减少显存占用。在参数量较大的模型(如本文的 Qwen3-TTS 1.7B)上,这类优化往往能释放数百 MiB 的宝贵显存,为多模型共存创造条件。
文本嵌入表放置于 CPU 是混合推理(Hybrid Inference)的常见策略。Transformer 模型通常包含一个巨大的词嵌入矩阵(Embedding Table),其参数量可能与模型主体相当,但在推理时每个 token 只查表一次,属于典型的"访存密集但计算稀疏"操作。将这部分权重保留在 CPU 内存中,GPU 仅需在需要时读取对应的嵌入向量,可以显著降低显存峰值占用。代价是引入少量 PCIe 传输延迟,但在文本生成速度远快于语音播放的场景下,这一开销通常可以忽略。本文正是通过这两项优化,才让 Gemma 4 E4B 与 Qwen3-TTS 1.7B 同时驻留在 8GB 显存中。
局限与未竟事项
整套系统完全自托管。测试仅在单台机器(RTX 4060 Laptop、Windows 11)上进行,从未在Linux或macOS上运行。LLM侧尚不支持工具调用。不需要专用板子——它也可作为本地LLM+TTS的HTTP服务运行。
代码、原始数据测量、PCM追踪和踩坑记录已以Apache-2.0协议开源。开发者向社区提问:如果你在同一块消费级GPU上运行LLM和TTS,轮流使用是否仍能胜过并行?
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。