8G显存本地跑125B大模型:Qwen3.8-Flash-Next部署实测
一张消费级显卡+大容量内存,通过量化与内存卸载即可本地运行125B参数大模型。
视频演示了一个颠覆常规认知的方案:仅需8G以上显存的消费级显卡配合64GB内存,借助开源llama.cpp引擎和量化压缩技术,即可在普通台式机上完全本地化运行1250亿参数的Qwen3.8-Flash-Next模型。实测中,模型在零代码前提下生成了可运行的3D滑雪游戏与FPS射击游戏,支持多模态图片识别(准确计数25根筷子),并可通过兼容OpenAI/Anthropic接口的Agent客户端完成多步骤复杂工程任务。该方案完全免费开源、无需API费用,但复杂任务耗时较长(数小时级别),且对内存容量有较高要求,当前更适合探索研究而非生产级重度使用。
消费级显卡运行千亿参数模型成为现实
长期以来,运行千亿参数级别的大语言模型几乎是数据中心和多卡工作站的专属场景。但零度解说在最新一期视频中演示了一个颠覆常识的方案:只需一张8G以上显存的消费级显卡,配合较大容量的内存,就能在本地运行一个1250亿参数(125B)的大模型。
这个方案的核心是一位海外开发者的开源项目,它能把 Qwen3.8-Flash-Next 模型直接搬到普通台式机上运行。无需服务器、无需多张显卡、也不用昂贵的工作站——30系、40系或50系的 N 卡,甚至 A 卡都能跑。更关键的是,整个推理过程完全本地化,不依赖任何 API,不产生 token 费用。
其技术思路的关键在于「内存硬抗」:显存不足的部分由系统内存与虚拟内存补足。测试机型的配置为8G显存加64GB内存,正是靠大内存承载模型主体,才让小显存也能跑起庞大的模型。
「内存卸载」(Memory Offloading)是这一方案的核心机制:当GPU显存不足以容纳整个模型时,推理框架会将部分模型层(Layer)卸载到系统内存(RAM)甚至磁盘上的虚拟内存中,推理时按需将对应层调入显存计算,计算完毕后再换出。这一机制的代价是显著的速度损失——数据在VRAM、RAM与磁盘之间的传输带宽远低于GPU内部带宽,因此层卸载越多,每秒token生成速度越低。64GB大容量内存的意义正在于此:内存与显存之间的带宽(DDR5约80GB/s)远高于内存与硬盘(NVMe SSD约7GB/s),使模型主体留在内存中而非频繁读盘,是保证推理速度可用的关键。这也解释了为何该方案对内存容量有硬性要求,而非仅凭虚拟内存"凑合"。
从模型选择到量化:部署流程拆解
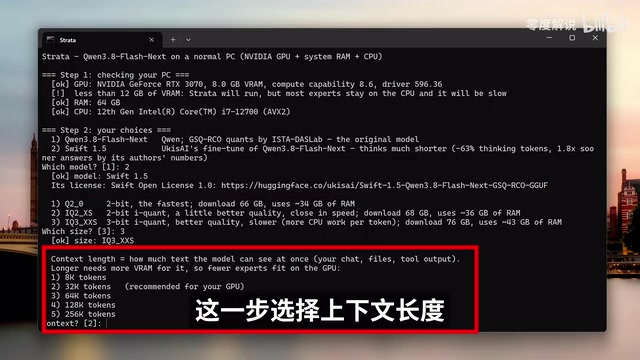
该项目基于 llama.cpp 启动引擎构建,安装过程相对友好。下载解压后运行目录下的启动脚本(started here 批处理),程序会自动检测当前硬件配置,并引导用户逐步完成设置。
整个配置过程包含几个关键选择:
模型版本:原生模型质量最高但速度较慢;优化版可减少约63%的思考时间,输出更快而质量几乎不变。
量化等级:这是平衡质量与内存占用的核心环节。Q1量化版约需34GB内存,IQ1-XS约需36GB,IQ3约需43GB。内存不足时可用虚拟内存补足,用户可根据自身配置灵活选择。
上下文长度:程序会根据显存推荐不同数值。8G显存推荐32K上下文,24G显存可支持128K。
KV缓存精度:作者推荐8bit,4bit速度更快但效果略降。
此外还可选择是否加载约1.4G的图片识别模块,以启用多模态能力。需要注意的是,模型下载需要稳定的国际网络环境,否则无法完成。
**量化(Quantization)**是指将模型权重从高精度浮点数(如FP16/BF16,每个参数占16位)压缩为低精度整数(如INT8、INT4甚至INT1)的技术。以125B参数模型为例,FP16精度下需要约250GB显存,而Q1量化可将每个参数压缩至约1bit,使总体积缩减至可用消费级内存承载的范围。量化等级数字越小,压缩率越高,占用内存越少,但模型推理质量(尤其是逻辑推理和细节生成)也会随之下降。IQ系列(如IQ1-XS、IQ3)是"重要性感知量化"的变体,它根据每个权重对模型输出的重要性分配不同的精度,在相同压缩率下比均匀量化保留更多有效信息,是目前极端压缩场景下的主流方案。
**KV缓存(Key-Value Cache)**则是Transformer架构在推理时存储注意力中间结果的机制,上下文越长、精度越高,KV缓存占用的显存越多。将其从FP16降至8bit或4bit可显著节省显存,换取更长的可用上下文,但过低精度会影响长文本的连贯性。
实测代码能力:零代码生成3D游戏
部署完成后,程序会在 127.0.0.1:8080 提供一个本地控制面板,包含对话界面和实时监控面板(显示 token 输出速度、GPU 占用率、内存使用等参数)。
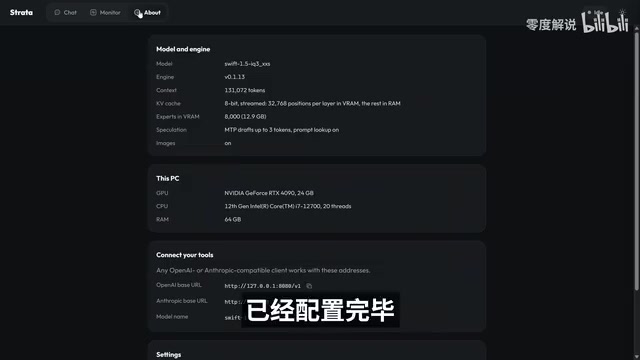
第一个测试是让模型编写一个3D滑雪游戏。在24G显存配置下,输出速度约为每秒63 token。模型耗时十几分钟生成了完整代码,复制运行后一次性通过——游戏支持方向键转弯、加减速控制,雪山场景与背景音效齐全,运行流畅。整个过程作者没有写一行代码。
一个值得关注的细节是长任务稳定性。原版 llama.cpp 在跑长任务时经常报「上下文长度不够」的错误,而这个方案在十几分钟的长任务执行中并未出现此问题,能够流畅跑完复杂生成任务,这是实用层面的重要优势。
随后作者加大难度,让模型编写 FPS 射击游戏。这次输出速度降至约每秒45 token,耗时约半小时完成。生成的游戏是单个 HTML 文件,无需安装包和游戏引擎,直接在浏览器中打开即可运行。游戏包含雷达小地图、换弹机制、爆头伤害数字、弹药与血包拾取,连枪声和背景音都是代码合成的音频——没有引用任何外部音频文件。
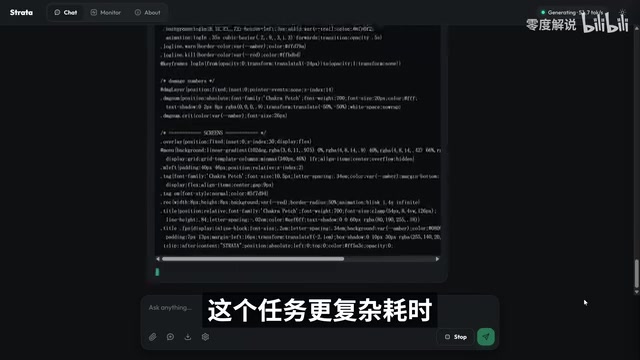
不同任务的 token 输出速度存在差异,复杂度越高速度越慢,这是本地推理在算力受限下的正常表现。
多模态与 Agent 应用拓展
由于加载了图片识别模块,模型具备多模态能力。作者上传一张筷子图片让其计数,模型准确识别出25根,并按截面分类为银色金属头19根、彩色6根(细分蓝、黄、米白、绿色),经人工核对完全正确。
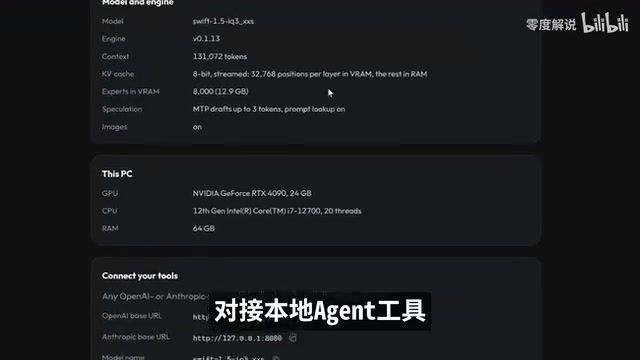
更进阶的玩法是接入 Agent。该项目兼容 OpenAI 和 Anthropic 的接口格式,本地地址 127.0.0.1:8080 可直接对接到 Hermes 等客户端,由于是本地模型,API key 可留空。
作者演示了让 Agent 开发一个「桌面虚拟伴侣」应用,这是个包含10个子任务的大型工程,耗时数小时完成。最终生成了一个带使用说明书的完整项目,实现了实时3D交互、双向语音对话和意图动作控制的桌面卡通形象「小软」,可以响应对话、戳脸互动等。虽然建模精度一般,但功能完整可用。
此处的Agent指让大语言模型作为「决策核心」,自主调用外部工具(如文件读写、代码执行、浏览器操作等)来完成多步骤任务的工作模式,区别于单轮问答。该项目兼容OpenAI和Anthropic的API接口格式,意味着原本为调用GPT-4或Claude设计的Agent客户端(如Hermes、Cursor等)无需修改代码,只需将API地址从远程端点替换为本地的127.0.0.1:8080,即可无缝切换到本地模型。这种兼容性设计极大降低了迁移成本,也让本地模型能复用现有Agent生态中积累的提示词、工具链和工作流配置。API key留空的设计则省去了鉴权步骤,因为请求不会离开本机,无需身份验证。
对本地部署趋势的思考
这个案例的意义不在于游戏本身的精美程度,而在于它证明了一条路径:通过量化技术与内存卸载,千亿参数模型的本地化门槛正在被大幅拉低。对于关注数据隐私、希望摆脱 API 费用、或需要离线环境的用户,这种「大内存硬抗」方案提供了一个真实可行的选择。
当然也需理性看待局限:复杂任务动辄数小时的耗时、对大容量内存的硬性需求、以及量化带来的质量折损,都意味着它目前更适合探索尝鲜而非生产级重度使用。但技术演进的方向已经清晰——消费级硬件运行前沿大模型,正从不可能变为日常。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。