8款AI视频模型同题实测:Kling 4.0险胜Seedance 2.5

8款AI视频模型同平台同提示词盲测,Kling 4.0以35分夺冠,复合指令成共同短板。
一位YouTube创作者在Higgs Field平台上用同一段复杂连续镜头提示词,对8款最新AI视频模型进行无剪辑、不重试的横向盲测,按提示词准确度、运动与物理、一致性、真实感四项各10分打分。Kling 4.0以35分单独领跑,Gemini Omni Flash 1.1、Minimax H3和Seedance 2.5以33分并列第二,WAN 3.0 Prime、Seedance 2.0、Flux 3 Video和Grok Imagine 1.5分布在29至32分。测试揭示三个信号:复合提示词是当前模型共同短板,分辨率画质并非决定因素,版本迭代不等于全面进步——Seedance 2.5质感提升却在指令执行上出现遗漏。
一场没有剪辑作弊的AI视频盲测
当AI视频模型越来越多,普通人很难判断哪一款真正能打。一位YouTube创作者做了一次相当硬核的横向对比:把同一个提示词喂给8款最新AI视频模型,在完全相同的平台、相同的10秒时长、相同的16:9比例下生成,不做任何挑选或重试美化。测试使用的提示词是一段复杂的连续镜头——身穿做旧白色宇航服的宇航员在雨夜霓虹城市中缓慢行走,镜头平滑后退保持人物居中,路人撑透明伞自然经过,车辆溅起水花,宇航员短暂转头看向发光摩天楼。
所有模型均在Higgs Field平台上运行,创作者只需粘贴一次提示词,然后通过模型选择器逐个切换。参测模型包括Kling 4.0、Seedance 2.5、Seedance 2.0、Minimax H3、WAN 3.0 Prime、Grok Imagine 1.5、Lux 3 Video和Gemini Omni Flash 1.1。评分维度共四项:提示词准确度、运动与物理、一致性(宇航员是否始终是同一个宇航员)、真实感(是否一眼看出是AI),每项满分10分。
Higgs Field 是一个聚合式 AI 视频生成平台,用户可在同一界面内切换不同厂商的底模,无需分别注册和订阅。这类平台的价值在于把「模型对比」的变量控制简化:提示词、时长、画幅、分辨率等参数在同一次会话中保持一致,避免因不同平台默认设置差异而引入偏差。对评测而言,同平台运行意味着生成结果的差异更可能来自模型本身,而非平台预处理或后处理管线。需要注意的是,聚合平台有时会对输入提示词做统一改写或安全过滤,也可能对部分模型施加分辨率上限,因此「同平台」并不完全等同于「同底层参数」,读者在看此类横评时应留意平台是否公开了默认采样步数、引导系数等细节。
中游选手:各有亮点也各有硬伤
得分集中在28到33分区间的模型,呈现出明显的偏科特征。WAN 3.0 Prime拿到32分,整体质感接近真实街拍,但宇航服面罩的处理有明显瑕疵。Gemini Omni Flash 1.1和Minimax H3同为33分,前者水花、转头、透明伞等元素几乎全部命中,后者虽然只有2K分辨率选项,但氛围更暗更有电影感。
Flux 3 Video得到29分,创作者认为它生成的群众面部是最自然的,代价是宇航员在人群中几乎被淹没,主体丢失。Grok Imagine 1.5最高仅支持720p,水花效果是全场最大,但溅起方式夸张得像间歇泉,镜头也有漂移。基线版Seedance 2.0拿到30分,伞和车辆都到位,群众却像复制粘贴出来的。
提示词准确度与真实感在 AI 视频评测中常被混为一谈,但二者衡量的能力并不相同。提示词准确度考察模型对复合指令的解析与执行,包括主体动作(转头)、环境事件(水花、透明伞、车辆经过)和镜头运动(平滑后退、人物居中)是否按描述发生;真实感则考察画面是否容易被一眼识破为 AI 生成,涉及材质、光照、面部和运动模糊等感知层面。一个模型完全可能真实感很高却漏掉关键动作,也可能事件齐全但画面塑料感明显。正因为这两项可能背离,本次测试把四项维度分开打分才有意义;若只给一个总分,Seedance 2.5 这类「质感强、执行弱」的模型与 Grok Imagine 1.5 这类「执行有亮点、画质受限」的模型就会被混为一谈。
Seedance 2.0与2.5:同一提示词下的版本差异
两代Seedance的对比很能说明问题。2.0单次生成最长15秒,2.5提升到30秒。在同一镜头下,2.5的画面更靠近人物,宇航服细节和光影层次明显更丰富;2.0反而给出了更多透明伞和一辆经过的汽车。最终2.5比2.0高出3分——细节质感赢了,但对提示词中具体事件的还原出现遗漏,水花和转头都没有出现。
这种取舍揭示了一个常见困境:模型变强往往体现在画面质感和一致性上,而多事件、多动作的复合指令执行反而可能退化。对于需要精确复现分镜的创作者,版本升级不一定意味着更省心。
决胜局:Kling 4.0以35比33胜出
最终对决在Kling 4.0和Seedance 2.5之间展开。Kling 4.0拿下全场最高的35分,四项分别为8、9、9、9。它的镜头运动是八款中最平滑的,提示词里要求的转头动作确实发生了。Seedance 2.5得到33分,宇航服和灯光质感极为出色,一致性和真实感都拿到9分,但水花和转头双双缺席,提示词准确度只有7分。
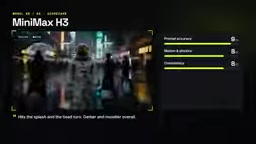
最终排行榜上,Kling 4.0单独领跑,Gemini Omni Flash 1.1、Minimax H3和Seedance 2.5以33分并列第二。创作者同时把Kling 4.0和Seedance 2.5评为真实感最强的两款。你可能没注意到,这是一期赞助视频,但测试流程公开透明——所有模型同平台、同参数、同提示词,切换过程全程可见,这比多数只放精选片段的对比更有参考价值。
一致性是 AI 视频中一个容易被低估的指标,它指的是同一主体在镜头内是否保持身份稳定,包括面部、服装细节、体型比例不随时间漂移。在长镜头或人物转身、遮挡再出现时,扩散类视频模型容易出现「同一角色换脸」或宇航服纹理突变。一致性差会直接破坏叙事可信度,也让后期剪辑难以使用。本次评测把一致性单独列为 10 分项,正是因为复杂连续镜头对主体保持的要求远高于单帧画面质量;Seedance 2.5 和 Kling 4.0 在这一项都拿到 9 分,说明头部模型已能把身份漂移控制在较小范围,而中游模型的主体丢失问题(如 Flux 3 Video 中宇航员被人群淹没)本质上也是一致性在构图层面的失败。
对创作者意味着什么
这次实测给出的信号相当明确。第一,复合提示词是当前AI视频模型的共同短板,能同时处理好镜头运动、主体动作和环境交互的模型极少,多数会在某个环节掉链子。第二,分辨率和画质不是决定因素,720p的Grok Imagine 1.5在运动维度上明显吃亏,而只有2K选项的Minimax H3反而靠氛围感拿到并列第二。第三,版本迭代不等于全面进步,Seedance 2.5在质感上跃升,却在指令执行上留了缺口。
对实际使用而言,多模型同平台对比是快速建立直觉的有效方法。把同一个提示词跑遍候选模型,按提示词准确度、运动、一致性、真实感四个维度打分,比看官方演示片更能判断哪款适合手头的项目。需要精确分镜还原的选提示词准确度高的,追求氛围和质感的选真实感强的,这条思路在本次测试中得到了完整验证。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。