8卡2080Ti 22G本地部署GLM-5.3-Flash实测:TP2 PP4并行方案解析
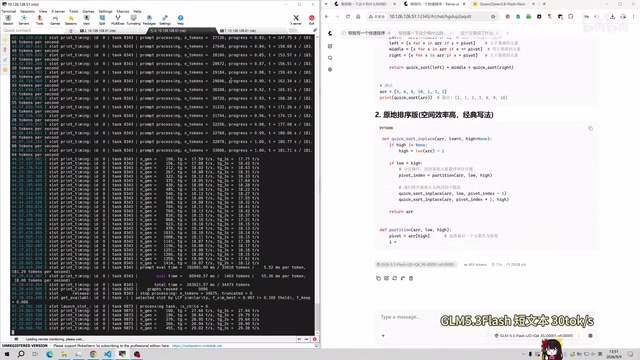
8卡魔改2080Ti用TP2 PP4混合并行部署GLM-5.3-Flash,短文本30 tok/s,并揭示多卡推理的三大工程陷阱。
一位B站UP主用8张22G显存版2080Ti部署GLM-5.3-Flash,通过TP2 PP4混合并行策略(两两一组张量并行、四组间流水线并行)实现了短文本约30 tok/s的推理速度。实测还揭示了多卡推理的核心特征:33K长文本下预填充速度约180 tok/s,而解码仅约18 tok/s,二者差距源于预填充的通信密集属性;此外在深层流水线切分拓扑下,推测解码/MTP等加速技巧因跨组通信开销过高而无法有效提速。整套方案为低成本二手显卡搭建本地推理平台提供了可量化的实践参考。
在消费级或准专业级显卡上跑大模型,最大的痛点往往不是显存能不能装下,而是多卡协同的效率。一位B站UP主用8张改装的2080Ti 22G显卡本地部署GLM-5.3-Flash,通过一套定制化的并行策略拿到了不错的实测数据,也顺带把多卡推理里常见的性能陷阱讲得很直白。
硬件配置与实测表现
这套系统由8张2080Ti 22G显存版本组成——这是国内二手显卡市场上颇为流行的魔改方案,把原本11G的显存翻倍到22G,用相对低廉的成本堆出可观的总显存池。在这样的平台上部署GLM-5.3-Flash,经过一定量的调优后,短文本推理达到了每秒约30 token的速度。
对于本地部署的中等规模模型而言,30 tok/s 已经能满足流畅的交互式体验。UP主特别指出,这个成绩是在"一定量的魔改"之后才达到的,说明开箱即用的默认配置并不能充分发挥这套多卡系统的潜力。
并行策略:为什么不是"一卡有难七卡围观"
多卡部署最典型的失败姿态,就是负载严重不均——一张卡满负荷运转,其余几张几乎闲置。UP主观察到自己这套系统上每张卡都保持了一定占用,功耗分布相对均衡,背后正是并行策略的功劳。
具体方案是 TP2 PP4:显卡两两一组做张量并行(Tensor Parallel),一共分成四组,组与组之间再做层间切分(Pipeline Parallel)。这种混合并行的设计有其针对性——在两两一组的拓扑下,张量并行的通信开销可以被控制在较小范围内,因为高频通信只发生在同组的两张卡之间;而整体上又借助流水线并行避免了纯张量并行在卡数增多时通信开销爆炸的问题。
用UP主的话说,这样"总体速度又比流水线并行快"。这是一个很实际的工程权衡:纯TP在卡多时通信瓶颈明显,纯PP则容易出现流水线气泡导致利用率低下,TP2 PP4 试图在两者之间取一个甜点。
张量并行(Tensor Parallel,TP) 是将单层的权重矩阵沿某个维度切分,分散到多张卡上同时计算,每个前向传播步骤结束时需要做一次 All-Reduce 通信来合并结果。这种方式能让每张卡只存储部分权重,但代价是每一层都需要跨卡同步,通信频率极高。当参与TP的卡数增多,All-Reduce 的数据量和延迟都会线性乃至非线性增长,因此通常只适合卡间带宽极高(如NVLink互联)的场景,或像本案例这样把TP限制在两卡范围内。
流水线并行(Pipeline Parallel,PP) 则是按模型的层(Layer)做纵向切分——把前若干层放在第一组卡、后若干层放在第二组卡,数据像流水线一样依次经过各组。PP的通信量远小于TP(只需在相邻组之间传递激活值),但存在"流水线气泡"问题:当后一组在等待前一组的输出时,GPU处于空闲状态,导致整体利用率下降。TP2 PP4 的混合设计正是为了在通信开销与流水线气泡之间寻找平衡点。
预填充与解码:长文本下的真实瓶颈
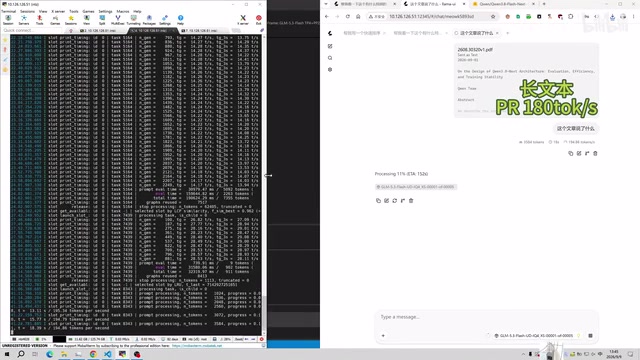
这套系统在处理长文本时的表现更能反映多卡推理的本质特征。UP主用一份33K长度的Qwen3.8-Flash技术报告作为输入实例(他调侃道,找长文本例子还有什么比论文PDF更合适的呢)。
实测数据分成两个阶段:
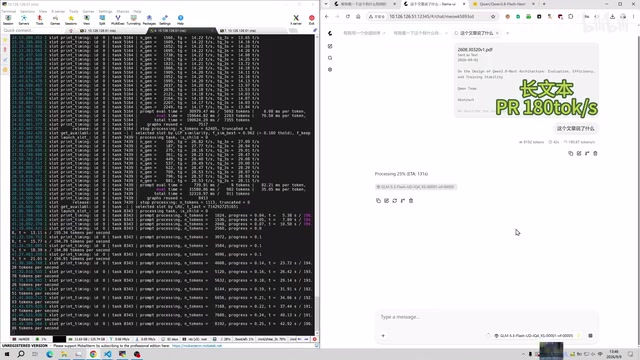
- 预填充(Prefilling)阶段:长文本下降到不到每秒200 token(约180 tok/s)
- 解码(Decoding)阶段:长文本输出速度约为每秒18 token
这里有一个关键的技术观察:Prefilling 对通信的要求远高于 Decoding。当一次性灌入33K的超长上下文时,预填充需要对整段文本做并行计算,跨卡通信压力陡增,因此速度明显被拉低。相比之下解码阶段是逐token生成,通信需求较小,18 tok/s 虽然不算快,但仍在"人类能接受的输出速度下限"之内。
预填充(Prefilling)和解码(Decoding)在计算特征上有本质差异。预填充阶段需要对输入序列中所有 token 同时计算注意力(Self-Attention),其计算量随序列长度呈平方级增长,属于典型的计算密集型操作;而多卡并行时,各卡需要频繁交换中间激活值,通信压力也随序列长度线性放大。解码阶段则是每次只生成一个新 token,可以复用 KV Cache 中已缓存的键值对,属于内存带宽密集型操作,跨卡通信量相对固定且较小。这也是为什么同一套硬件和并行策略下,长文本预填充速度(~180 tok/s)和解码速度(~18 tok/s)会出现接近10倍的落差——二者的性能瓶颈根本不在同一个地方。
关于推测解码的重要提醒
很多人第一反应是用推测解码(Speculative Decoding)或 MTP(Multi-Token Prediction)来给解码加速,但UP主明确强调本次测试没有使用任何推测解码方法。
原因很有针对性:在这种深度层间切分(PP4)的拓扑下,推测解码并不能提供有效的加速比。推测解码的收益依赖于草稿模型快速生成候选token、主模型批量验证,但当模型被切成多段分布在不同卡组、跨卡验证的通信成本很高时,这套机制的收益会被通信开销吃掉。这也解释了为什么在多卡长流水线场景下,单纯堆推测解码技巧未必奏效。
推测解码(Speculative Decoding) 的基本思路是用一个体量小得多的"草稿模型"(Draft Model)快速连续生成若干候选 token,再由主模型一次性并行验证这批候选 token 是否可接受,从而把原本串行的逐token生成转变为批量验证,理论上可以在不损失输出质量的前提下显著提升吞吐。MTP(Multi-Token Prediction)是类似思路的变体,通过训练模型同时预测多个后续 token 来实现加速。这两种方法在单卡或TP较浅的场景下效果明显,但其收益的前提是"验证"步骤的额外通信成本足够低。在PP4这样的深层切分拓扑中,每次验证都需要激活值穿越四组卡的完整流水线,跨组通信延迟抵消了批量验证带来的并行收益,因此加速效果基本归零。
这套方案的启示
这次实测最有价值的地方不在于具体的token速度数字,而在于它清晰展示了多卡本地部署中的几个核心工程决策:
第一,并行拓扑要匹配硬件通信结构。TP2 PP4 之所以有效,是因为它把高频通信约束在组内两卡之间,而非让所有卡都参与全局同步。
第二,预填充和解码是两个性能特征完全不同的阶段。评估一套推理系统时,短文本速度、长文本预填充速度、长文本解码速度需要分开看,任何单一数字都不足以描述完整体验。
第三,加速技巧要看场景。推测解码在单卡或浅并行时效果显著,但在深层流水线切分下可能完全失效——盲目套用"通用优化"未必带来收益。
对于想用低成本二手显卡搭建本地大模型推理平台的爱好者来说,这套8卡2080Ti 22G + TP2 PP4 的方案提供了一个可参考的实践样本:短文本30 tok/s、33K长文解码18 tok/s、预填充180 tok/s,是这套硬件在合理调优后的真实天花板。
相关推荐
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。