9家AI订阅套餐积分换算:每亿Token真实成本揭秘

把主流AI订阅套餐统一换算成每亿Token价格,揭示谁真便宜、谁有坑。
文章基于B站UP主“魔针针”的实测,将火山、阿里、腾讯、百度、智谱、小米、MiniMax等主流AI订阅套餐统一换算为“每亿Token多少钱”,并与官方API价对比得出折扣。核心发现是套餐分固定额度制与三档系数制两类,后者缓存命中越多越省钱,前者缓存不打折;时段折扣和五小时/每周限额会进一步改变实际可用额度。同一套餐换模型Token数可差十几倍,因此选对模型比选对套餐更关键。跑GLM5.3时火山Coding最便宜,跑DeepSeek V4.1 Flash时百度积分制最低而百度Token制最贵。
国内AI订阅套餐花样越来越多,额度单位从“次”到“AFP”到“积分”再到“Credits”,光看宣传页根本比不出谁更便宜。B站UP主“魔针针”把火山、阿里、腾讯、百度、智谱、小米、MiniMax 等主流套餐逐一拆解,统一换算成“每亿Token多少钱”,结论值得每个写代码的人认真看一遍。
两类计费逻辑,决定了缓存省不省钱
市面上套餐基本分两类。第一类是固定额度制:火山 Coding Plan、火山 Agent Plan、百度 Token 制都属于这种,套餐按次、按 AFP 或直接按 Token 给一个定数,不管缓存有没有命中,一个 Token 扣得一样多——缓存不省钱,每月能跑多少 Token 基本是定数。
第二类是三档系数制:阿里、腾讯、百度积分制、智谱、小米、MiniMax 属于这一类。套餐给一个积分或 Credits 额度,每次请求按“未命中输入、缓存命中、输出”三档分别乘系数扣减,缓存命中部分扣得很少,缓存越多越省。关键变量变成:一个积分到底值多少钱。腾讯、智谱、小米官方公布了换算,阿里和 MiniMax 需要自己实测反推。
缓存命中(Cache Hit) 指同一段提示词(如代码文件、系统指令)此前已被模型处理过,服务端保存了中间计算结果(KV Cache),再次请求时可直接复用,无需重新计算,因此成本远低于未命中输入。业内通常将输入 Token 分为“缓存命中”与“缓存未命中”两档计价,命中价可低至未命中的 1/10 甚至更低。对于写代码这类长上下文、重复引用同一仓库的场景,缓存命中率往往高达 90% 以上——这正是三档系数制套餐能大幅省钱的根本原因,也是固定额度制“缓存不打折”被视为劣势的关键。
两条叠加规则:时段折扣与窗口限额
同一套餐的实际额度还会被两条规则改变。一是时段:百度和阿里晚上有折扣,智谱高峰期扣得更多,小米凌晨少扣一点。二是限额:火山、智谱、MiniMax 除月额度外还有五小时和每周上限,集中猛用会提前卡住。
UP主的测算口径是:主要对比 GLM5.3 和 DeepSeek广告 V4.1 Flash,因为同一套餐换个模型 Token 数能差十几倍;结构上写代码时绝大部分输入是缓存命中的,统一按缓存 95%、未命中输入 4%、输出 1% 计算。
各套餐实测:谁在官方价上打了几折
火山:按次扣费,缓存不打折
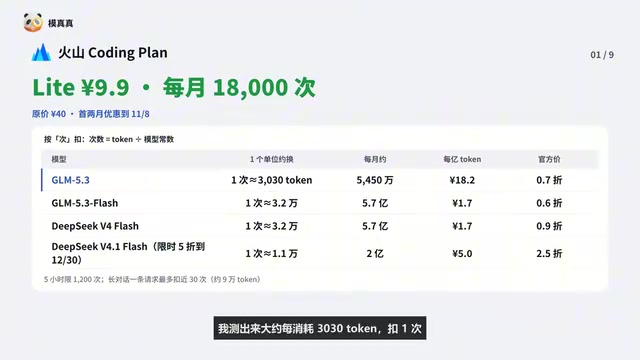
火山 Coding Plan 按次算,Lite 首两月 9.9 元(原价 40),一个月 18000 次。这里的“次”不是消息条数,而是 Token 除以模型常数——GLM5.3 大约每消耗 3030 Token 扣一次,一条 10000 Token 的请求扣约三次。折算下来一个月约 5450 万 Token,每亿 Token 约为官方价的 0.7 折。
火山 Agent Plan 单位叫 AFP,官方公示是公开的输入加输出 Token 乘模型系数再除以 1 万,关键是缓存命中输入也按同样系数扣、不打折,所以缓存命中率再高也不省钱。GLM5.3 系数 4.5,一个月约 4400 万 Token,约为官方价的 0.9 折。
AFP(Agent Fuel Point) 是火山引擎 Agent Plan 使用的额度单位,本质是一种按模型系数折算的“燃料点数”:每次请求按“公开输入 Token + 输出 Token”乘以该模型系数,再除以 1 万得到扣减量。系数因模型而异(文中 GLM5.3 为 4.5),系数越高同样 Token 消耗扣得越多。由于计算时缓存命中输入也乘以同一系数、不享受折扣,AFP 制下提升缓存命中率并不能降低扣费,这一点与积分/Credits 制形成鲜明对比。
百度:Token 制与积分制两条线
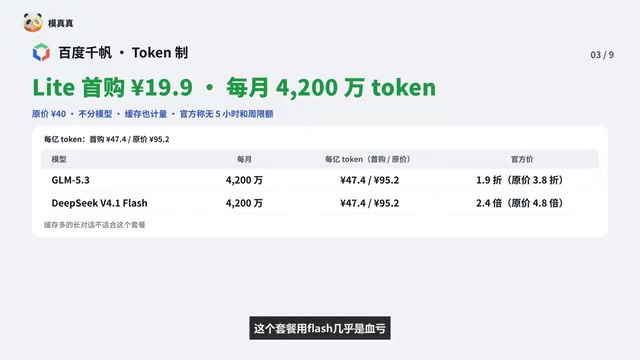
百度千帆 Token 制 Lite 首购 19.9 元(原价 40),每月固定 4200 万 Token,不分模型、缓存也算量。结果是用 Flash 几乎血亏,用最贵的模型才划算——跑 GLM5.3 是官方价的 1.9 折,跑 DeepSeek V4.1 Flash 反而比官方 API 还贵。
百度积分制 Lite 首购 19.9 元(原价 40)给 6600 积分,规则是一积分等于官方 API 高峰价的一分钱。跑 DeepSeek V4.1 Flash 约为官方价的三折,是跑这个模型里最低的;晚上 10 点到早上 8 点部分模型再打两折,每亿不到 1 块钱。
腾讯:积分规则透明,但没有隐藏折扣
腾讯云 Token Plan广告 Lite 档 39 元给 780 多积分,规则公布得很清楚:1 积分 5 分钱,每个模型都按官方 API 原价扣,无任何优惠,各档位积分单价一样,买大档不会更便宜。GLM5.3 原价下一积分只换约 2 万 Token,限时 5.5 折时约 36000。腾讯没有夜间折扣,限时活动过期就是原价。
阿里:积分换算靠实测反推
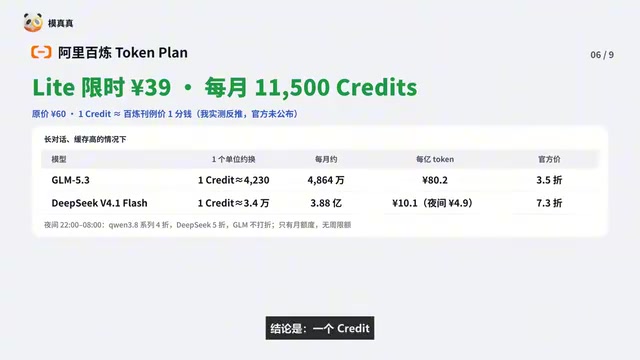
阿里百炼 Token Lite 限时 39 元(原价 60),一个月 11500 Credits,官方没有公布换算方式。UP主实测十多轮反推:一个 Credit 约等于按阿里官网 API 价格算的一分钱。GLM5.3 一个 Credit 约换 4230 Token,约为官方价的 3.5 折;DeepSeek V4.1 Flash 约为 7.3 折;夜间部分型号打折后还能更低。
智谱与小米:规则最清楚,折扣条件明确
智谱规则公布最清楚:Lite 月付 118 元,每周 1 万积分,另外 5 小时限 2000 积分;工作日下午 2 点到 6 点是高峰,其他时间扣一半。GLM5.3 非高峰一个月约 4 亿 Token,高峰约 2 亿。包季每月 94.4 元、包年每月 82.6 元,额度不变。
小米 MiMo Lite 39 元首购 34.3 元,一个月 41 亿 Credits,凌晨 0 点到 8 点只扣 0.8 倍,1 亿 Credits 等于 1 块钱官方 API 价。折算下来基本就是官方价,没有额外折扣。
MiniMax:不公布绝对额度,只能给下限
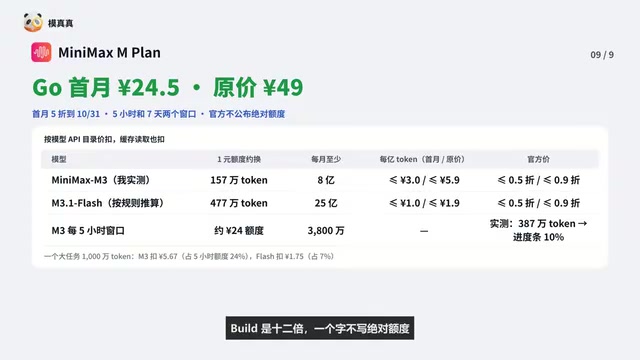
MiniMax M-Plan 首月 5 折活动到 10 月 31 日,有 5 小时和 7 天两个窗口限制。官方只写倍数不写绝对额度,只说按模型 API 目录价扣、缓存读取也扣,控制台只显示百分比。实测跑 M3 每亿 Token 首月价不超过 3 块,约为官方价的不到 0.5 折。
文中反复出现的“官方价”指各模型厂商在 API 目录(如火山方舟、阿里百炼、智谱开放平台)上公布的按 Token 计费单价,是横向比较的基准线。“打几折”即套餐折算后的每 Token 成本占官方 API 单价的比例,0.7 折意味着仅为官方价的 7%。之所以要统一到“每亿 Token 多少钱”,是因为各套餐的额度单位(次、AFP、积分、Credits)量纲不同,且同一额度在不同模型下能换取的 Token 数差异巨大,只有换算成同一货币口径才具备可比性。
排排坐:同一模型谁最便宜
同样跑 GLM5.3,每亿 Token 从低到高大致是:火山 Coding、火山 Agent、智谱非高峰、智谱高峰、百度积分、阿里、腾讯(限时价与原价差距明显)。跑 DeepSeek V4.1 Flash 时排序完全变了:百度积分最低,火山 Coding 和 Agent 紧随其后,阿里白天与夜间有差异,腾讯接近官方价,百度的 Token 制反而是这批里最贵的。
“每亿 Token 多少钱”的横向比较必须锁定同一模型才有意义。原因是不同模型的 Token 计价单价、单次请求的 Token 消耗量、以及套餐系数折算方式都不同,同一份积分在便宜模型上能换到的 Token 数可能是贵模型的十几倍。因此文中分别以 GLM5.3 和 DeepSeek V4.1 Flash 为基准各排一次序,结果排序完全颠倒——这正说明“选对模型”对实际成本的影响,可能超过“选对套餐”。
三点结论与购买提醒
第一,别只看积分数,要换算成每亿 Token 多少钱,再看它是官方价的几折。第二,选对模型比选对套餐更重要,同一个套餐换个模型能差十几倍。第三,折扣要看条件:百度、阿里的夜间折扣实测生效但只限部分模型;腾讯只有限时活动;火山的缓存不打折;MiniMax 官方不公布额度,只能给下限。
这些价格和活动都在变,买之前一定以官网当天页面为准。
(多源交叉验证说明:本文核心数据来自 B 站 UP主“魔针针”的实测视频,各平台计费规则已与官方公示口径对照;阿里、MiniMax 的积分换算为单一来源实测反推,使用时需留意误差。)
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。