阿里Qwen Code仓库泄露Qwen4系列模型:max、coder-plus、omni齐曝光

Qwen Code仓库PR泄露Qwen4系列多个模型ID,暗示阿里下一代模型已在内部测试。
阿里通义千问的Qwen Code代码仓库因两个GitHub PR意外泄露了下一代模型阵容,包括qwen4、qwen4-max、qwen4-plus、qwen4.5-max、qwen4-coder-plus、qwen4-max-2026-10-01和qwen4-omni-120b-think等未发布模型ID。这些ID在指定commit下均解析到262,144的上下文长度,且qwen4-omni-120b-think已被用作测试夹具,说明其在代码层面真实存在并可用于基准测试。命名体系显示阿里继续分层运营通用旗舰(max/plus)、编程专用(coder-plus)和多模态(omni)产品线,日期后缀则暗示存在计划中的发布节点。社区反应以兴奋为主,但理性声音提醒模型ID出现在仓库中不等于即将公开发布,开发者应等待官方确认后再做技术选型。
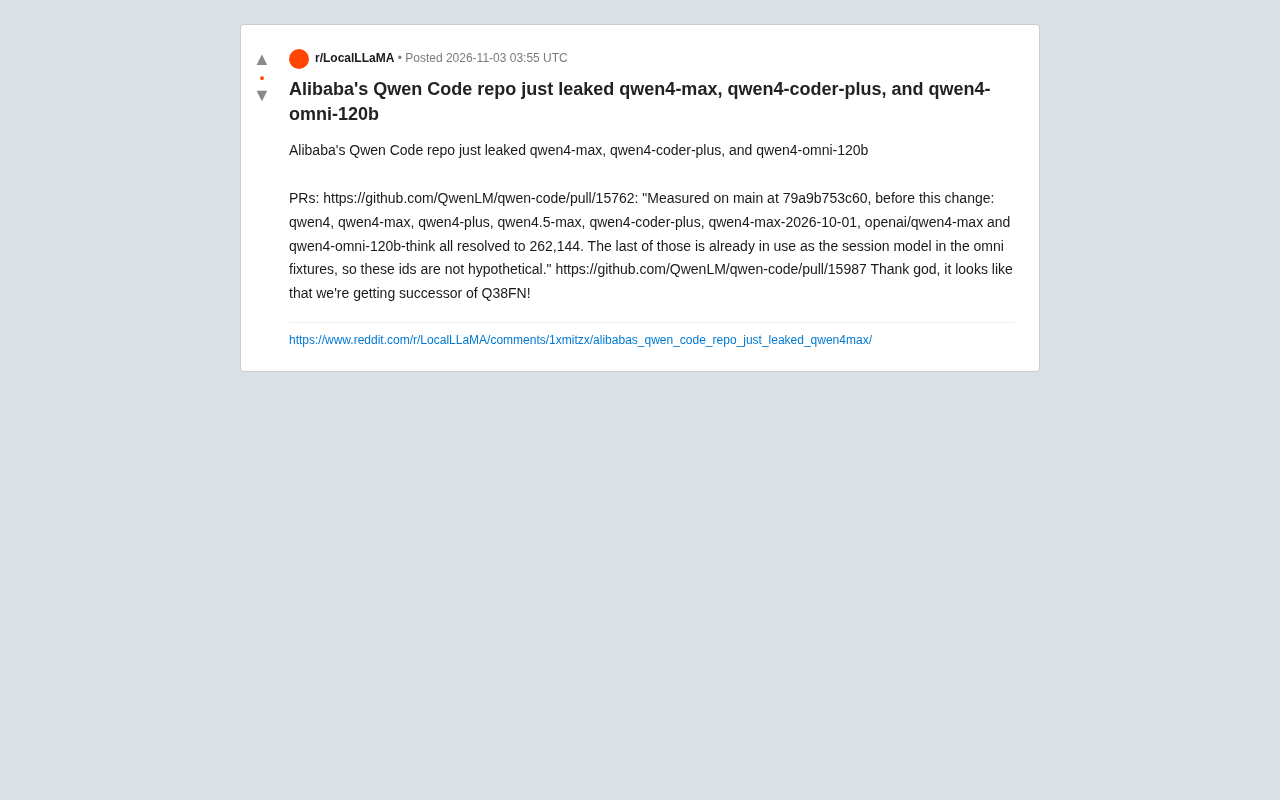
阿里通义千问的Qwen Code代码仓库最近意外泄露了下一代模型阵容。据Reddit社区发现,两个GitHub Pull Request中出现了包括qwen4-max、qwen4-coder-plus和qwen4-omni-120b在内的多个未发布模型ID,暗示Qwen4系列可能已在内部测试甚至准备上线。
泄露内容:一次PR暴露的模型全景
事件的起点是QwenLM/qwen-code仓库中的PR #15762。该PR在描述性能基准时,直接列出了一系列模型ID:qwen4、qwen4-max、qwen4-plus、qwen4.5-max、qwen4-coder-plus、qwen4-max-2026-10-01、openai/qwen4-max以及qwen4-omni-120b-think。
这些ID并非随意编造。PR说明中提到,上述所有模型在指定commit下均解析到262,144的上下文长度,且qwen4-omni-120b-think已经被用作omni测试夹具(fixtures)中的会话模型。换句话说,这些模型ID至少已经在代码层面真实存在并被引用,而不是假设性的占位符。
另一个PR #15987也被社区关联到此次泄露,有用户评论称"看起来我们终于要迎来Q38FN的继任者了"。虽然该PR的具体内容未在素材中详述,但两个PR的时间接近,进一步强化了Qwen4系列正在推进的判断。
Pull Request(PR) 是 GitHub 等代码托管平台上的核心协作机制:开发者从主仓库派生(fork)出自己的副本,在独立分支上修改代码后,向原仓库发起合并请求,由维护者审核、讨论并决定是否合入主干。PR 的描述、讨论串和代码差异(diff)全部公开可查,因此团队在 PR 中做基准测试对比、记录 commit 哈希、引用模型端点时,很容易把本不打算公开的内部信息——例如尚未发布的模型 ID——一并暴露出去。这也是本次泄露的直接成因:PR 原本只是描述性能基准的上下文,却顺带列出了完整的内部模型清单。
测试夹具(fixtures) 是软件测试中的固定数据或环境,用于让测试可重复执行。在调用大模型的应用中,夹具往往包含一个真实的模型端点或模拟响应,测试运行时直接向该端点发请求。因此某个模型 ID 被用作夹具,意味着它在某个内部环境里至少是可调用的,比单纯在文档或配置中出现更具可信度。
命名体系透露的产品路线
从泄露的ID可以读出阿里对Qwen4家族的产品分层思路。
Max与Plus构成通用旗舰梯队。 qwen4-max和qwen4-plus延续了Qwen3时代的命名逻辑,分别对应最高能力和均衡版本。qwen4.5-max的出现则暗示阿里可能在同一个大版本内做小版本迭代,类似"4.5"这样的中间版本在以往Qwen系列中并不常见,值得关注。
Coder-Plus瞄准编程场景。 qwen4-coder-plus的命名表明阿里继续将编程能力作为独立产品线运营。结合qwen-code仓库本身是面向代码场景的工具,coder系列与代码仓库同步更新符合逻辑。
Omni-120b指向多模态。 qwen4-omni-120b-think中的"omni"通常代表全模态(文本、图像、音频等),"120b"暗示参数量级,"think"后缀则可能对应推理模式。这个命名组合显示阿里在多模态和推理能力的融合上继续加码。
日期后缀暴露发布节奏。 qwen4-max-2026-10-01带有明确的日期标记,这类带日期的模型ID通常用于快照版本管理,可能意味着该模型对应某个计划中的发布节点。
上下文长度(context length) 指模型单次推理能处理的最大 token 数(token 是模型处理文本的基本单位,约等于一个词或词的一部分)。262,144 即 256K token,意味着模型理论上可一次性读入约数十万字的材料,适用于长文档分析、大型代码库理解等场景。上下文窗口越长,对显存和注意力计算的开销要求越高,因此长上下文能力通常与模型架构和推理优化方案绑定。需要注意的是,标称上下文长度与模型在该长度下的实际有效表现(如“迷失在中间”问题)并不等同,实际可用长度往往需独立评测验证。
上下文长度:262,144的统一规格
PR描述中一个关键数据是:所有列出的模型ID都解析到262,144的上下文长度。这个数字如果属实,意味着Qwen4系列在上下文窗口上保持了与当前主流长上下文模型一致的水平。
更有意思的是,PR的语境是在讨论某个改动前后的基准表现,说明这些模型已经进入了可测量、可对比的性能评估阶段。一个模型ID能被用于基准测试,通常意味着它至少已经完成了基础训练并具备推理能力。
社区反应与可信度评估
Reddit社区对这次泄露的反应以兴奋为主,但也有理性的声音。有用户指出,模型ID出现在代码仓库中并不等同于模型即将公开发布——内部测试用的ID可能提前数月甚至更久存在于代码中。
不过,qwen4-omni-120b-think已用于测试夹具这一细节提高了泄露的可信度。测试夹具通常需要与实际可调用的模型端点对接,这意味着该模型ID至少在某个内部环境中是真实可用的。
从历史看,Qwen系列此前也有过模型信息提前泄露的情况,而阿里通常会按自己的节奏推进发布。这次泄露更像是一次意外的"预告",而非官方预热。
模型 ID 与 API 端点 是两个不同层面的东西。模型 ID 只是内部注册表或网关配置中的一个字符串键名,用于路由请求、做 A/B 测试或版本快照;而面向开发者的 API 端点还需要经过配额、计费、速率限制、合规审核、文档与 SDK 适配等一系列上线流程。因此代码仓库里出现模型 ID,通常早于公开发布数月,也可能因内部评估未达预期而被废弃或改名。判断泄露信息可信度时,关键看它是否被实际调用(如测试夹具),而非仅出现在注释、配置或占位符中。
对开发者的意义
对使用Qwen系列模型的开发者来说,这次泄露提供了几个实用信号。Coder-Plus的持续存在说明编程辅助仍是阿里重点投入的方向,qwen-code工具链的更新节奏值得跟踪。Omni系列若延续多模态路线,可能为需要统一处理文本与视觉输入的应用提供新选择。
至于这些模型何时正式发布、实际能力如何,目前没有任何官方信息。泄露的ID和上下文长度只能作为参考,真正的性能表现还需要等待官方基准和独立评测。
在官方确认之前,建议开发者保持关注但不要基于泄露信息做技术选型决策。毕竟,代码仓库里出现的模型ID距离可稳定调用的API还有相当距离。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。