阿里云栖三颗炸弹:Qwen4、真武V900与20GW数据中心背后的成长豪赌
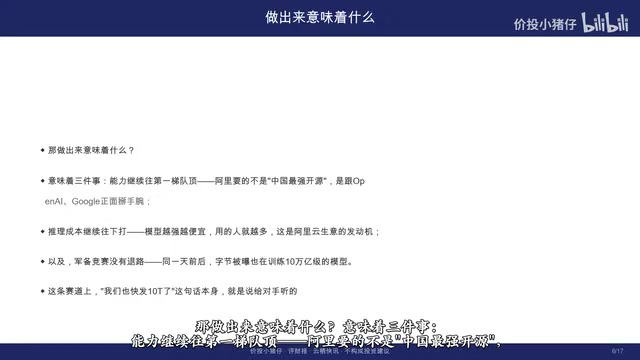
阿里云栖大会抛出万亿参数模型、自研AI芯片和20GW算力三颗"期货炸弹",构成重资产全栈闭环。
9月22日云栖大会上,阿里巴巴一日之内发布三项重磅计划:Qwen4将冲向5至10万亿参数(仍处训练阶段)、自研AI芯片真武V900性能三倍于上代并计划2027年量产、以及到2032年全球数据中心规模超过20GW(约需投入1.6至1.7万亿元)。三者构成模型即需求、芯片即供给、数据中心即容量的全栈自研闭环,是阿里把AI每一层利润留在自身体系内的战略表达。但三颗"炸弹"均指向未来:参数还在训练、芯片要等一年半、电力目标跨越六年,均为期货而非现货。市场反应冷静,港股当日涨幅不足2%;而前瞻市盈率约46倍、远高于静态19倍的估值结构,则表明资本市场已将阿里定性为高投入成长股而非稳定收息的公用事业。
9月22日的杭州云栖大会,阿里巴巴一天之内抛出三个足以搅动行业的重磅消息:面向5万亿到10万亿参数的新一代千问大模型、性能约为上一代三倍的自研AI芯片真武V900,以及到2032年全球数据中心规模超过20GW的算力扩张计划。
这三条消息在标题里都极具冲击力,但真正的信息藏在细节里。本文按照读财报的标准来拆解——先验真,再算含金量,看看这三颗炸弹究竟是现货还是期货。
第一颗炸弹:Qwen4冲向10万亿参数
阿里CEO吴泳铭在台上表示,未来模型将扩展至5万亿到10万亿参数,对应的是正在全面训练中的新一代千问模型。这里要盯住一个关键时态——是「正在训练」,不是「已经发布」。对投资者而言,这个区别就是期货与现货的差别。
5到10万亿参数是什么量级?作为参照,阿里自己8月刚发布的开源旗舰Qwen3.8 Max为2.4万亿参数,月之暗面的Kimi K3约2.8万亿,被不少人视为国产标杆的DeepSeek广告 V3仅6700亿。如果Qwen4真达到5至10万亿,等于把上个月的自家纪录再翻2到4倍。
当然,参数不等于能力。稀疏模型的总参数和每次回答真正调用的激活参数是两回事,10万亿的「个子」可能只派3000亿的「力」。但参数竞赛打到这个数字,至少说明业界还没人相信规模定律到头了。据报道,同一时期字节跳动也被曝在训练10万亿级模型——这条赛道上,「我们也快发实体了」这句话本身就是说给对手听的。
稀疏模型(Sparse Model)与混合专家架构(MoE,Mixture of Experts)是理解这一参数数字的关键背景。传统的「稠密模型」每次推理都激活全部参数,而MoE架构将模型切分为大量「专家」子网络,每次推理只路由激活其中一小部分。这意味着一个标称10万亿参数的MoE模型,单次前向传播实际调用的激活参数可能只有1000亿到3000亿量级,推理成本与同等激活量的稠密模型相当,但训练时能让更多参数习得更细分的知识表示。DeepSeek V3(6710亿总参数,每次激活370亿)和Qwen3的MoE版本均采用此路线。因此在横向比较中,「总参数」只是容量上限,「激活参数」才是推理算力的真实账单。报道Qwen4时,若阿里届时公布激活参数比例,那才是衡量推理成本与性能权衡的核心数据。
第二颗炸弹:平头哥真武V900
平头哥正式发布新一代AI芯片真武V900,采用训推一体架构,性能约为上一代真武M890的三倍,配备216GB显存,单集群可扩展至50万卡,计划2027年一季度量产。媒体标题中「中国性能最强自研AI芯片」的说法是官方发布口径,目前尚无第三方测评,听听即可。
同场还首次透露了CPU路线图:下一代倚天服务器芯片单核性能最高提升1.4倍。真武系列的出货数据也从此前官方口径的47万片更新为56万片以上,意味着半年内净增约10万片。
V900的含金量不在「最强」二字,而在三点:三倍性能让自研卡对外购芯片的性价比再上一档;2027年一季度量产意味着未来一年半这块资产仍是「没有报表的资产」;而自研芯片、自研模型、自建数据中心三级全凑齐,阿里是目前中国唯一。
「训推一体架构」是V900区别于上一代的核心设计理念,值得展开说明。AI芯片历史上长期存在训练芯片(如英伟达A100/H100,侧重FP16/BF16高吞吐浮点计算)与推理芯片(侧重INT8低精度、低延迟、低功耗)的分工。训练需要大量高精度梯度计算和巨大显存带宽;推理则追求单位功耗的token吞吐量。两类芯片混用导致数据中心需维护两套硬件生态,运维复杂度高。「训推一体」意指同一块芯片在精度支持、显存容量和互联带宽上同时满足两种场景的需求,从而简化采购、降低闲置率。V900配备的216GB显存正是为了支撑训练时的大批次梯度和推理时的大模型权重常驻。能否真正做到两端性能不互相妥协,是第三方测评最需要验证的指标。
第三颗炸弹:20GW数据中心
先把口径掰正——不是阿里要建一个20GW的数据中心(那会是能源事故),而是吴泳铭所说的「到2032年,阿里云广告运营的全球数据中心规模超过20GW」。目前阿里的规模约为3到4GW,意味着六年内把算力底座翻5到6倍。
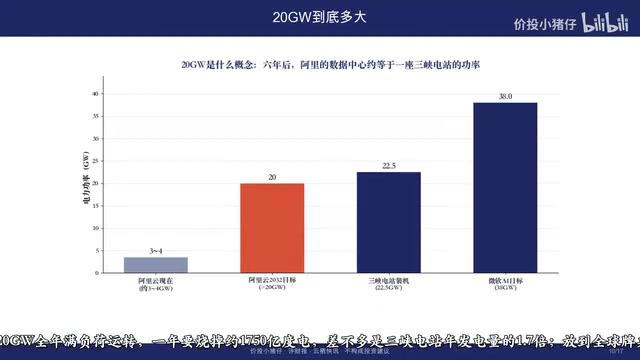
当天媒体测算,这需要投入约1.6万亿到1.7万亿元,比去年底那轮「3800亿、三年」的资本开支计划直接大了一个数量级。20GW约等于三峡水电站总装机(22.5GW)的规模,若全年满负荷运转,一年要烧掉约1750亿度电,差不多是三峡年发电量的1.7倍。作为横向参照,微软给自己定的目标是38GW——20GW既不夸张,也不保守,是阿里在全球AI军备竞赛账单上填的数。
「GW(吉瓦)」在数据中心语境中指的是IT负载功率(或PUE折算后的总用电功率),而非建筑面积或机架数量,是衡量超大规模数据中心体量最通用的国际口径。1GW约等于100万千瓦,可容纳约10万至20万块高端GPU(取决于单卡TDP和机柜密度)。阿里当前3至4GW对应的是其现有云基础设施的总电力规模;微软38GW和谷歌、亚马逊各自数十GW的目标,是近两年「AI军备竞赛」推动下全球头部云厂商普遍公布的长期容量规划。值得注意的是,20GW是「运营规模」目标,包含自建和租用的机房,并非全部为新建绿地项目;实际资本开支会因租赁比例、地区电价和建设周期而有较大弹性,1.6至1.7万亿的估算是媒体基于单位造价的粗算,阿里官方尚未给出分年度的资本开支拆分。
三颗炸弹拼成一个闭环
把三条消息拼起来,其实是一句话:模型是需求,芯片是供给,数据中心是容量。Qwen4越肥,V900越急;V900越猛,20GW越省不了。这是一个咬合的闭环,也是阿里「全栈自研、把AI每一层利润都留在自己锅里」的野心。
但投资人的问题很直接:这等于把阿里从轻资产的平台,改写成重资产的军火商。阿里自由现金流已连续几个季度为负,账上现金约4700亿,而接下来六年可能要每年花掉2000多亿。豪赌的底气有,但不是无限的。
当天市场反应相当冷静——港股阿里巴巴收报114.8港元,涨幅不到2%,没有狂欢。市场想说的很清楚:钱先烧出去,回报再说。
为什么这是成长股,不是公用事业
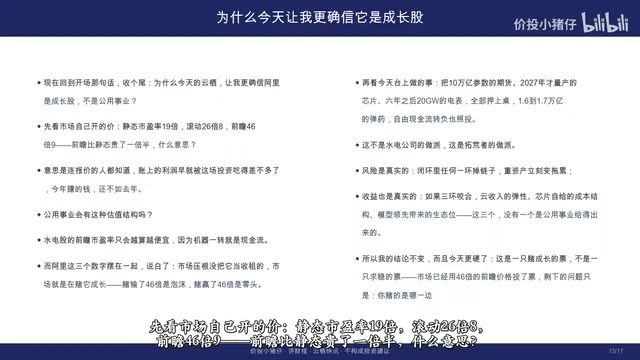
很多人把阿里当成一只稳稳收租的「水电股」,按价值股估值。但估值结构给出了相反的信号:静态市盈率约19倍,前瞻市盈率却约46倍。前瞻比静态贵了一倍半,意味着连报价的人都知道,账上利润已经被这场投资吃得差不多了——今年赚的钱还不如去年。
公用事业不会有这种估值结构。水电股的前瞻市盈率只会越算越便宜,因为机器一转就是现金流。而阿里把10万亿参数的「期货」、2027年才量产的芯片、六年后20GW的电表,加上1.6到1.7万亿的弹药和转负的自由现金流全压上桌——这不是收租的做派,而是拓荒者的做派。市场用46倍的前瞻价格,赌的正是它的成长。
接下来盯两个节点
这场豪赌风险真实:闭环里任何一环掉链子,重资产立刻变拖累。收益也真实:三环咬合的话,云收入的弹性、芯片的成本结构、模型领先带来的生态位,没有一个是公用事业给得出来的。
对投资者而言,后续只需盯两个节点:第一,Qwen4发布时能力究竟跨了几级,这决定20GW是资产还是负担;第二,2027年一季度V900量产的良率和成本,这决定平头哥那本「没有报表的账」何时开始计分。
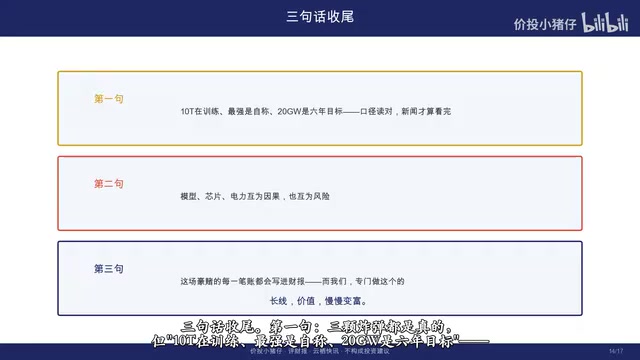
三句话收尾——三颗炸弹都是真的,但实体在训练、最强是自称、20GW是六年目标,把时态和口径读对才算看完新闻;模型、芯片、电力互为因果也互为风险,这是成长股的配方;把它当水电股收息的人,和把它当成长股下注的人,看的根本不是同一家公司。
本文为公开信息的新闻解读与个人研究记录,不构成投资建议。文中转述的公司目标均为管理层预期,存在不确定性。数据截止2026年9月22日,来源包括吴泳铭云栖大会演讲、平头哥发布及中国证券报、财联社、新浪科技等现场报道。
相关推荐
AI游戏做得烂,问题不在AI而在你
一篇Reddit热帖指出:借助AI生成的游戏之所以质量差,问题不在AI而在开发者。AI能写代码却判断不了游戏是否好玩,测试与迭代打磨依然是人的责任。本文解析AI时代创作者面临的真正分水岭。
入门聊天机器人开发:RAG技术栈需要哪些编程语言
想用 RAG 技术开发聊天机器人却不知从何学起?本文梳理 Python、JavaScript 等编程语言的选择逻辑,解析 RAG 技术栈核心流程,并给出新手学习资源与实践建议。
百万级上下文窗口的工程挑战:VRAM碎片与动态KV缓存
百万级上下文窗口对大模型推理提出严峻的显存挑战。本文解析VRAM碎片化与动态KV缓存两大工程难题,探讨分页式缓存、显存池、分层卸载等架构应对策略。