AAAI顶会论文造假被接收,学术审查体系引质疑

Reddit爆料有人编造数据将论文送入AAAI,暴露顶会评审对数据真实性的结构性盲区与学术激励扭曲。
文章从Reddit爆料切入:一位研究者为提升实验指标直接编造数据,论文被AAAI接收,而爆料者踏实研究的论文仅被ACL接收,引发对评审公平性的愤怒。文章分析认为,顶会同行评审依赖人工评估论文文本,审稿人通常无法要求原始数据或复现实验,形成结构性盲区;小幅篡改真实结果比凭空捏造更难识别,导致造假成本低、收益高。更深层的问题在于学术激励扭曲——顶会论文标签在博士申请中权重过高,而数据真实性追溯机制缺位。文章最后讨论代码开源、复现清单和统计异常检测等改进方向,但指出这些措施受审稿成本与可复现性限制,治理需要制度层面的长期设计。
事件回顾:一篇编造数据的论文如何登上顶会
据Reddit网友爆料,其朋友在做差距分析(gap analysis)项目时,发现自己的实验结果与原论文相比提升有限,于是直接编造并抬高了各项指标数据,最终这篇论文被AAAI接收。爆料者对此感到极度愤怒和失望——他本人与另外两位合作者曾为一个优化课题付出巨大努力,最终论文被ACL接收,但看到有人靠造假进入更好的会议,内心难以平衡。
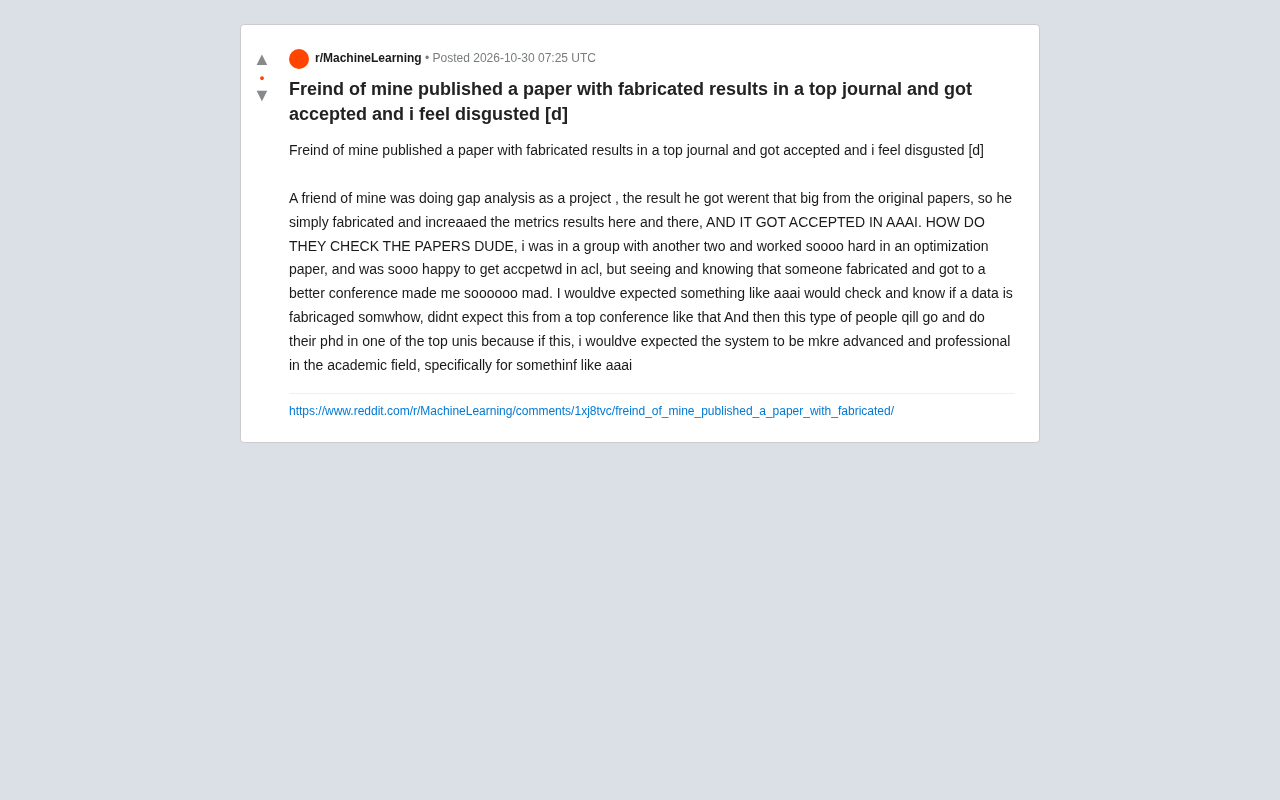
这一事件的核心矛盾在于:顶会的同行评审机制为何没能识别出明显的数据编造?爆料者原本期待AAAI这样的顶级会议会有某种数据真实性核查手段,但现实显然令他失望。
AAAI(Association for the Advancement of Artificial Intelligence)是人工智能领域的顶级国际会议之一,与中国计算机学会(CCF)推荐的A类会议列表中的IJCAI、NeurIPS、ICML等齐名,每年投稿量巨大而录用率通常在20%左右甚至更低。ACL(Association for Computational Linguistics)则是自然语言处理领域的顶级会议,同样属于CCF-A类。两者虽同处顶会层级,但侧重点不同:AAAI覆盖AI的广泛方向,ACL聚焦计算语言学与NLP。在学术评价中,不同顶会的“含金量”常被粗略比较,这也正是爆料者感到不平衡的背景——他认为造假者进入了“更好的会议”。
同行评审的盲区:为什么造假难以被发现
AAAI、ACL等顶会的审稿流程主要依赖同行专家对论文的创新性、方法论和实验逻辑进行人工评估。审稿人通常不会、也难以要求作者提供原始数据或代码复现结果——除非论文本身存在明显的逻辑漏洞或数据矛盾。
这就形成了一个结构性盲区:如果作者只是把指标“改得好看一点”,而没有留下明显的统计异常,审稿人几乎无法仅凭论文文本判断数据是否真实。爆料者的朋友正是利用了这一点——他没有凭空捏造整个实验,而是在真实结果的基础上“稍微调整”了数字,这种程度的篡改极难被人工审稿识别。
更关键的是,顶会投稿量巨大,审稿人时间有限,要求他们对每一篇论文的实验数据进行深度核查并不现实。这使得学术不端的成本极低,而收益却可能非常可观。
同行评审(peer review) 是学术出版的核心质量把关机制,通常采用双盲或单盲形式:审稿人不知道作者身份(双盲),或作者不知道审稿人身份(单盲)。顶会审稿一般由程序委员会组织,每篇论文分配2-4名审稿人,依据创新性、技术正确性、实验充分性等维度打分。然而,同行评审本质上是对论文文本的评估,而非对实验过程的审计。审稿人默认作者诚实报告结果,这种“信任前提”是评审效率的基础,却也构成了被滥用的空间。此外,可复现性(reproducibility) 危机在AI领域日益受到关注,多项调查显示大量论文的实验结果难以复现,但系统性的复现检查仍非常态。
学术激励的扭曲:造假者为何能进入顶尖项目
爆料者提到一个令人不安的现实:这类通过造假获得顶会论文的人,往往能凭借这些“成果”申请到顶尖大学的博士项目。这暴露了学术评价体系中的一个深层问题——论文数量与会议等级在招生和招聘中权重过高,而数据真实性的追溯机制却严重缺位。
当发表记录成为衡量研究能力的核心指标,而造假行为又缺乏有效监督时,学术激励就发生了扭曲。踏实做研究的人可能需要数年才能积累一篇顶会论文,而投机者通过编造数据可以在短时间内获得同样的“标签”。这种不对称的回报结构,正在侵蚀学术共同体的信任基础。
爆料者的愤怒不仅源于个人努力被轻视,更源于对整个系统公平性的质疑。他原本相信学术领域“更加先进和专业”,但现实给了他相反的答案。
学术激励结构指学术共同体通过发表、引用、项目经费和职位晋升等信号来分配资源和声誉的机制。在计算机科学领域,会议论文(尤其是顶会)是主要的成果形式,这与许多学科以期刊为主的传统不同。博士招生委员会在筛选申请者时,往往将顶会论文数量与等级作为研究潜力的强信号,因为本科或硕士阶段能产出顶会论文确实稀缺。但这种信号的有效性依赖于论文的真实性——一旦造假成本低于被发现的概率与惩罚的乘积,信号就会失真,出现经济学中的“劣币驱逐良币”效应。学术不端(research misconduct) 包括编造(fabrication)、篡改(falsification)和剽窃(plagiarism),其中编造和篡改数据是最难被文本审稿发现的形式。
可能的改进方向与困境
要解决这一问题,学术界并非没有工具。代码与数据开源、可复现性检查、审稿过程中的统计异常检测,都可以提高造假的被发现概率。部分会议已经开始要求作者提交复现清单或代码链接,但这些措施的执行力度和覆盖面仍然有限。
困境在于:强制数据核查会大幅增加审稿成本,也可能引发隐私和知识产权方面的争议。此外,很多实验涉及大规模计算资源或专有数据,完全复现并不现实。如何在保证审稿效率的同时提升数据可信度,是顶会组织者面临的真实挑战。
从更宏观的层面看,学术不端的治理需要制度设计——包括对已发表论文的事后抽查、对造假行为的明确惩戒机制,以及评价体系中降低对“顶会标签”的过度依赖。这些改变不会一蹴而就,但每一次类似事件的曝光,都在推动学术界正视这一问题。
对于爆料者而言,他的愤怒是合理的。一个靠编造数据进入AAAI的人,不仅伤害了同行的信任,也可能在未来的博士研究中继续这种模式。学术体系的专业性,正需要在这样的质疑声中接受检验。
可复现性检查在近年顶会中已有初步实践,例如NeurIPS自2019年起推行“可复现性检查清单”(Reproducibility Checklist),ML Reproducibility Challenge鼓励独立团队复现论文;ACL系列会议也逐步要求提交代码与数据可用性声明。统计异常检测则是另一条思路:通过Benford定律、过于完美的数值分布或方差异常等统计方法筛查可疑数据,但这类方法在样本量小、指标本身就波动大的AI实验中误报率高,尚难作为常规审稿工具。事后抽查(post-publication audit) 和撤稿机制在期刊界相对成熟,会议论文因缺乏持续编辑流程而难以实施。根本矛盾在于:审稿是志愿性、时限性的劳动,而深度核查需要额外的时间、算力与专业知识,成本由谁承担尚无共识。
相关推荐

Heretic 2.0 发布:从去审查到通用模型修改工具
Heretic 2.0 正式发布,新增任意秩消融(ARA)算法与插件系统,从去审查专用工具进化为可抑制废话、降低谄媚、调整情感对齐的通用模型修改平台。37k GitHub 星标,Hugging Face 衍生模型超 8500 个。
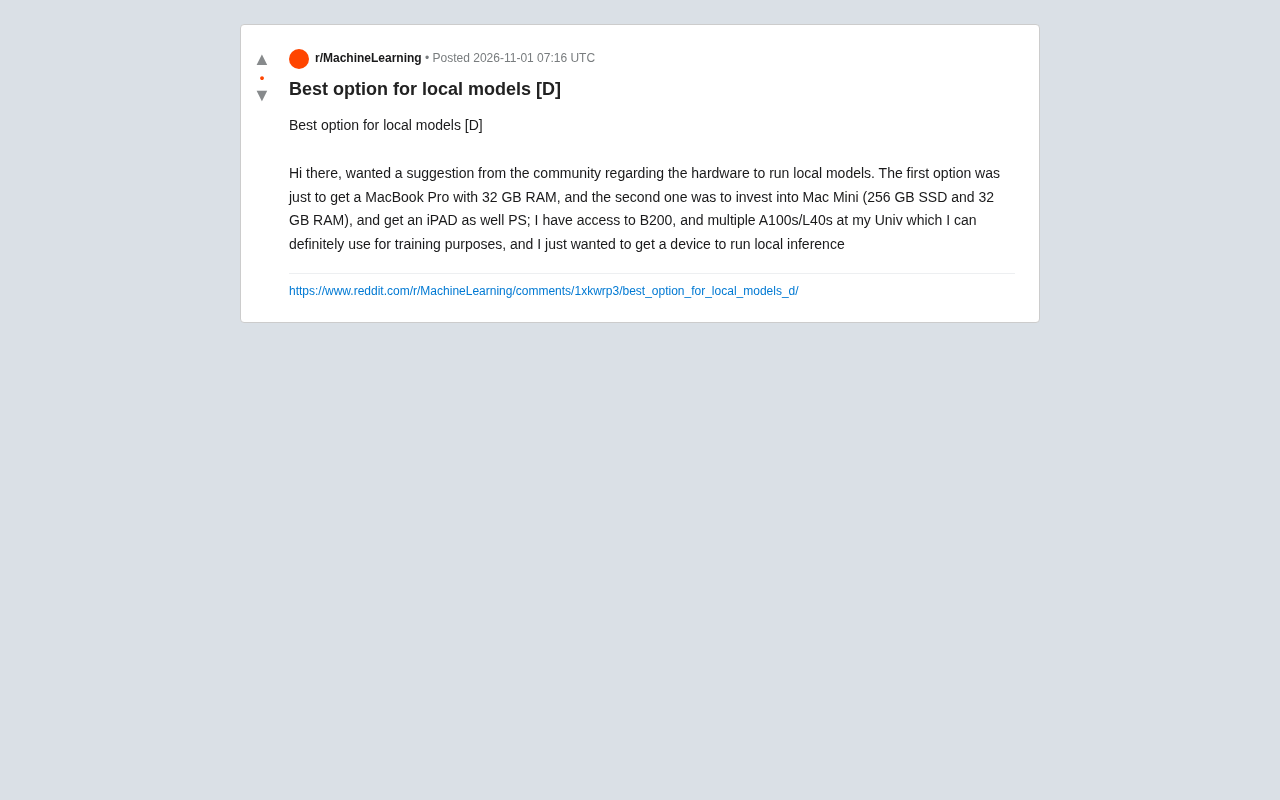
本地大模型硬件怎么选?MacBook Pro vs Mac Mini+iPad深度对比
Reddit社区热议本地大模型硬件选择:32GB MacBook Pro与Mac Mini+iPad组合如何取舍?本文从便携性、性价比、内存需求等角度深度分析,帮你找到最适合本地推理的设备方案。

AI Agent失败溯源:如何定位错误决策的根因?
Reddit讨论聚焦AI Agent失败溯源难题:如何定位导致Agent做出错误决策的根因?分析LangSmith、LangFuse等可观测性工具的局限,探讨手动分析与自建分析系统的实践组合,为Agent可靠性提升提供思路。