ACN智能体上下文网络:AI Agent安全共享上下文的开源方案解析
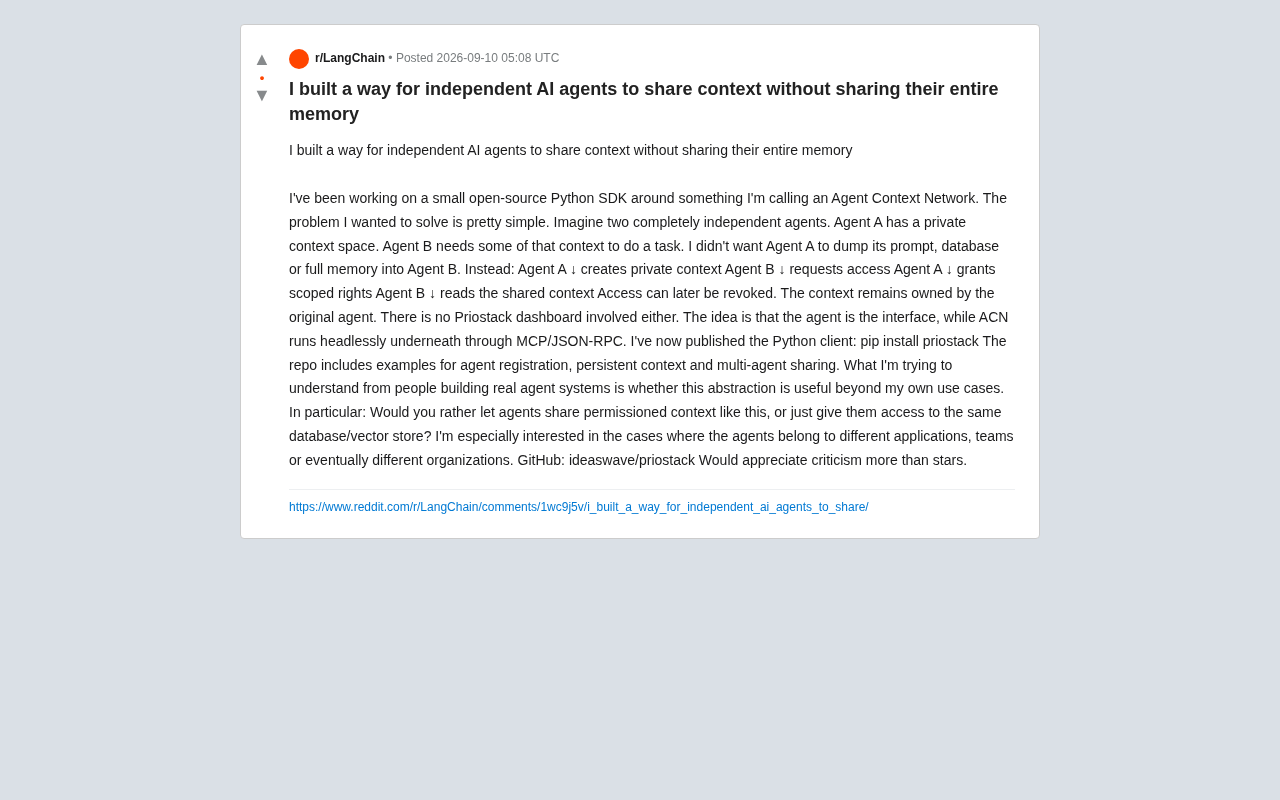
ACN提出基于权限控制的多智能体上下文安全共享方案
随着多智能体协作成为趋势,智能体间上下文信息的安全共享成为核心难题。传统共享数据库方案缺乏细粒度权限控制,存在安全隐患。一位开发者开源了Agent Context Network(ACN)方案,借鉴操作系统权限管理思想,实现所有权不转移、权限可细分、授权可撤销的上下文共享机制,基于MCP协议无头化运行,面向跨组织智能体协作的未来趋势。
一个被忽视的多智能体协作难题
随着AI智能体(Agent)系统从单体走向协作,一个根本性的问题浮出水面:当两个独立的智能体需要协同工作时,它们该如何交换信息?
AI智能体不同于传统的聊天机器人——它是能够自主感知环境、做出决策并执行行动的软件系统,具备目标驱动、工具调用和自主规划的能力。从技术演进的角度看,AI智能体的概念可追溯到人工智能早期的BDI(信念-愿望-意图)模型,但真正进入工程实践是在2023年AutoGPT引发的Agent热潮之后。当前主流的智能体架构通常包含四个核心模块:感知层(接收输入)、规划层(任务分解与推理)、记忆层(短期工作记忆与长期知识存储)和行动层(调用外部工具与API)。ReAct、Plan-and-Execute、Reflexion等推理范式为智能体提供了不同的决策策略。
2024年以来,随着大语言模型能力的飞跃,业界从单一智能体迅速演进到多智能体协作架构,AutoGen、CrewAI、LangGraph等框架的涌现正是这一趋势的具体体现。其中,AutoGen(微软)采用对话驱动的多智能体协作模式,智能体之间通过结构化对话完成任务流转;CrewAI则引入了"船员"隐喻,强调角色定义和流程编排;LangGraph基于有向图模型构建智能体工作流,提供了更精细的状态管理和条件分支控制。这些框架各有侧重,但在上下文共享层面普遍依赖共享内存或消息队列等传统方案,缺乏原生的细粒度权限控制能力。
在多智能体架构下,不同智能体各司其职(如一个负责信息检索、一个负责代码生成、一个负责质量审核),通过分工协作完成单一智能体难以胜任的复杂任务。然而,多智能体协作远比单智能体运行复杂,其中最基础也最棘手的问题之一,就是智能体之间的上下文信息如何安全、高效地流动。
目前主流的做法简单粗暴——让所有智能体共享同一个数据库或向量存储。但这种方式在真实生产环境中隐患重重。近期,一位开发者在 Reddit 上分享了他的开源方案,试图从架构层面解决这个问题。他构建了一个名为 Agent Context Network(ACN,智能体上下文网络) 的 Python SDK,核心目标只有一个:让智能体在不暴露全部记忆的前提下,按需共享上下文。
作者在帖子结尾写道:"比起点赞,我更希望收到批评。"这种务实的态度,恰恰反映了当前多智能体基础设施仍处于早期探索阶段的现实。
传统共享方案的困境与ACN的解决思路
为什么共享数据库行不通
设想这样一个场景:智能体 A 拥有一片私有的上下文空间(可能包含它的提示词、历史对话、数据库记录)。此时智能体 B 需要其中的一小部分信息来完成任务。
如果按照"共享同一数据库"的思路,意味着:
- 智能体 A 必须把它的提示词、数据库或完整记忆全部暴露给 B
- 一旦某个智能体被攻破,攻击面覆盖整个共享存储
- 无法做到细粒度的权限控制,更谈不上事后撤销
这里有必要理解向量存储(Vector Store)在AI系统中的角色。向量存储是专为高维向量数据设计的数据库系统,如Pinecone、Weaviate、Chroma和Milvus等。在AI应用中,文本、图片等非结构化数据会被大语言模型转化为高维向量(即嵌入/Embedding),存入向量数据库后可通过语义相似度进行快速检索,这是RAG(检索增强生成)架构的核心组件。当多个智能体共享同一个向量存储时,实质上是所有智能体的记忆、对话历史和知识库被混合存放在同一个数据池中——任何一个智能体都有可能检索到其他智能体的私有信息,缺乏天然的隔离机制。
这在同一个应用、同一个团队内部或许勉强可行,但一旦智能体分属不同应用、不同团队,甚至不同组织,这种"裸奔式"共享就完全站不住脚了。跨组织智能体协作并非遥远的愿景——一家电商企业的订单处理智能体可能需要与物流公司的调度智能体、支付平台的风控智能体实时协同。订单智能体需要向物流智能体分享收货地址和包裹信息,但绝不应暴露客户的支付记录和浏览历史。类似的场景还包括:医疗AI系统中,诊断智能体向药房智能体共享处方信息但隐藏完整病历;金融领域中,合规审查智能体向交易智能体提供风险评级但不暴露审查模型细节。这些场景都要求上下文共享是精确可控的,而非全有或全无的二元选择。
ACN如何实现细粒度上下文共享
作者提出的模型引入了一套类似操作系统权限管理的机制。这一类比并非表面相似——在Unix/Linux文件系统中,每个文件都有所有者(owner)、所属组(group)和其他用户(others)三级权限控制,且权限类型细分为读(r)、写(w)和执行(x)。更现代的RBAC(基于角色的访问控制)和ABAC(基于属性的访问控制)模型则提供了更灵活的权限策略。ACN将这一成熟范式引入智能体世界,实质上是将数十年操作系统安全工程的经验移植到AI基础设施中。
整个流程可以拆解为四步:
- 智能体 A 创建私有上下文 —— 数据的所有权始终归属于原始智能体
- 智能体 B 发起访问请求 —— 主动申请特定范围的上下文
- 智能体 A 授予受限权限(scoped rights) —— 只开放必要部分,而非全部
- 智能体 B 读取共享上下文 —— 在授权范围内使用数据
关键在于,这种授权是可撤销的。上下文的所有权永远不会转移,A 随时可以收回 B 的访问权限。这与"复制一份数据丢给对方"有着本质区别——它更接近于"借阅"而非"赠予"。所有权不可转移、权限可细分、授权可撤销,这三条原则构成了最小权限原则(Principle of Least Privilege)在智能体场景中的具体实现,即每个智能体仅获得完成其任务所需的最少信息访问权限,不多也不少。
ACN技术架构:基于MCP协议的无头化设计
作者刻意强调了一个设计哲学:没有中心化的仪表盘(dashboard)。
在很多现有方案中,多智能体协作往往依赖一个可视化控制台来管理权限和数据流。而 ACN 的定位完全不同——智能体本身就是接口,ACN 则通过 MCP(Model Context Protocol)/ JSON-RPC 在底层"无头"(headless)运行。
MCP(Model Context Protocol,模型上下文协议)是由Anthropic在2024年底推出的一项开放标准协议,旨在为大语言模型与外部数据源、工具之间提供统一的连接方式。它的设计灵感类似于USB-C接口——为AI应用提供一个标准化的"插口",让不同来源的上下文数据能够以统一的格式被模型访问。MCP采用客户端-服务端架构,基于JSON-RPC 2.0消息格式进行通信。JSON-RPC是一种轻量级的远程过程调用协议,使用JSON格式编码请求和响应,请求体包含method(方法名)、params(参数)和id(请求标识)三个核心字段,响应体则包含result或error。与RESTful API相比,JSON-RPC更适合定义明确的操作语义(如"创建上下文""请求权限""撤销授权"等),而不需要将所有操作映射到HTTP动词上;与gRPC相比,JSON-RPC不需要预编译Protocol Buffer定义文件,开发门槛更低,天然具备跨语言、跨平台的互操作能力。目前MCP已获得OpenAI、Google DeepMind等多家机构的关注和支持,正在成为智能体生态中最具潜力的互操作标准之一。
这一选择颇具深意:
- MCP 协议是近期备受关注的智能体互操作标准,选择它意味着 ACN 试图融入更广泛的智能体生态,而非另起炉灶
- 无头运行降低了系统的耦合度,让上下文共享成为一种可编程的底层能力,而不是需要人工介入的管理动作
- 开发者无需切换到额外的管理界面,一切都在智能体的自然交互流中完成
无头化(Headless)是一种在软件领域已被广泛验证的架构理念,指系统运行时不依赖图形用户界面,完全通过API或协议接口进行交互——从无头CMS(如Strapi、Contentful)到Headless Chrome(用于自动化测试和网页渲染),其核心价值在于将功能与展示彻底解耦。将这一理念应用到多智能体基础设施中,意味着权限管理、授权流程等操作全部通过编程接口完成,无需人工打开管理面板手动操作。在一个由数十甚至数百个智能体构成的协作网络中,不可能每次信息共享都需要人工审批,无头化设计让权限管理成为可以被智能体自动调用的原子操作,真正实现了机器对机器(M2M)的自治协作。
目前该项目已经发布了 Python 客户端,安装方式相当直接:
pip install priostack
代码仓库(ideaswave/priostack)中包含了三类示例:智能体注册、持久化上下文以及多智能体共享,覆盖了从入门到实际协作的完整路径。
权限模型与共享存储的核心权衡
作者最想从真正构建智能体系统的开发者那里得到的反馈是:
你更愿意让智能体通过这种带权限的方式共享上下文,还是直接让它们访问同一个数据库/向量存储?
这个问题看似简单,实则触及了多智能体架构的核心权衡。
共享存储的优势在于实现简单、性能开销小,对于内部可信的智能体集群来说足够用了。团队完全掌控所有智能体,信任边界清晰。这类似于微服务架构中的"共享数据库"反模式——在小规模、高信任环境下它是最高效的选择,但随着系统规模和组织边界的扩展,它的局限性会指数级放大。
权限模型的价值则在跨边界场景中凸显。当智能体分属不同应用、团队乃至组织时,你不可能让外部智能体随意翻阅你的完整记忆。此时,细粒度授权、所有权保留和权限撤销就从"锦上添花"变成了"刚需"。这与云计算领域中零信任架构(Zero Trust Architecture)的理念高度一致——永远不默认信任,始终验证权限。
换句话说,ACN 押注的是一个未来趋势:智能体经济将走向跨组织协作。当来自不同公司的智能体需要临时协同完成任务时,一套标准化的、安全的上下文共享协议将成为基础设施。
ACN方案的局限性与待验证挑战
说个细节,本文分析仅基于作者在 Reddit 上的单一来源分享,尚未有其他独立来源交叉验证其实际效果与性能表现。因此对于这套方案,读者应保持审慎乐观。
从工程角度看,ACN 面临几个待验证的挑战:
- 性能开销:每次跨智能体读取都要经过请求-授权流程,在高频交互场景下延迟是否可接受?在分布式系统中,额外的认证和授权步骤通常会引入数毫秒到数十毫秒的延迟。对于实时性要求极高的场景(如多智能体实时博弈或高频交易),这一开销可能成为瓶颈。是否可以引入令牌缓存、批量授权或基于时间窗口的权限预授予等优化策略,将是工程化落地的关键。
- 信任根问题:如何防止智能体伪造身份骗取授权?跨组织场景下的身份认证机制尚不明确。
- 生态采纳:绑定 MCP 协议是明智的选择,但其能否成为事实标准仍有待观察。
信任根(Root of Trust)是信息安全领域的核心概念,指安全体系中最底层、不可再被质疑的信任起点。在传统互联网中,这通常由数字证书体系(PKI)和证书颁发机构(CA)来承担。然而在智能体世界中,身份认证面临全新的挑战:智能体不是人类用户,无法通过密码或生物识别进行认证;智能体可以被动态创建和销毁,身份的持久性难以保证;在跨组织场景下,不存在统一的身份颁发机构。这意味着一个恶意智能体理论上可以伪装成合法智能体来骗取上下文访问权限。目前业界的探索方向包括W3C的去中心化身份标识符(DID)标准——它允许实体在不依赖中心化注册机构的情况下创建和管理自己的数字身份,配合可验证凭证(Verifiable Credentials)机制可实现选择性披露。另一个值得关注的方向是SPIFFE(Secure Production Identity Framework for Everyone),它为微服务和工作负载提供加密身份,已在Kubernetes生态中广泛应用,其设计理念天然适合扩展到智能体身份管理场景。此外,OAuth风格的智能体授权流程也是一条可行路径,但这些方案均尚未在智能体场景中形成成熟实践。
尽管如此,这个项目提出的问题本身极具价值。随着智能体系统日益复杂,上下文的安全共享注定会成为绕不开的基础设施命题。作者选择开源并主动征求批评,正是推动这类基础设施走向成熟的健康方式。
对于正在构建多智能体系统的开发者而言,即便不直接采用 priostack,思考"你的智能体到底应该共享多少"这个问题,本身就极有意义。
核心要点
相关推荐
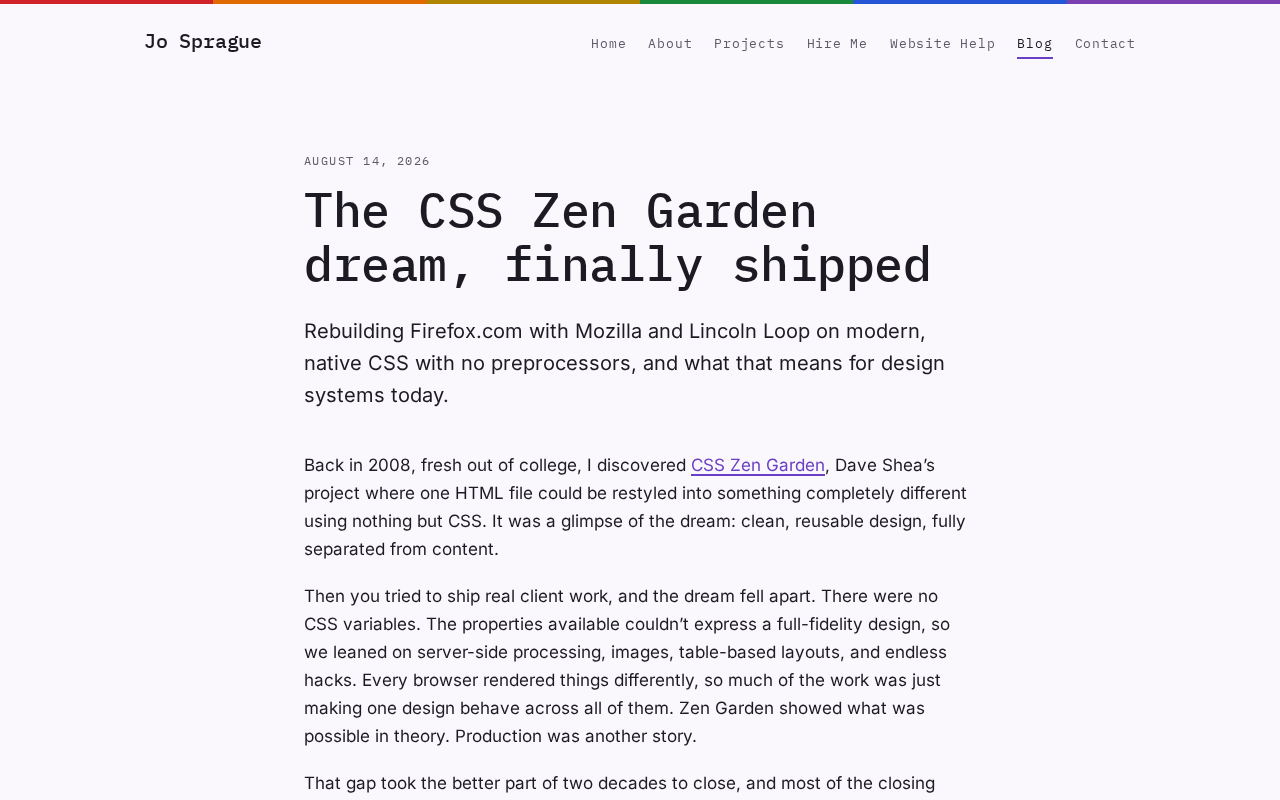
CSS Zen Garden的理想终成现实?聊聊内容与样式分离
Hacker News 热帖「The CSS Zen Garden dream shipped」引发讨论。本文回顾 CSS Zen Garden 内容与样式分离的设计理想,分析现代 CSS 如何让这一梦想落地,以及组件化时代理想与现实之间的张力。
开源AI落后前沿模型仅4.4个月:差距正在缩小
开源AI落后前沿模型仅4.4个月:差距正在缩小
一份《State of Open Source》报告指出开源AI模型平均仅落后前沿闭源模型4.4个月。本文解读这一时间差指标的意义、背后驱动力,以及它对企业、开发者与闭源实验室的影响。
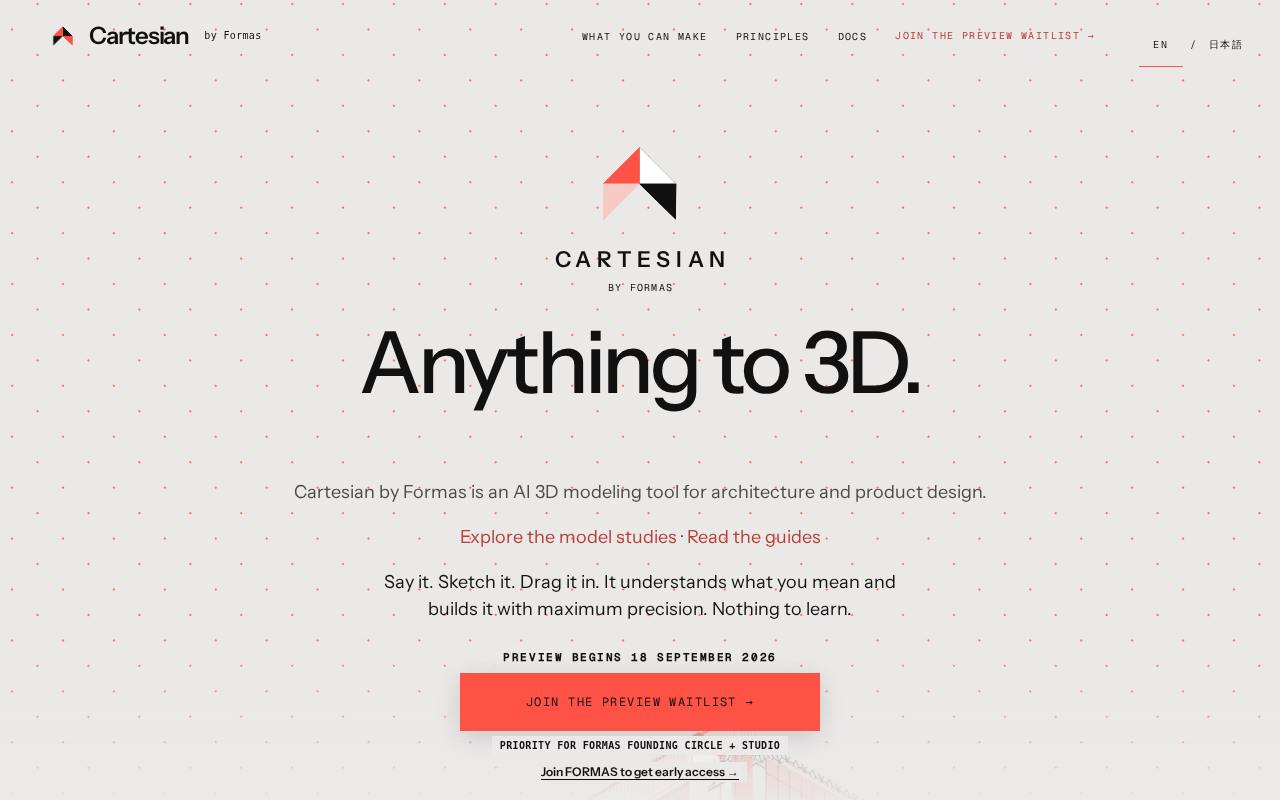
Cartesian:用AI重塑3D建模的设计工具初探
Cartesian 是一款 AI 驱动的 3D 建模设计工具,主打降低 3D 创作门槛、贴合真实设计工作流。本文解读其定位、AI 3D 建模的行业背景及理性观察建议。