AdaBPE:动态频率阈值如何优化混合语料分词

AdaBPE用长度与类型双重自适应频率阈值改进BPE分词,提升LaTeX等领域语言的编码效率。
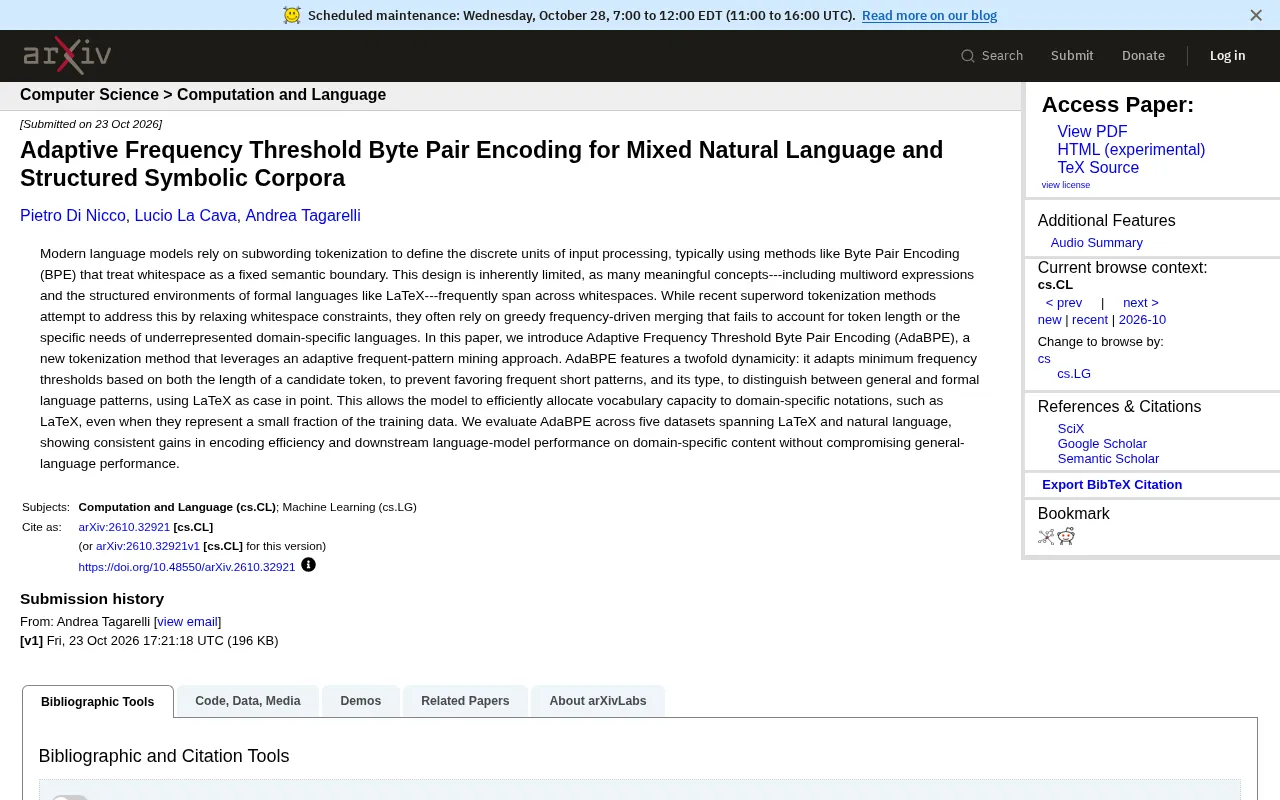
文章介绍了AdaBPE这一分词改进方法。传统BPE将空格视为固定边界,且贪心频率合并偏向短模式,导致多词表达被拆散、LaTeX等低频结构化语言难以获得专门词汇。AdaBPE引入双重自适应频率阈值:候选token越长阈值越低,以抵消短模式偏好;同时对形式语言(如LaTeX)采用更宽松阈值,使其在混合语料中获得独立词汇配额。在五个纯LaTeX、纯自然语言及混合数据集上,AdaBPE提升了领域内容的编码效率和下游模型表现,且未损害通用语言性能。文章认为该框架可扩展到代码、数学公式等其它形式语言,但类型划分自动化与阈值函数迁移性仍待验证。
语言模型处理输入的第一步是分词,而Byte Pair Encoding(BPE)作为主流方法,长期将空格视为不可逾越的语义边界。这一假设在自然语言中尚可接受,但面对多词表达或LaTeX等结构化符号语言时,就显得捉襟见肘——许多有意义的单元恰恰跨越空格存在。近期一篇论文提出的AdaBPE,试图用自适应频率阈值来重新定义分词的合并逻辑。
传统BPE的边界困境
BPE的核心操作是统计相邻符号对的频率,反复合并最高频的组合。这种贪心策略简单有效,却隐含两个缺陷:其一,空格被当作固定的切分点,导致“New York”这类多词表达被拆成独立token,模型需要额外学习它们的关联;其二,频率驱动天然偏向短模式——一个出现100次的二元组,在合并优先级上会压过出现80次但语义更完整的长模式。
近期出现的superword tokenization方法尝试放松空格约束,但论文指出,它们仍依赖贪心频率合并,既不考虑token长度,也忽视低频但关键的领域特定语言(DSL)符号。对于训练数据中占比极小的LaTeX代码,标准BPE几乎不会为其分配专门的词汇容量。
BPE(Byte Pair Encoding,字节对编码) 最初是一种数据压缩算法,2016年被Sennrich等人引入神经机器翻译后成为主流分词方法。其流程是:将文本拆分为字符或字节序列,统计所有相邻符号对的频率,将最高频的对合并为新符号,重复此过程直到词表达到预设大小。BPE从字符级开始合并,能自动发现语料中的常见子词单元,兼顾了词表的紧凑性与未登录词的覆盖能力。但这一机制完全由频率驱动,且预处理阶段通常按空格预切分,导致合并操作无法跨越空格边界。
Superword tokenization(超词分词) 指一类放宽传统词边界约束的分词方法,允许合并跨越空格的多词表达(如“New York”“in vitro”),使分词器能直接产出包含空格的token。这类方法旨在让模型更高效地表示固定搭配和短语,但多数实现仍沿用贪心频率合并,未对token长度或领域类型做差异化处理。
AdaBPE的双重动态性
AdaBPE的切入点很直接:让最小频率阈值动起来。具体而言,它引入两重自适应机制。
第一重针对长度。 候选token越长,其频率阈值越低。这可以抵消BPE对短模式的偏好,让“\begin{equation}”这类长而完整的结构有机会进入词表,而不是被拆成“\begin”、“{”、“equation”等碎片。
第二重针对类型。 系统区分一般自然语言模式与形式语言模式(论文以LaTeX为例),对后者采用更宽松的阈值。这样一来,即使LaTeX在混合语料中只占很小比例,其特有记法也能获得独立的词汇配额,而不必与高频英文单词争夺合并机会。
论文将这一思路描述为“自适应频繁模式挖掘”,本质上是在BPE的合并循环前加了一层动态过滤器:先根据候选模式的长短和类别调整准入门槛,再执行合并。
形式语言(formal language) 与自然语言相对,指由精确定义的语法规则生成的语言,如编程语言、LaTeX排版标记、数学公式、SQL等。其特点是符号密集、结构严格、语义由语法树而非词序决定。在混合语料中,形式语言内容通常占比极低,但其token分布与自然语言差异巨大——大量符号(如反斜杠、花括号、下划线)在自然文本中罕见,标准BPE会将其拆成单字符碎片,导致编码效率低下且模型难以学习结构模式。AdaBPE将形式语言作为独立“类型”分配更宽松的合并阈值,正是为了解决这种词汇配额竞争问题。
实验设计与结果
作者在五个数据集上评估AdaBPE,覆盖纯LaTeX、纯自然语言以及两者混合的场景。结果显示,在领域特定内容上,编码效率有稳定提升——相同文本被压缩成更少的token;下游语言模型在LaTeX相关任务上的表现也优于基线,同时通用自然语言性能没有出现退化。
这一结果值得注意的地方在于“不妥协”:通常为领域数据优化词表会挤占通用语言的表示空间,但AdaBPE通过类型感知的阈值分配,在混合语料中维持了两者的平衡。
编码效率(encoding efficiency) 在分词语境下通常以“每字符token数”(tokens per character)或压缩率衡量:相同文本被编码成越少的token,效率越高。更少的token意味着模型在固定上下文窗口内能处理更多内容,同时降低注意力计算和推理成本。对LaTeX等结构化语言,高效编码尤为关键——若“\begin{equation}”被拆成多个碎片,模型需要额外层级的组合才能恢复其结构含义,既浪费容量又增加学习难度。AdaBPE在领域特定内容上提升编码效率,直接体现为相同LaTeX源码产生更短的token序列。
对分词研究的启示
AdaBPE的价值不止于LaTeX。它提出了一种可扩展的框架:只要能为某一类模式定义“类型”,就可以为其定制频率阈值。这意味着未来面对代码、数学公式、甚至多语言混合语料时,分词器不必再依赖单一固定规则,而是可以按内容类型动态调整合并策略。
当然,论文目前仅以LaTeX作为形式语言的案例,类型划分的自动化程度、阈值函数的具体形式对其它DSL的迁移效果,仍有待进一步验证。但方向本身是清晰的:分词器需要更细粒度的感知能力,而自适应阈值是一个轻量且有效的杠杆。
相关推荐
AgentTrust:为AI代理加上零信任与人工审批
AgentTrust在Hacker News发布,为AI代理提供零信任安全与人工审批机制。本文解析其动作级权限校验、人工审批闸门与审计回溯设计,并讨论与现有AI可观测性工具的差异及落地局限。
塞尔维亚大选变天:武契奇承认败选,学生运动创造历史
塞尔维亚总统武契奇承认在提前议会选举中败选,以学生运动为核心力量的反对派阵营取得历史性胜利。本文分析学生运动的政治崛起、选举结果的地缘影响以及塞尔维亚政局未来走向。

非线性概念擦除新框架:条件自编码器实现精准擦除与转向
论文提出条件自编码器框架,为非线性概念擦除提供形式化保证,在无目标任务标签下实现更优的效用-擦除权衡,并解锁表征转向能力,收敛更快。