Agent Loop面试十连问:B站最细Loop Engineering教程拆解

Agent Loop面试必答:从生命周期、工具、记忆、交付物四维度拆解其与单次API调用的本质区别。
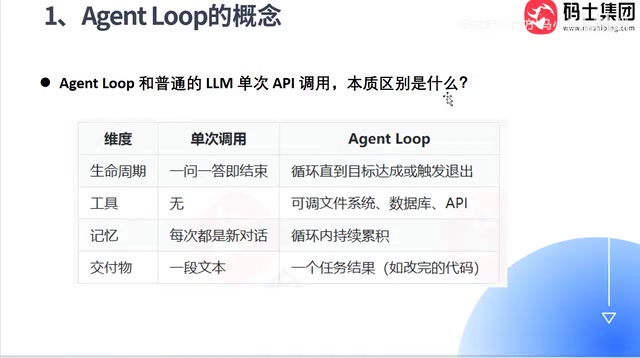
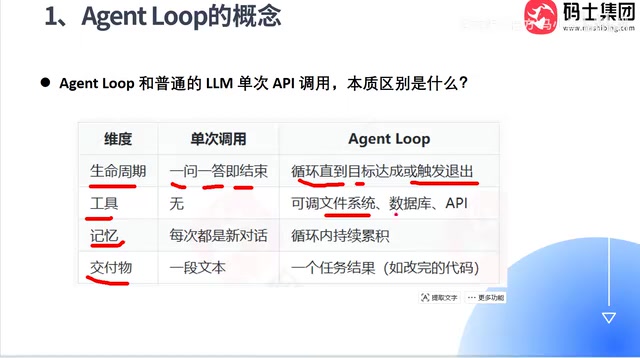
文章指出面试风向已从「会不会用」转向「怎么设计」,Agent Loop相关问题成为必答题。针对最基础的第一问——Agent Loop与单次API调用的本质区别,文章反对只答「一个能调工具一个不能」,主张从四个维度系统作答:生命周期上,单次调用一问一答即结束,Loop需循环到目标达成或触发退出条件;工具上,单次调用只能输出文本,Loop可调文件系统、数据库和外部API;记忆上,单次调用每次从零开始,Loop在循环内持续积累上下文;交付物上,单次调用输出文本,Loop交付的是修改后的代码、修复的bug等任务结果。文章还给出可直接套用的面试回答模板,并提醒只答工具调用、把Loop说成「带工具的LLM调用」等常见误区。
为什么Agent Loop成了面试新宠?
面试的风向正在变化。过去面试官关心的是「你会不会用」,现在直接问「你是怎么设计的」——Agent Loop怎么设计、Maker和Checker为什么要分离、Loop的退出条件是什么。这些问题答不上来,面试基本接不住。
据B站UP主在《Agent Loop面试十连问》教程中的观察,这类问题已经从加分项变成了必答题。本文基于该教程的第一问,拆解Agent Loop的本质,并给出可直接套用的面试回答模板。
第一问:Agent Loop与单次API调用的本质区别
这是最基础也最容易答砸的一题。面试官问「Agent Loop和普通LLM单次调用API的本质区别是什么」,很多人的回答是「一个能调工具,一个不能调工具」。
这个答案不算错,但太单薄。UP主给出的建议是拆成四个维度来讲,面试时按这个框架展开,逻辑会清晰很多。
维度一:生命周期
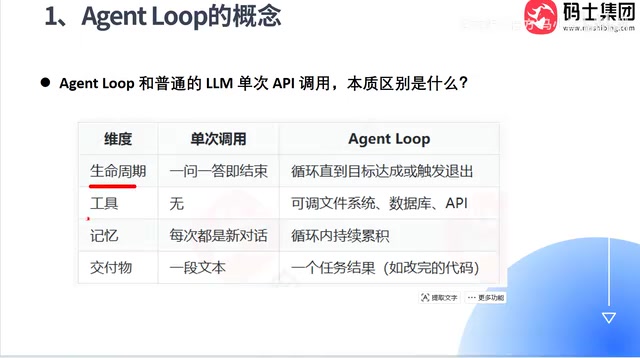
单次调用是一问一答,问完就结束。Agent Loop则是一个持续循环的过程,必须跑到目的达成或者触发退出条件才停止。生命周期长度完全不同,这是最根本的差异。
维度二:工具调用
单次调用没有工具调用能力,模型只能输出文本。Agent Loop可以调文件系统、调数据库、调外部API。工具是Loop的手脚,让它能对外部世界产生实际影响。
工具调用(Function Calling / Tool Use)的底层机制值得补充:模型本身并不执行工具,而是输出结构化的调用请求(如JSON,含工具名和参数),由外部运行时解析并真正执行,再把结果作为新消息回传给模型。这意味着Agent Loop必须包含「解析→执行→回填」三个环节,任何一环出错都会导致循环空转。常见设计包括工具白名单、参数校验、超时与重试、错误信息回传给模型让其自我修正。理解这一机制,才能解释为什么Loop的退出条件需要和工具执行结果挂钩。
维度三:记忆
单次调用每次都是全新的对话,上下文从零开始。Agent Loop在循环内可以持续积累信息,前面步骤的结果会成为后面步骤的输入。这种循环内的记忆积累,是Loop能处理复杂任务的前提。
LLM的「上下文窗口」是理解记忆维度的关键背景。单次调用时,每次请求都要把全部历史对话重新塞进窗口,窗口满了就得截断或摘要,因此记忆是「无状态」的。Agent Loop则在循环内把每一步的工具返回、中间结果追加到上下文中,形成「滚动累积」的状态。但这也带来窗口溢出问题——当任务链很长时,需要通过摘要压缩、外部向量库检索或子Agent隔离来管理记忆。面试时若能点出「Loop的记忆不是无限的,需要设计压缩和检索策略」,会显著加分。
维度四:交付物
单次调用的输出通常是一段文本。Agent Loop交付的是任务结果——可能是一份修改好的代码、一个修复的bug、一份完整报告。交付物的性质从「信息」变成了「成果」。
面试回答模板
把四个维度串起来,现场可以这样答:
「Agent Loop和单次调用的区别可以从四个维度看。第一是生命周期,单次调用一问一答就结束,Loop要循环到目标达成或触发退出条件;第二是工具,单次调用没有工具能力,Loop可以调文件系统、数据库、API;第三是记忆,单次调用每次都是新对话,Loop在循环内持续积累上下文;第四是交付物,单次调用输出文本,Loop交付的是任务结果,比如修改后的代码。」
这个模板的好处是有结构、有层次,面试官能立刻判断你理解得系统。
延伸思考:为什么这题重要
这道题看似考概念,实际在筛人。能答出四个维度的人,说明真正用过、设计过Agent系统;只答「能调工具」的人,大概率只是调用过API。
UP主在教程中提到,后续还会拆解Maker和Checker分离的原因、Loop退出条件等进阶问题。这些问题的共同点是:都在考察设计决策背后的权衡,而不是功能会不会用。对准备面试的开发者来说,把Loop的每个设计选择想清楚,比背答案更有价值。
Maker和Checker分离是Agent Loop中一个典型的设计权衡。Maker负责生成或执行,Checker负责独立校验输出是否满足目标。分离的价值在于打破「自我确认偏差」——同一个模型既生成又检查,容易对自己的错误视而不见。代价是成本翻倍、延迟增加,且Checker本身也可能出错。因此实践中常采用「轻量Checker + 抽样全量校验」或「规则Checker + 模型Checker」的混合策略。面试中被问到这一点,重点应落在「什么场景值得付出双倍成本」这一权衡判断上。
常见误区提醒
- 只答工具调用,忽略生命周期和记忆维度
- 把Agent Loop说成「带工具的LLM调用」,没有体现循环和退出条件
- 交付物描述停留在「文本输出」,没意识到Loop产出的是任务结果
把这四个维度记住,第一问基本不会丢分。
Loop的退出条件同样是高频追问点,常见设计包括:目标达成(Checker判定通过)、最大迭代次数上限、超时限制、连续无进展(重复相同动作或错误)、显式终止信号。只依赖「模型自己说完成了」是最危险的做法,因为模型可能过早宣布成功或陷入死循环。健壮的Loop通常组合多个条件:硬上限兜底、进展检测止损、Checker做质量门禁。回答时强调「退出条件是安全网,不是可选项」,能体现工程成熟度。
相关推荐
机器人替代人类:74%工作可胜任,为何仅0.3%被自动化?
Anthropic估算机器人已能完成美国74%的体力工作,但仅0.3%的工作用机器人更划算。本文解析技术可行性与经济可行性之间的鸿沟,以及安装、维护、可靠性等隐性成本如何阻碍机器人替代人类。
iPhone 18 Pro深度评测:性能翻倍,AI功能成最大亮点
基于LTT深度评测,解析iPhone 18 Pro的A20 Pro芯片性能跃升、续航充电改进、可变光圈相机与Apple Intelligence实用化进展,并给出换机建议。

2026年CNN项目创意:打造作品集的实用指南
针对2026-27年作品集需求,整理四个CNN项目方向:农业病害检测、医学影像可解释性、视频动作识别和混合CV管道,并给出让项目脱颖而出的工程习惯建议。