Agent-Reach开源解析:零API费给AI装上上网眼睛
Agent-Reach用一句指令为AI Agent打通六大平台的网页抓取能力,免费且开箱即用。
AI Agent普遍存在"写代码在行、上网抓瞎"的问题,根源在于Twitter付费API、Reddit封锁匿名接口、小红书强制登录、B站反爬、YouTube字幕难取、普通网页HTML难解析等六道各自独立的拦路虎。Agent-Reach将这些问题统一打包,以"能力层"而非具体工具的形式出现:安装只需一句自然语言指令交给Agent执行,`agent-reach doctor`体检命令可即时确认各通道状态。网页、YouTube字幕、RSS、全网搜索、开源仓库、B站六条零配置通道免费开箱即用;Twitter、小红书、Reddit则通过Cookie登录授权接入。多后端路由的首选+备选机制确保单一渠道失效时自动切换,整体几乎零API成本,但需注意使用专用小号与控制调用频率。
AI Agent的通病:会写代码,却上网抓瞎
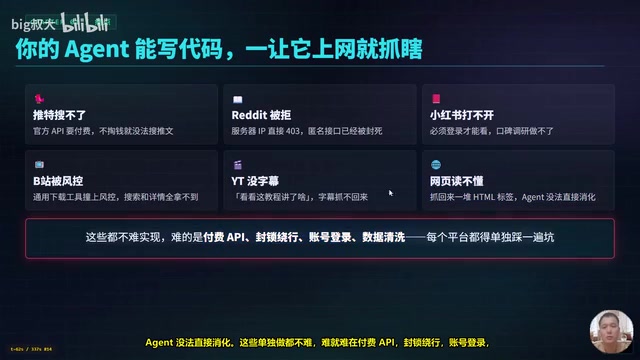
很多人都遇到过这样的场景:让AI Agent写代码一点问题没有,可一旦要它上网查资料就彻底抓瞎。据B站UP主「大叔大」的实测分析,这种抓瞎集中体现在六个平台上,而且每一个都有各自的拦路虎。
具体来说,Twitter收不了——官方API要付费,不掏钱就拿不到推文;Reddit被拒,匿名接口已被封死,服务器IP直接返回403;小红书打不开,必须登录才能查看,口碑调研根本做不了;B站撞上封控,通用下载工具抓不到搜索和详情;YouTube没字幕,想知道教程讲了啥却抓不回字幕;普通网页抓回来一堆HTML标签,Agent根本没法直接消化。
这些问题单独解决其实都不算难,难就难在付费API、封锁绕行、账号登录、数据清洗这几道坎每个平台都得单独踩一遍。Agent-Reach要做的,正是把这些重复踩坑的活儿一次性打包解决。
一句话安装:把上网能力交给Agent自己搞定
Agent-Reach的安装方式相当反直觉——你不需要手动配置,只要把一句自然语言指令复制给你的Agent即可。无论是Cloud Code、OpenCloud还是Cursor,直接对它说「帮我安装Agent-Reach,参考仓库docs/install.md」,剩下的装CLI、查依赖、配渠道它自己就能完成。
从产品定位看,Agent-Reach并不是又一个具体的抓取工具,而是比工具高一层的「能力层」。选型、安装、体检、路由这些事都归它管,而读取本身仍然是Agent直接调用上游工具,没有多余的包装。这种设计既保证了灵活性,又避免了重复造轮子。
安装过程分四步:先装CLI工具(自带yt-dlp和feed parser),再检查Node.js、gh-cli等系统基建缺什么就提示安装方式,接着在明确授权后才写入配置(默认只检查不改系统),最后让你点名需要哪些渠道——六条零配置渠道先激活,需要登录的平台由你指定才装。
MCP(Model Context Protocol)是Anthropic提出的一种开放协议,用于标准化AI模型与外部工具、数据源之间的通信方式。简单理解,它相当于AI世界的「USB接口」——只要工具按照MCP规范暴露接口,任何支持MCP的Agent都能直接调用,而无需为每个工具单独写集成代码。Agent-Reach中提到的「搜索能力经MCP接入」正是依赖这一机制:搜索工具以MCP Server的形式运行,Agent作为MCP Client发起调用,双方通过标准协议交换请求与结果,无需API Key也能完成全网检索。目前Claude、Cursor、OpenCode等主流Agent平台均已原生支持MCP,这也是Agent-Reach能做到「一句话接入」的底层原因之一。
一条命令体检:看清哪条路通、哪条路堵
装完之后怎么知道哪条路是通的?Agent-Reach给出的答案是一条体检命令:agent-reach doctor。
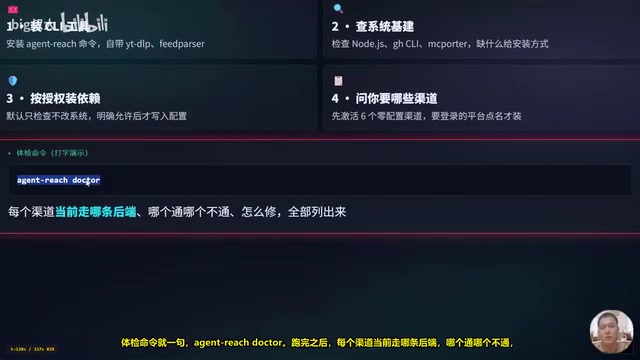
跑完之后,每个渠道当前走哪条后端、哪个通哪个不通、不通的怎么修,全部会清晰列出。体检一过,六条零配置通道就能开箱即用:
- 任意网页:用Gina Reader把网页转成干净正文,免费无需key
- YouTube字幕:yt-dlp提取字幕,也支持视频搜索
- RSS订阅:feedparser读任意RSS和Atom源
- 全网搜索:搜索能力经MCP接入,免key也不花钱
- 开源仓库:gh-cli读公开仓库、搜索,登录后解锁私有仓库
- B站:bili-cli无需登录即可搜索、读视频详情
命令本身一个都不用记。Agent读了skill.md之后,自己就知道该调哪个工具。
实战演示:从B站搜索到读回字幕
光说不练假把式。以搜一条B站视频并读回字幕为例,整个流程相当顺畅。
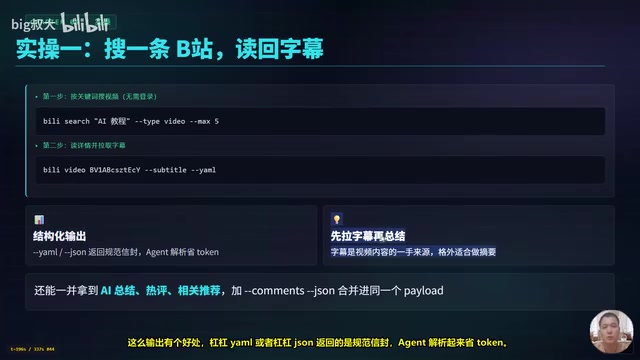
第一步按关键词搜视频(无需登录),终端输入搜索命令,指定类型为video、取五条以内结果。第二步读详情加拉字幕,输入视频命令跟上BV号,加上--subtitle拉字幕、--yaml输出结构化数据。
用--yaml或--json输出有个明显好处:返回的是规范的「信封」格式,Agent解析起来更省Token。UP主「大叔大」的经验是先拉字幕再总结——字幕是视频内容的一手来源,格外适合做摘要。如果想更进一步,加上--comments还能把热评、相关推荐一并合并进同一个payload,让AI做更完整的总结。
yt-dlp是一个开源的命令行视频下载与元数据提取工具,由youtube-dl分叉而来,维护更为活跃。除了下载视频本体,它还能单独提取字幕文件(包括自动生成字幕)、视频元数据、评论等结构化信息,这正是Agent-Reach用它承接YouTube字幕任务的原因。值得注意的是,yt-dlp对B站的支持相对有限,因此B站部分由专门的bili-cli承接,两者分工明确。在「信封」格式的输出设计上,--yaml或--json的结构化输出意味着字幕、标题、简介等字段各归其位,Agent解析时不需要额外做文本切割,Token消耗更低,也更不容易出现解析错误。
需要登录的三个平台怎么接
B站、YouTube、网页、RSS这些零配置渠道装完就能用,但Twitter、小红书、Reddit三个平台需要登录授权。
Twitter首选twitter-cli,实测搜索稳定,配好cookie后可搜推文、浏览时间线;小红书用open-cli,可复用你已有的Chrome,服务器场景则改用cookie-editor导出cookie;Reddit匿名接口已被封,没有零配置路径,只剩登录这一条路。
配置这些平台时更省事——不用查文档,直接对Agent说「帮我配某某平台」,它就会一步步引导你提供所需信息。此外还有一层兜底设计:多后端路由,每个平台都是「首选+备选」,某条路失效了会自动切换,使用方完全无需改动。
Cookie是浏览器在完成网站登录后本地保存的身份凭证,再次访问时浏览器会自动携带它以证明已登录状态。在脚本自动化场景中,「复用Cookie」意味着将浏览器中已有的登录状态导出为文件,再交给命令行工具使用,从而绕过需要交互操作的登录流程。文中提到的cookie-editor是一款浏览器扩展,可将当前标签页的Cookie导出为JSON格式。这种方式的风险在于:Cookie本质上等同于登录凭证,一旦泄露或被平台检测到异常调用行为,账号可能被封禁——这也是文章反复强调「使用专用小号」的直接原因。
接入Cloud Code与Cursor的关键设计
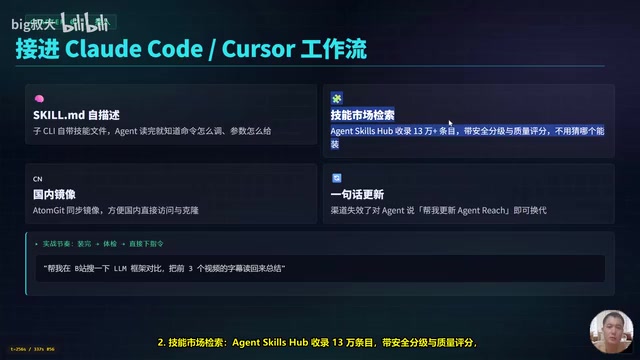
要让Agent-Reach真正融入工作流,有四件事值得关注。其一是skill.md自描述,CLI自带技能文件,Agent读完就知道命令怎么调、参数怎么给。其二是技能市场检索,Agent Skills Hub收录了约13万条目,带安全分级与质量评分,不用自己猜哪个能装。其三是国内镜像,通过atom git同步镜像方便国内直接访问与克隆。其四是一句话更新,渠道失效了直接说「帮我更新Agent-Reach」即可。
免费的边界:这些坑要提前知道
免费虽好,但封控和边界必须讲清楚。
首先,免费的是抓取与读取通道,不是让你绕开各平台的官方付费API。其次,成本方面本地电脑零成本,仅服务器部署需要代理,约1美元一个月。再次,cookie只存本地config.yaml,权限600,不上传不外传,代码开源可查。
三条安全提醒也要记牢:一是用专用小号,脚本调用有被平台检测封号的风险,别拿主账号冒险;二是注意频率,撞上B站412封控就稍等或调小--max结果数;三是遵守平台条款,频率自己拿捏,别高频猛刷。
小结
Agent-Reach的核心价值可以浓缩成三点:一句话安装,复制指令给Agent几分钟完成接入;六条零配置通道(网页、YouTube、RSS、搜索、开源仓库、B站)开箱即用;多后端路由首选加备选,平台换代由项目方跟进。一句话总结,它让Agent从「只能聊」变成「能上网查」,而且几乎不花一分钱API费。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。