Agent Tracing详解:看清AI智能体每一步

Agent tracing 用树状 span 记录智能体每一步,解决日志无法定位慢、贵、错的问题。
文章指出,普通日志无法表达智能体多步执行中的因果关系,而 agent tracing 将一次运行记录为树状 trace,每个 span 对应一个步骤(模型调用、工具调用等),并存储模型、输入输出、token 数和错误信息。通过时间线可定位慢步骤,累加 token 可定位高成本调用,查看模型输入与工具返回值可定位错误答案根因。OpenAI Agent SDK 默认记录输入输出,OpenTelemetry GenAI 约定则需主动 opt in,隐私默认值相反。采用 OTel 标准可避免厂商锁定。最终,tracing 应与评估联动,测试失败时 trace 直接揭示原因,是智能体可维护的基础设施。
你的AI智能体给客户回了一个错误答案,问题究竟出在哪一步?如果没有tracing,你可能永远找不到答案。Agent tracing记录智能体在一次运行中的所有动作——每一次模型调用、每一次工具调用、每一个决策。它不是普通日志的堆砌,而是把智能体的多步执行串成一棵可追溯的树。
为什么普通日志不够用
普通日志只是一行行文本,记录“发生了什么”。但智能体的运行是多步骤的:用户请求进来,模型思考、调用工具、拿到结果、再调用模型,最后给出回答。这些步骤之间存在因果关系,而纯文本日志无法表达“谁触发了谁”。据视频中的解释,agent tracing的核心价值就在于把这些步骤连接起来,让你看到一次完整运行的全貌。
Trace与Span:智能体运行的基本结构
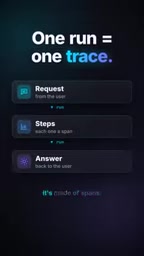
一次trace代表一次完整运行,从用户请求开始,到最终答案结束。它由多个span组成。每个span是一个步骤,带有开始时间和结束时间,并且有一个父节点,因此所有步骤构成一棵树。
以一次典型的智能体运行为例:根节点是agent run本身;其下依次是模型调用、工具调用、再一次模型调用。每个span都存储了调试所需的关键信息——使用的模型、输入与输出、token数量,以及可能出现的错误。这种树状结构让因果关系一目了然,而不是在日志海洋里靠时间戳猜测。
三个问题,tracing直接回答
智能体为什么慢?
看时间线(timeline)就能定位。视频中举例说,你能直接看到哪一步花了八秒。不需要逐行扫描日志,时间线把每个span的耗时可视化,瓶颈步骤立刻暴露。
智能体为什么贵?
把每个span里的token数加起来,就能找到消耗预算最多的那次调用。成本分析不再是拍脑袋,而是按步骤归因。
答案为什么错?
打开trace,读取模型当时到底看到了什么,以及工具返回了什么。据视频中的说法,错误答案的根因往往藏在某一次模型调用的输入里,或者某一次工具调用的返回值里。
框架默认支持与行业标准
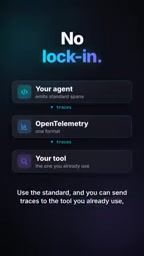
许多智能体框架默认就带tracing。以OpenAI的Agent SDK为例,它会记录模型调用、工具调用、handoff(交接)以及guardrails(护栏)。另一边,OpenTelemetry的GenAI语义约定正在成为跨框架的标准,仍在开发中,定义了InvokeAgent、ExecuteTool等span类型。
采用标准的好处是避免锁定(lock-in):你可以把trace发送到已经使用的可观测性工具里,而不是绑定在某一家厂商的平台上。
OpenTelemetry 与 GenAI 语义约定
OpenTelemetry(OTel)是一个开源的、厂商中立的可观测性框架,统一了链路追踪(traces)、指标(metrics)和日志(logs)的数据采集与导出标准。其 GenAI 语义约定(Semantic Conventions for Generative AI)是专门为生成式 AI 应用制定的规范,定义了如何将模型调用、工具执行、智能体交接等操作映射为标准的 span 类型和属性,例如 gen_ai.agent.invoke、gen_ai.tool.execute 等。遵循该约定意味着你的 trace 数据可以被任何兼容 OTel 的后端(如 Jaeger、Prometheus、Datadog 等)直接消费,无需为每个观测平台单独适配。目前该规范仍处于活跃开发阶段,但已成为跨框架互操作的重要方向。
handoff 与 guardrails
在 OpenAI Agent SDK 中,handoff 指智能体将任务或对话控制权移交给另一个智能体的机制,常用于多智能体协作场景;guardrails 则是围绕模型输入输出设置的安全护栏,例如内容过滤、格式校验或敏感信息拦截。tracing 会将这些事件也记录为独立的 span,帮助开发者审计智能体之间的交接路径和安全策略的触发情况。
隐私默认值:两种相反的设计
Trace可能包含用户数据,这一点在选型时必须注意。视频指出,OpenAI的SDK默认记录输入和输出,如果你处理敏感数据,需要主动关闭。OpenTelemetry的做法相反:消息内容只有在你明确选择加入(opt in)时才会被捕获。两种默认值没有绝对优劣,但团队需要清楚自己用的工具默认行为是什么。
把trace接到评估上
Tracing的最终价值在于和评估(evals)打通。当一个测试用例失败时,trace直接告诉你为什么失败。视频中的一句话点明了本质:“如果你看不到它,你就无法修复它。”对智能体开发者而言,tracing不是可选的调试辅助,而是让系统可维护的基础设施。
评估(evals)与 tracing 的联动
评估(evals)是指用一组预定义的测试用例(如问题-答案对、任务场景)自动运行智能体,并依据准确性、相关性、安全性等指标打分的过程。将 trace 与 evals 结合,意味着每个测试用例的执行都会生成一条完整的 trace。当某个用例得分低或失败时,开发者不必仅凭最终输出猜测原因,而是可以直接下钻到具体的 span:查看模型在某一轮看到了什么上下文、工具返回了哪些数据、哪一步耗时异常或报错。这种“评估触发、trace 定位”的闭环,把事后调试转变为可重复的根因分析,显著提升智能体迭代的效率。
相关推荐

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。

本地模型为何在Doom游戏决策中击败Jev AI API?
YouTube视频对比显示,本地模型GLiNER在Doom游戏中以12毫秒响应和8.8次/秒决策频率,大幅超越Jev AI API的2.5次/秒,得分翻倍。