Agent记忆架构的五层模型:主流框架实现对比

Agent记忆应分五层设计,没有单一框架能全覆盖,需按场景组合。
文章提出Agent记忆的五层模型:历史记录、压缩、语义召回、工作记忆和文件系统,由浅入深解决不同粒度的问题。历史记录是各框架的起点,但受窗口与成本限制;压缩层用摘要换空间,LangGraph靠checkpoint裁剪,Claude则依赖长上下文隐式处理;语义召回借助向量检索,难点在写入时机判断,多数框架未提供开箱策略;工作记忆是任务内暂存区,LangGraph图状态天然适配;文件系统提供透明可审计的长期存储,价值常被低估。框架对比显示Mastra强于语义召回、LangGraph强于状态管理、OpenAI与Claude覆盖历史与文件层,没有全能选手。实践建议从最小可用出发,按需逐层补齐。
Agent的记忆能力正成为区分产品级应用与Demo的关键。一篇技术分析将Agent记忆拆解为五个层次:历史记录、压缩、语义召回、工作记忆和文件系统,并对比了Mastra、LangGraph、OpenAI和Claude各自的实现路径。
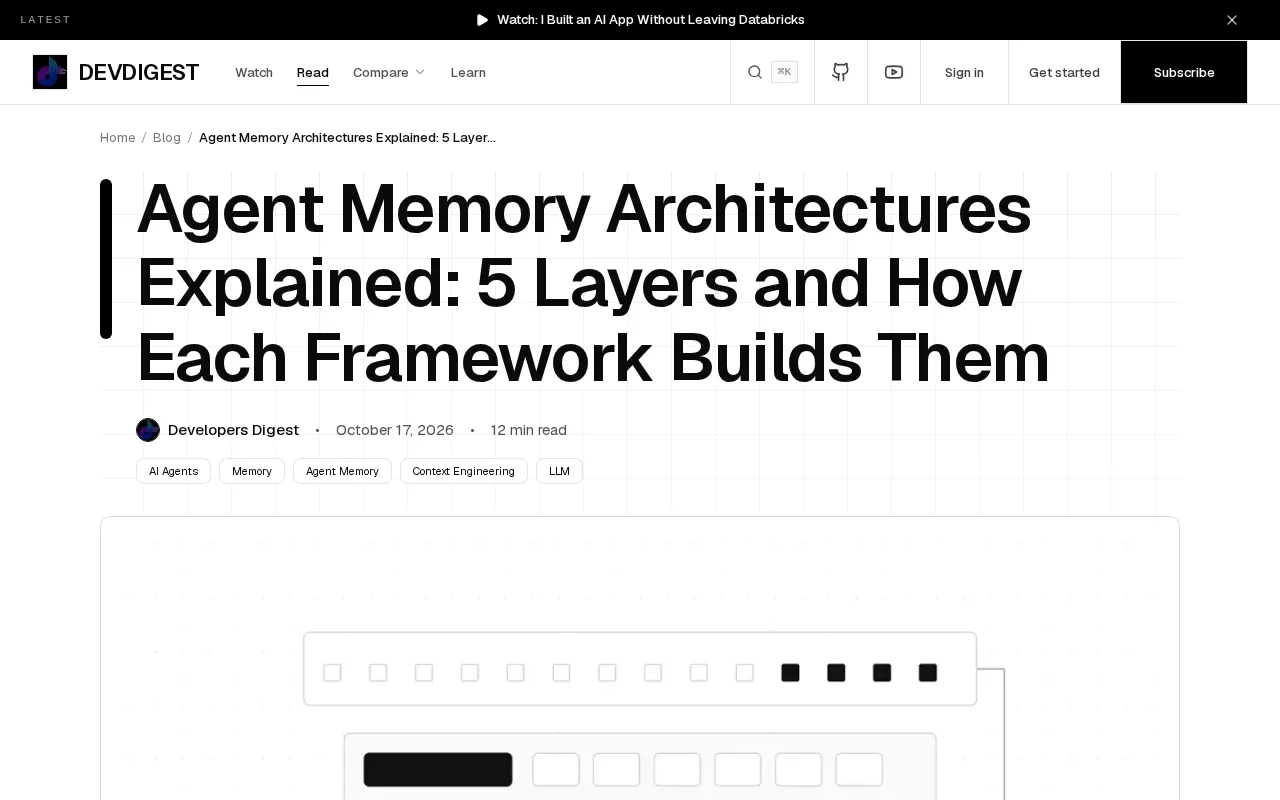
为什么需要分层理解Agent记忆
把Agent记忆当成单一功能是常见的认知误区。实际上,从对话历史到长期知识沉淀,不同需求对应截然不同的技术方案。五层模型的价值在于:它让开发者能精确判断自己的场景需要哪一层,而不是盲目堆砌向量数据库。
这五层由浅入深:最基础的是原始历史记录,往上依次是上下文压缩、语义召回、工作记忆,最外层是文件系统。每一层解决不同粒度的问题,也带来不同的工程复杂度。
第一层:历史记录——所有框架的起点
历史记录是最直观的记忆形式:把对话消息按顺序存下来,下次请求时一并送入模型。Mastra和LangGraph都采用这一模式作为默认行为。
问题在于成本与窗口限制。当对话轮次增加,原始历史会迅速撑爆上下文窗口,token开销线性增长。因此历史层通常只是起点,需要配合后续层级使用。OpenAI的Assistants API同样以thread形式保存消息历史,本质上属于这一层。
第二层:压缩——用摘要换空间
压缩层解决历史膨胀问题。常见做法是对早期对话生成摘要,保留关键信息的同时丢弃冗余细节。LangGraph通过checkpoint机制支持状态裁剪,开发者可以自定义压缩策略。
Claude的实现更依赖其长上下文能力,通过提示工程引导模型自行关注历史中的关键部分,而非显式压缩。这两种路线代表不同取舍:显式压缩节省token但可能丢失细节,隐式依赖长窗口则成本更高。
上下文窗口与 token 成本:大模型的上下文窗口指单次请求可容纳的最大 token 数(如 128K、200K)。历史消息、系统提示、工具返回都会占用窗口,超出则需截断或报错。token 按输入输出分别计费,长对话的累积成本随轮次线性上升。压缩的本质是在有限窗口内保留高信息密度内容,常见策略包括滚动摘要、关键实体提取和按重要性打分裁剪,目标是在成本与信息保留之间取得平衡。
第三层:语义召回——向量检索的主场
语义召回让Agent从海量历史中找回相关片段,通常借助向量数据库实现。Mastra内置了语义记忆模块,支持将对话嵌入后按相似度检索。
这一层的工程难点不在检索本身,而在写入时机的判断——什么内容值得记住、何时触发写入。据原文分析,多数框架把这部分留给开发者自行决策,缺乏开箱即用的策略。这也是当前Agent记忆系统最容易出问题的环节。
向量数据库与嵌入检索:语义召回依赖向量数据库(如Pinecone、Weaviate、Chroma)将文本映射为高维向量,通过余弦相似度或内积计算找出语义相近的内容。嵌入模型(如OpenAI的text-embedding-3、开源的BGE)负责将对话片段编码为向量。工程上需关注分块策略(chunking)、索引更新与检索 top-k 的取舍:块太大则噪声多,块太小则语义不完整;索引更新不及时会导致新记忆无法被召回。
第四层:工作记忆——当前任务的暂存区
工作记忆指Agent在执行单个任务过程中维护的中间状态,比如已完成的步骤、待处理的子目标。LangGraph的图状态机制天然适合承载工作记忆,节点间传递的状态即为工作记忆的具体形态。
与语义召回不同,工作记忆是短期的、任务内的,任务结束即可丢弃。区分这两者对架构设计至关重要——把工作记忆误存入长期向量库,会污染召回质量。
LangGraph 的图状态机制:LangGraph 将 Agent 流程建模为有向图,节点代表处理步骤,边定义流转条件。图状态是一个贯穿执行周期的共享数据结构,每个节点可读取并更新它。这种设计天然承载工作记忆:已完成的步骤、中间结果、待办子目标都存放在状态中,节点间传递即工作记忆的流转。任务结束后状态可丢弃,或通过 checkpoint 持久化以便恢复,从而与长期记忆清晰隔离。
第五层:文件系统——最被低估的记忆层
文件系统作为记忆层常被忽视,但它提供了结构化、可持久、可人工干预的存储。Claude的代码执行环境允许Agent读写文件,实际上构成了一种可靠的长期记忆。OpenAI的代码解释器类似。
这一层的优势在于透明性:开发者可以直接查看和修改Agent记住了什么,而不必面对黑盒向量。对于需要审计或调试的场景,文件系统的价值远超向量检索。
框架对比:没有全能选手
横向对比可见,各框架的覆盖范围差异明显。Mastra在语义召回上较为完整,LangGraph强于工作记忆与状态管理,OpenAI和Claude则依托各自平台能力覆盖历史与文件层。没有哪个框架五层全占,开发者往往需要组合使用。
原文的核心观点值得重申:Agent记忆不是单一技术选型,而是分层设计问题。先明确场景需要哪几层,再选择对应框架能力,比直接套用某个"记忆方案"更可靠。
实践建议
从最小可用出发:先用历史记录跑通流程,遇到窗口瓶颈再加压缩,需要跨会话知识时引入语义召回。工作记忆和文件系统按任务复杂度逐步补齐。过早引入向量库往往带来维护负担却收益有限。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。