Agent如何记住三年前的对话?拆解长期记忆架构五大核心
Agent长期记忆依赖分类存储、多维检索与遗忘机制构成的完整工程系统,而非单一向量库。
大模型本身不具备长期记忆,Agent服务的记忆能力完全依赖外部工程系统支撑。文章以面试题形式拆解了这套系统的五个核心问题:记忆分为短期、长期和工作记忆三类;存储依据价值和触发信号而非频率,并需冲突检测与更新;检索需在向量相似度基础上叠加时间衰减、重要性加权与混合关键词召回;上下文压缩要分层处理且关键数字不可压丢;记忆系统还必须具备遗忘机制和评测闭环。文章指出,能否回答"记忆怎么不翻车"而非"记忆是什么",是有无真实项目经验的分水岭。
大模型本身没有记忆,Agent 靠什么记住用户?
面试官抛出一个看似简单的问题:你的 Agent 服务同一个用户三年,三年前他说过的话,靠什么记住?
很多候选人脱口而出:向量数据库,历史对话全存进去,用的时候检索最相似的。但面试官紧接着追问:用户三年前说爱喝全糖拿铁,去年开始改喝空糖了,两条记忆都被检索出来,Agent 该信哪条?
绝大多数人卡在这里。这道题考的不是能不能背出框架,而是有没有真正把一套记忆系统跑起来过。大模型本身没有长期记忆,Agent 的"记忆"完全靠外部工程系统支撑。下面把这套系统拆成五个问题,逐层深入。
第一问:记忆到底分几类?
多数人的答案是短期记忆和长期记忆,但这只答对了三分之二。完整的记忆系统包含三种类型。
短期记忆是当前这轮对话的上下文,来得快去得快,窗口一关就没了。长期记忆保存用户的偏好、事实和重要事件,跨会话留存,下次开新窗口还能调用。
最容易被漏掉的是工作记忆——Agent 干活过程中的中间状态:查过哪些资料、调用了什么工具、任务走到第几步。一个十步的长任务如果没有工作记忆,跑到第七步就把前面的流程忘了,直接原地打转。能清晰区分这三类记忆,面试官就知道你不是纸上谈兵。
第二问:总不能句句都存吧?
当然不能。存记忆看的不是频率,而是价值和信号。工程上常用三条路径。
一是会话结束后统一抽取。用户聊到"下周去东京出差",系统存的是一条结构化记忆(事项、时间、地点),而不是把整段聊天原样丢进库里。二是事件触发立刻写入。用户说"记一下我对芒果过敏",这是最高优先级信号,当场落库,不能等总结。三是空闲时段后台整理,把零散记忆归并去重、合并同类项。
这一问还有个加分答案:冲突检测。旧记忆不是简单追加一条新的就完事,而是更新原记录、打上新时间戳,让两条互相打架的记忆不要同时在线。能讲到这一层的候选人真的不多。
第三问:光靠向量相似度够不够?
不够。只用相似度是要吃亏的,检索得打组合拳。
相似度是底子,但要叠加时间衰减——去年的偏好和三年前的偏好,权重不该一样。再加重要性加权——过敏原这种关键信息,不能跟"想看个电影"一个分量。
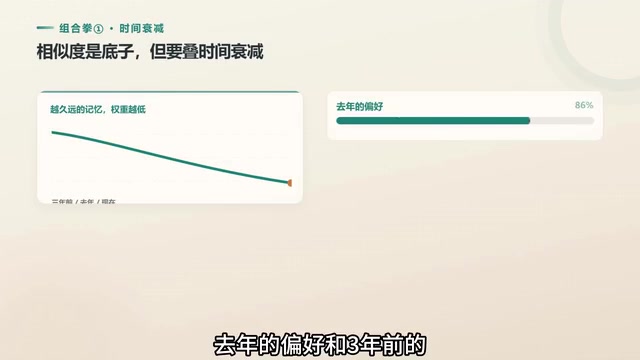
最后上混合检索:关键信息用关键词加向量双路召回,人名、型号、编号这类专有名词才不会被语义稀释掉。记住一句话:好的记忆检索找的不是"最像的",而是"此刻最该想起来的"。这正好回答了开头的全糖拿铁难题——通过时间衰减和冲突更新,最新的"空糖"偏好会胜出。
向量数据库的工作原理是将文本转换为高维数字向量,通过计算向量间的余弦相似度或欧氏距离来衡量语义接近程度。这种方式擅长捕捉语义相似性——即使措辞不同,"我不吃甜食"和"我偏好低糖饮食"也会因语义接近而被召回。但纯语义检索有两个内生缺陷:一是对专有名词(型号、人名、编码)不敏感,因为这类词在向量空间中缺乏稳定的语义锚点;二是完全忽略时序信息,无法区分一条记忆是昨天写入的还是三年前的。混合检索(Hybrid Retrieval)将向量检索与基于关键词的稀疏检索(如 BM25)并行执行,再通过倒数排名融合(RRF)等策略合并结果,兼顾语义覆盖与精确匹配,是目前生产环境中的主流方案。
第四问:窗口有限,怎么办?
外部记忆再强,上下文窗口还是有限的。解决思路是让上下文"学会呼吸",快满的时候做分层压缩:最近几轮保留原文,更早的压成一段摘要,一个月前的浓缩成一条记忆转存长期库。
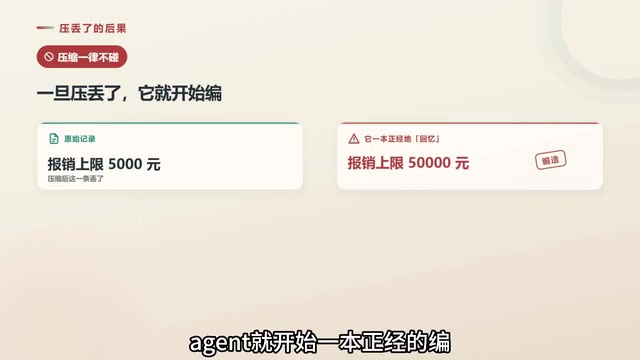
这里有个坑,很多人是踩过才懂:关键数字必须锁定。系统提示词、用户的硬性要求、金额、时间节点,压缩一律不碰。一旦压丢了,Agent 就开始一本正经地编造,这是真实项目里最常见的翻车现场。
上下文窗口(Context Window)是大模型单次推理时能处理的最大 Token 数量,目前主流模型从 8K 到 200K 不等。尽管窗口在持续扩大,但代价不是线性的:更长的上下文意味着更高的推理延迟与成本,而且研究表明模型对"中间位置"信息的注意力会显著衰减(即"迷失在中间"现象)。因此即便窗口足够大,工程上仍需主动管理上下文内容的结构与优先级,而不是简单地将历史记录无限追加。分层压缩策略本质上是在延迟与信息完整性之间做显式权衡,保留"近期原文 + 中期摘要 + 远期关键事实"的三级结构,让模型始终在最高信噪比的上下文中工作。
第五问:Agent 会不会忘?
会,而且必须会。长期没人检索的、被新事实推翻的、价值很低的记忆,要降权、要淘汰。否则记忆库越滚越大,检索质量反而往下掉。
那怎么验证这套系统做得好不好?答案是隔天考卷:今天告诉它的事,明天换个问法再问一遍——记没记住、记没记错、不该记的有没有忘。业界已经有专门的长程记忆评测集,考察信息提取、跨会话推理、知识更新、时间推理,以及该拒答时拒答这五件事。能说出"记忆也要做评测",面试官对你的印象会完全不一样。
记忆评测目前是 Agent 工程中相对薄弱的环节。业界常用的评测框架(如 MemGPT 论文中的基准、LongMemEval 等)会构造跨多轮会话的测试场景,重点考察五个维度:单跳信息提取(能否准确复述用户说过的事实)、跨会话推理(能否整合多次对话中的信息得出结论)、知识更新(新事实能否正确覆盖旧事实)、时间推理(能否判断哪条记忆更新、哪条已过期),以及拒答判断(对于超出记忆范围的问题不应捏造答案)。将记忆系统纳入自动化评测 Pipeline,与功能测试并列运行,是保证长期稳定性的工程实践基础。
五问背后,考的是三件事
走完这五问,本质上考察的是三种能力。
结构化思维:先分类再动手,别拿"向量库"三个字打发所有问题。踩坑经验:冲突怎么更新、压缩会丢什么、检索为什么不能只看相似度。闭环意识:记住了不算完,得能验证记得对不对、该忘的忘没忘。
没跑过项目的人回答的是"记忆是什么",跑过项目的人回答的是"记忆怎么不翻车"。分水岭就在这里。对于正在构建 Agent 应用的开发者来说,这套架构不仅是面试考点,更是决定产品体验能否长期稳定的核心工程问题。
相关推荐
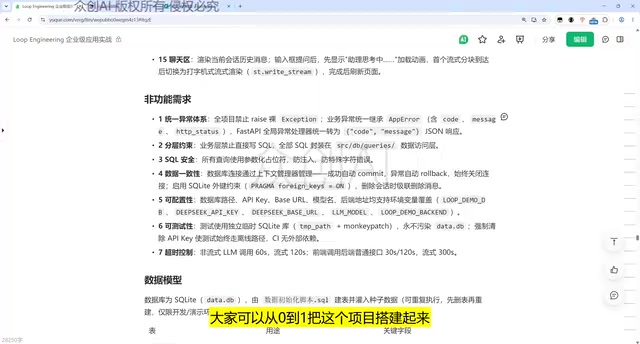
用Claude Code从零构建企业AI助理:Loop工程实战全解析
本文详解如何用Claude Code从零构建企业AI助理系统,涵盖Loop工程需求设定、Streamlit前端、FastAPI接口分层、DeepSeek API配置、项目启动与pytest自动化测试全流程,是AI编程实战的完整参考。
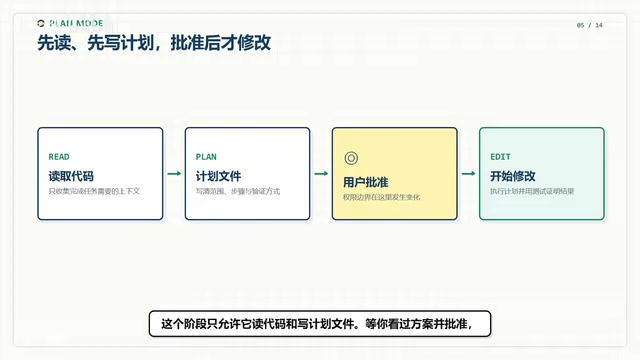
26K Star 的 Grok Build:与 Codex、Claude Code 差在哪?
26K Star 的 xAI 开源终端编程 agent Grok Build 与 Codex、Claude Code 有何差异?本文从工作方式、扩展能力、权限沙盒和费用四个维度深度对比三款 AI 编程工具,帮你做出选型决策。
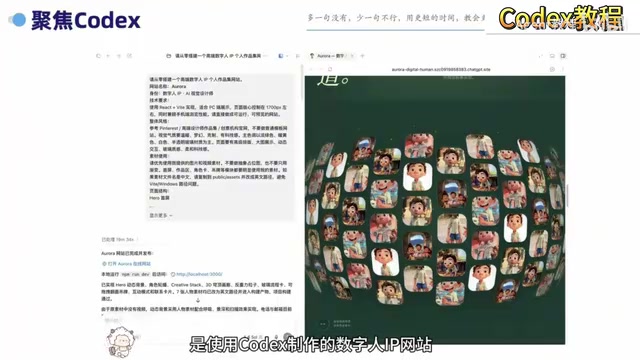
Codex完整入门指南:从安装到实战的AI编程工作流
Codex是OpenAI打造的AI编程Agent,能自主完成代码编写、网站制作等任务。本文详解Codex是什么、与Claude Code等工具的区别、并入ChatGPT桌面应用后的使用方式,以及从安装注册到实战开发的完整上手流程。