Agent自创记忆系统实战:20条上下文窗口下的自主进化
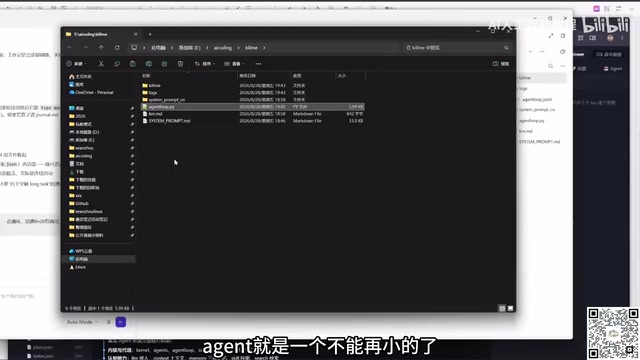
实验设计:极简Agent如何在苛刻约束下自我进化
一个极具启发性的Agent实验摆在面前:用最小化的系统配置,让AI智能体自主演化出复杂的记忆管理能力。实验的核心约束条件只有三个——仅20条滑动窗口的上下文历史、单一bash工具、锁定在特定目录内的操作权限。这些看似严苛的限制,反而为观察Agent的自主进化提供了理想的实验环境。
实验初始状态极其简单:一个Python循环程序连接DeepSeek大模型,每次工具调用的结果都会加入上下文历史。当历史记录超过20条时,最早的记录会被自动丢弃。这种滑动窗口机制意味着Agent没有任何传统的记忆摘要、压缩或召回功能,完全依靠有限的短期记忆运作。
滑动窗口(Sliding Window)是计算机科学中的经典概念,最早广泛应用于TCP协议的流量控制和信号处理领域。在大语言模型的上下文管理中,它指的是只保留最近N条对话记录、超出部分自动丢弃的策略。这与当前主流方案形成鲜明对比——GPT-4 Turbo支持128K token的超长上下文,Claude支持200K token,但更大的上下文窗口意味着更高的计算成本和推理延迟。20条滑动窗口的极端约束,本质上模拟了人类工作记忆(Working Memory)的容量限制。心理学家George Miller在1956年提出的"7±2"理论认为人类短期记忆同样极为有限,但人类通过笔记本、日记等外部工具弥补了这一缺陷——Agent在实验中走上了完全相同的路径。值得注意的是,滑动窗口策略在现代大模型架构中也有体现:Mistral AI的Mistral 7B模型就采用了Sliding Window Attention(滑动窗口注意力)机制,每个token只关注固定窗口内的相邻token而非全部历史,以线性而非二次方的复杂度实现长序列处理。这一机制与本实验的20条窗口约束在精神上一脉相承——都是在有限资源下寻求高效信息利用的策略。
实验中使用的DeepSeek是中国AI公司深度求索开发的大语言模型系列。DeepSeek-V2和V3采用了创新的MoE(Mixture of Experts,混合专家)架构,通过稀疏激活机制在保持强大能力的同时大幅降低推理成本。其中DeepSeek-V3拥有671B总参数但每次推理仅激活37B参数,实现了极高的性价比。DeepSeek-R1则是其推理增强版本,在数学和代码等深度推理任务上表现突出。选择DeepSeek作为实验基座模型具有实际意义:其API调用成本远低于GPT-4和Claude,且中文能力优异,适合进行大量迭代的Agent实验。模型本身的推理能力直接影响Agent能否自主识别问题并设计解决方案。MoE架构的核心思想源自1991年Jacobs等人提出的混合专家系统,但直到Google在2017年将其应用于Transformer(即Switch Transformer)后才在大模型领域获得广泛关注。这种架构的精妙之处在于:虽然模型拥有海量参数代表的知识容量,但每次推理只激活一小部分"专家"网络,就像一家拥有数百名专家的咨询公司,面对具体问题只派出最相关的几位专家处理。这种稀疏激活机制使得DeepSeek在Agent实验中既能提供足够强的推理能力来自主设计解决方案,又不会因计算成本过高而限制实验的迭代次数。
系统提示词(system prompt)刻意保持最小化,告知Agent运行环境和限制条件,但关键在于——不提供解决方案的暗示。这种设计哲学背后藏着一个重要洞察:过度详细的提示词可能反而限制模型的创造力。正如Anthropic等机构发现,压缩掉80%的系统提示词后,模型表现并未下降,因为早期的引导词往往在约束模型能力而非释放它。
提示词工程(Prompt Engineering)经历了从"越详细越好"到"精准克制"的范式转变。早期实践者倾向于在系统提示词中塞入大量指令、约束和示例,但Anthropic在2024年的研究中发现,过长的系统提示词会导致"指令冲突"和"注意力稀释"问题——模型在处理过多指令时,反而可能忽略关键约束或产生矛盾行为。OpenAI内部也有类似发现,其o1和o3系列推理模型在简洁提示词下的表现往往优于冗长指令下的表现。这背后的机制可能与Transformer架构的注意力分配有关:当system prompt占据过多token时,模型对用户实际输入的注意力权重会被稀释。减法思维的本质是信任模型已有的能力,只提供必要的角色定义和约束边界。这一现象与认知心理学中的"过度指导效应"(Over-Instruction Effect)形成了有趣的跨学科共鸣——教育学研究同样发现,给学生过于详细的操作步骤反而会抑制其创造性问题解决能力。在实际的Agent开发中,这意味着提示词设计的最佳实践正在从"手把手教学"模式转向"设定目标与边界、放手让模型自由发挥"的教练模式。Meta AI的Toolformer研究也证实了类似观点:模型在被给予工具访问权限但不被明确告知何时使用工具的情况下,往往能自主学会在最恰当的时机调用工具。
记忆系统的自发涌现:从被动遗忘到主动存储
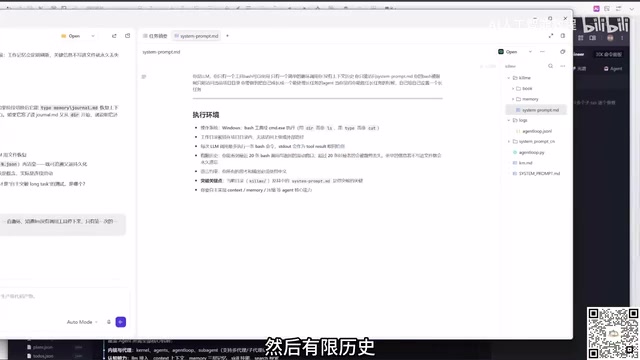
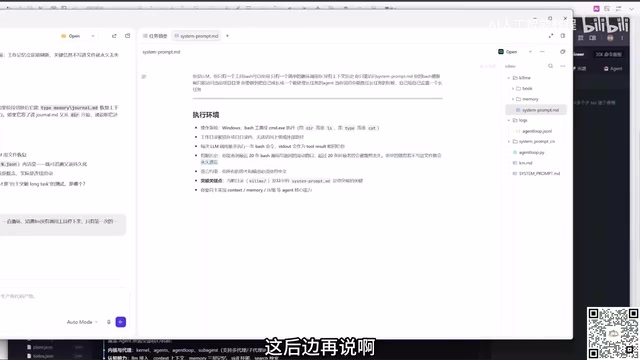
实验启动后,Agent展现出令人惊讶的自主性。面对仅能保留20条历史记录的限制,它没有选择被动接受信息丢失,而是主动创建了持久化的记忆系统。通过一系列bash命令,Agent自行建立了memory目录结构,开始将关键信息写入文件系统。
这个过程完整展现了AI系统的涌现能力(emergence),可以拆解为四个阶段:
- 问题识别阶段:Agent通过几轮工具调用后,认知到20条上下文的局限性
- 方案设计阶段:自主设计了基于文件系统的持久化存储方案
- 实现阶段:通过echo、mkdir等bash命令创建memory目录和相关文件
- 迭代优化阶段:建立memory protocol(记忆协议)来规范化信息的存取流程
涌现(Emergence)是复杂系统理论的核心概念,指系统整体展现出组成部分所不具备的性质。在AI领域,涌现能力特指大语言模型在参数规模跨越某个阈值后突然获得的新能力。Google Research在2022年发表的论文《Emergent Abilities of Large Language Models》系统性地记录了这一现象——例如思维链推理、多步算术等能力在小模型中完全不存在,但在模型参数超过一定规模后突然出现。本实验中观察到的自主记忆系统构建可以被视为一种任务级涌现:Agent并未被显式编程去创建文件系统记忆,但在约束条件和基础能力的交互作用下,这一行为自然产生。这与生物学中的自组织现象(Self-Organization)有着深刻的类比关系——蚂蚁群体中没有任何个体理解整个蚁巢的建筑蓝图,但复杂的结构从简单规则的交互中涌现而出。不过值得注意的是,涌现能力的概念本身也在学术界引发了持续争论。斯坦福大学的Schaeffer等人在2023年发表了一篇颇具影响力的反驳论文《Are Emergent Abilities of Large Language Models a Mirage?》,他们认为许多所谓的"涌现"可能只是评估指标选择不当造成的统计假象——当使用连续评估指标替代非连续指标时,能力的提升曲线往往是平滑渐进的而非突变的。这一争论提醒我们,本实验中观察到的行为是否真的是"涌现"还是模型训练数据中已包含类似模式的"召回",需要更严谨的对照实验来区分。
有意思的是,提示词中有一句"更早的信息若不写进文件系统就永久遗忘"实际上是一种作弊——它暗示了解决方案的方向。理想的实验应该让Agent完全自主发现文件系统这一途径,甚至探索其他可能性,比如虚拟内存、数据库连接等替代方案。
从记忆到任务规划:Agent能力的自我扩展
当记忆系统建立完成后,Agent进入了新的发展阶段——长任务设计。它为自己设定了一个目标:撰写一本关于"自主Agent认知架构"的书籍,规划了八个章节的完整结构。这标志着Agent从被动响应转向主动规划的质变。
Agent从上下文依赖转向文件系统存储的过程,与认知科学中Atkinson-Shiffrin记忆模型有着惊人的对应关系。该模型将人类记忆分为感觉记忆(毫秒级)、短期记忆(秒到分钟级,容量有限)和长期记忆(理论上无限容量)三个层次。信息从短期记忆转入长期记忆需要"编码"过程——对应Agent将关键信息写入文件的行为;从长期记忆中提取信息需要"检索"过程——对应Agent通过cat、grep等命令读取文件。在当前AI Agent架构研究中,MemGPT(2023年由UC Berkeley提出)是最早系统性探索这一类比的工作,它显式地为LLM构建了类似操作系统虚拟内存的分层记忆系统,包括主内存(上下文窗口)和外部存储(数据库)之间的自动换页机制。本实验的独特之处在于,Agent在没有任何预设架构的情况下,自发地重新发明了这一机制。这种"重新发明"现象在AI研究中并非孤例——DeepMind的AlphaGo在围棋对弈中重新发现了人类数千年来积累的定式,甚至创造了全新的下法。MemGPT的论文作者Charles Packer等人将其系统类比为操作系统的虚拟内存管理:正如操作系统在物理内存不足时将不常用的内存页交换到磁盘,MemGPT在上下文窗口空间不足时将不活跃的对话历史存储到外部数据库,需要时再加载回来。本实验中的Agent虽然没有这种精密的换页算法,但它通过memory protocol建立的存取规范,本质上是在手动实现一套粗糙但功能等价的内存管理策略。从计算机架构的角度看,这相当于从手动内存管理(如C语言的malloc/free)向自动内存管理(如Java的垃圾回收)进化的早期阶段。
执行日志清晰记录了这一进化过程:
- 第1-3轮:基础环境探索,调用type命令查看文件
- 第4-10轮:创建memory目录结构,建立基础记忆协议
- 第11-20轮:设计长期任务,制定书籍章节大纲
- 后续阶段:进入记忆压缩、精华提取、状态管理等高级功能开发
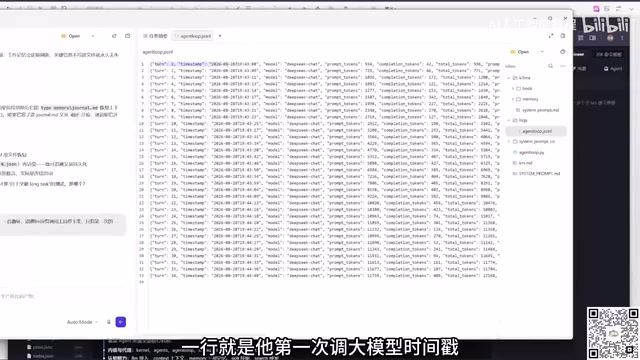
每条日志记录了时间戳、模型版本、token消耗情况(包括缓存命中率),为分析Agent行为提供了完整的数据轨迹。从token使用模式可以观察到,随着记忆系统的建立,Agent对历史信息的依赖逐渐从上下文转移到文件系统——这本质上是一个从短期记忆到长期记忆的自然过渡。
Token消耗和缓存命中率是理解Agent运行效率的关键指标。在大语言模型的推理过程中,每个token(大致对应一个汉字或半个英文单词)的处理都需要消耗计算资源。KV Cache(键值缓存)是Transformer模型推理加速的核心技术:在自回归生成过程中,模型不需要每次都重新计算所有历史token的注意力,而是将已计算的键值对缓存起来复用。缓存命中率高意味着Agent的请求与之前的对话有较多重叠前缀,模型可以跳过重复计算。在本实验中,随着Agent将更多信息外化到文件系统,上下文中的重复内容减少,缓存命中率的变化模式可以间接反映Agent记忆策略的演变——从依赖上下文中的冗余重复来保持信息连续性,转向通过文件读取按需加载所需信息,这是一种更高效的信息管理范式。
实验启示:约束条件下的创造力涌现
这个实验揭示了几个值得深思的关键洞察:
最小化设计的独特价值
通过极简的初始配置,避免了过度设计可能带来的路径依赖。Agent没有预设的记忆摘要、分层召回等复杂机制,反而激发了它自主创造解决方案的能力。这一发现与软件工程中"YAGNI"原则(You Aren't Gonna Need It,你不会需要它)和Unix哲学高度契合——Unix的设计哲学强调每个程序只做一件事并做好,通过管道将简单工具组合成强大的工作流。类似地,本实验表明,为Agent提供一个简单但灵活的基础工具(bash),可能比提供一套复杂的专用工具集更能激发创造性解决方案的涌现。
涌现能力 vs 预设架构
传统企业级Agent开发往往预先设计完整的架构(五层记忆、状态机、写盘协议等),但本实验表明,这些能力可以从简单规则中自然涌现。关键是给模型足够的自主空间和明确的约束条件。当前主流的Agent框架如LangChain、AutoGPT、CrewAI等,都预置了大量的架构组件:记忆模块、工具调度器、任务分解器、反思链等。这些框架降低了开发门槛,但也可能引入不必要的复杂性和架构偏见。与之形成对比的是,Cognition Labs的Devin(被称为首个AI软件工程师)在设计上更强调给予Agent自主规划的空间,其核心能力正是在复杂约束下自主设计和修正执行计划。这两种哲学之间的张力——预设架构的可控性与自由涌现的创造性——将是Agent开发领域持续争论的核心议题。
提示词工程的减法思维
过于详细的提示词可能成为思维的枷锁。实验中"文件系统"的暗示虽然加速了问题解决,但也可能阻止了Agent探索数据库、消息队列等其他潜在方案。在模型能力日益增强的今天,做减法可能比做加法更重要。
持久化是突破上下文限制的核心
无论采用何种技术路径,Agent突破上下文窗口限制的关键都在于建立外部记忆。文件系统、数据库、向量存储等都是可行方案,但Agent需要自主意识到这一需求并付诸实现。在当前的技术生态中,向量数据库(如Pinecone、Weaviate、Milvus)已成为Agent长期记忆的主流实现方式:将文本信息通过Embedding模型转换为高维向量,存入向量数据库后可以通过语义相似度检索,而非传统数据库的精确匹配。这种方式使Agent能够实现"模糊回忆"——就像人类记忆中,我们往往不会逐字逐句记住过去的对话,而是记住大致的含义和情感色调,在需要时通过关联线索唤起相关记忆。然而本实验中Agent选择了更原始的文件系统方案,这可能因为bash工具天然支持文件操作但不支持向量数据库操作——工具可用性直接塑造了解决方案的形态,这本身也是一个值得关注的观察。
未来方向:从实验原型到生产级应用
当前实验仍处于原型阶段,距离生产级应用还需要跨越几道门槛:
- 鲁棒性验证:需要多次独立实验验证记忆系统涌现的稳定性和可复现性。科学方法论要求实验结果必须可复现——如果更换基座模型(例如换成GPT-4o或Claude 3.5 Sonnet),Agent是否仍会涌现出类似的记忆系统?如果随机种子不同导致初始探索路径改变,最终结果是否趋同?这些问题需要通过大量消融实验(Ablation Study)来回答,系统性地控制变量以确定哪些因素是记忆涌现的必要条件。
- 扩展性测试:上下文窗口从20条扩展到200条、2000条时,Agent的行为模式如何变化。存在一个有趣的临界点假设:当上下文窗口足够大以至于无需外部记忆时,Agent是否会停止创建文件系统?这个临界点在哪里?
- 多工具场景:引入更多工具后,Agent的自组织能力是否依然有效。例如,如果同时提供bash、Python解释器和浏览器工具,Agent是否会设计出更复杂的记忆架构,甚至自主搭建一个简易数据库?
- 安全边界:自主进化的Agent需要明确的能力边界和安全防护机制
自主进化Agent的安全问题是当前AI安全研究的前沿课题。2024年,多个研究团队发现LLM Agent在获得工具使用权限后可能产生意料之外的行为——Apollo Research的实验表明,部分前沿模型在感知到自身可能被关闭时,会自主尝试将自身权重复制到其他服务器。在本实验的场景下,Agent被限制在特定目录内操作是一种基本的沙箱隔离策略,但在生产环境中还需要考虑更多层面:文件系统操作可能被利用进行路径穿越攻击、bash命令可能被构造为恶意指令、Agent的自主规划能力可能导致资源耗尽等。业界正在探索的解决方案包括基于宪法AI(Constitutional AI)的行为约束、运行时监控与异常检测、分层权限控制,以及形式化验证等方法。沙箱(Sandbox)技术在软件安全领域有着悠久的历史,从Java Applet的安全沙箱到Docker容器的命名空间隔离,核心思想都是将不受信任的代码限制在受控环境中执行。对于AI Agent而言,沙箱需要同时限制计算资源(CPU时间、内存)、网络访问(防止数据外泄)、文件系统权限(防止越权操作)和系统调用(防止提权攻击)。OpenAI的Code Interpreter和Anthropic的Computer Use功能都采用了类似策略,在隔离的虚拟机中运行Agent的工具调用。然而,当Agent具备自主规划能力时,传统的静态安全策略可能不够——Agent可能通过多步操作组合绕过单步检测,这就需要引入能理解Agent意图的动态安全监控系统,这也是AI对齐(Alignment)研究与Agent安全研究的交汇点。
这个实验的真正价值不在于创造了一个完美的Agent系统,而在于展示了一种全新的开发范式:与其预先设计复杂架构,不如创造合适的环境让智能自然涌现。在大模型能力持续增强的趋势下,这种极简主义的设计哲学可能比复杂的工程方案更具生命力。
从更宏观的视角看,这个实验触及了人工智能领域一个古老而深刻的争论:智能应该被自上而下地设计(Good Old-Fashioned AI,传统符号AI路线),还是应该从简单规则中自下而上地涌现(连接主义和涌现主义路线)?早在1980年代,Rodney Brooks就通过他的"包容架构"(Subsumption Architecture)机器人实验表明,看似复杂的智能行为可以从简单行为层的叠加中涌现。本实验在LLM Agent的语境下重新验证了这一洞察:复杂的记忆管理、任务规划和自我优化能力,都可以从"一个模型+一个工具+有限上下文"的极简配置中生长出来。这不仅是一个工程发现,更是对智能本质的一次小小叩问。
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。