AI Agent 反编译游戏:REA 让 Ghidra 自动写 C 代码

REA 用 MCP 协议把 AI agent 接入 Ghidra、IDA 和 Hopper,降低单函数反编译门槛,但完整游戏仍是重工程。
REA 是一个开源 MCP server 加 coding agent skill,一条 npx 命令即可安装。它把 Ghidra、IDA、Hopper 三个反汇编器的差异抽象成统一工具接口,让 agent 只学一次调用方式就能在任意工具中工作。官方演示中,agent 重写了 DXBall 的一个 sound panning 函数,识别出反编译器漏掉的隐藏输入,通过了 3,205 个测试用例且 63 个编译字节完全一致。但作者提醒,官方明确 caveat:这只是一个函数。参照 Snowboard Kids 的 2,145 个函数、一位开发者 84 天的工程量,从单函数到完整游戏之间的差距并不会因为 AI 自动消失。REA 真正改变的是「填法」——把机械性重写交给 agent,人力集中在架构理解和疑难函数上。
游戏反编译通常意味着在反汇编器里熬上几个月。现在,一个叫 REA 的开源工具正在改变这个流程——它把 AI coding agent 直接接入了 Ghidra、IDA 和 Hopper。
REA 是什么:一个 MCP Server 加一套 Agent 技能
REA 的定位很明确:它不是一个新的反编译器,而是一层「AI agent 与反编译工具之间的桥」。技术上它是一个开源的 MCP server,同时附带一套给 coding agent 用的 skill。安装只需要一条命令:
npx rea-agents setup
这条命令会把 MCP server 和 agent skill 一起装好。装完之后,你的 coding agent 就能通过统一的一套工具接口去驱动 Ghidra、IDA 或 Hopper——不管你习惯用哪个反汇编器,agent 的操作方式是一致的。
这个设计思路值得注意的地方在于「统一接口」:传统上 Ghidra、IDA、Hopper 各有各的脚本体系和 API,跨工具迁移成本很高。REA 把它们抽象成同一组 tool,让 agent 只需要学一次调用方式。
MCP(Model Context Protocol) 是 Anthropic 于 2024 年底推出并开源的协议,用于把外部工具、数据源以标准化方式暴露给大型语言模型。可以把它理解成「AI 应用与外部能力之间的 USB-C 接口」:只要一个工具实现了 MCP server,任何支持 MCP 的客户端(Claude Desktop、Cursor、各类 coding agent)都能直接调用它,无需为每个 AI 产品单独写适配层。REA 采用 MCP,意味着它不是绑定某个特定模型的插件,而是可以被任何兼容客户端复用的一层服务。
Ghidra、IDA、Hopper 是逆向工程领域的三款主流反汇编/反编译工具:Ghidra 由 NSA 开源、免费,插件与脚本生态庞大;IDA Pro 是老牌商业标准,被广泛用于安全分析;Hopper 则是 macOS 平台上常见的商业替代品。三者的脚本 API 与工作流差异很大,这也是 REA 强调「统一接口」的价值所在。
Showcase:从 DXBall 的一个函数说起
REA 官方给的演示案例选得很聪明——一个来自 DXBall 的 sound panning 函数。DXBall 是 1996 年的 Windows 游戏,年代久远,正好是那种反编译工具容易翻车的目标。
演示中,反编译器给出的输出是不完整的。
接下来 agent 做的事情是这样的:它读取了函数的汇编指令,从中识别出一个被反编译器漏掉的隐藏输入,然后据此用 C 重写了这个函数。结果相当硬核——重写后的实现通过了 3,205 个测试用例,并且编译后的 63 个字节全部一致。
这个数字组合透露了两层信息。「3,205 个测试用例通过」说明行为层面等价,「63 字节全匹配」说明生成的机器码在字节级别也一致。对于反编译这种对精度极度敏感的任务,字节级匹配是一个相当强的验证信号。
字节级一致性(byte-identical match) 是反编译质量评估中最严格的指标之一。它不仅要求重写出的 C 代码在逻辑上等价,还要求用原工具链重新编译后,生成的机器码与原始二进制逐字节相同。这在逆向工程和「decompilation project」(如 sm64、Zelda 反编译项目)中被视为金标准——因为行为等价可以通过测试覆盖,但字节一致意味着编译器优化、寄存器分配、指令顺序等所有细节都被精确还原,几乎排除了「碰巧通过测试」的可能性。
测试用例数量(3,205 个) 这类数字通常来自对函数的穷举式或随机化输入验证:把原函数和重写函数放在同一数据集上跑,比较输出是否完全一致。它是一个行为等价性证据,与字节级匹配互为补充——前者证明「逻辑对」,后者证明「实现细节也对」。
但先别急着兴奋:一个函数 ≠ 一个游戏
演示本身附带了一个明确的 caveat。
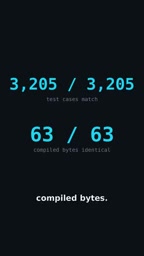
REA 做到的,是「一个函数」。而一个完整的游戏仍然是实打实的工程项目。为了说明规模差距,素材里给了一个参照:Snowboard Kids 有 2,145 个函数,一位开发者花了 84 天来完成。
把这个数字和演示对照一下就能看出问题——如果单个函数的处理还需要 agent 读取指令、识别隐藏输入、重写并验证,那么乘以 2,145 之后,工作量并不会因为「有 AI」就自动消失。反编译的难点从来不只在于写出等价的 C 代码,还在于理解函数之间的调用关系、数据结构布局、以及那些反编译器本来就容易出错的边界情况。
REA 的价值更可能体现在「降低单个函数的处理门槛」和「把机械性的重写工作自动化」,而不是「一键产出可编译的完整游戏源码」。
Snowboard Kids 的反编译参照 出自社区长期进行的主机游戏逆向项目。这类项目(例如 N64、PS1 游戏的 decompilation)通常以「函数覆盖率」作为进度指标,需要人工把每个函数翻译成原始 C 代码,并不断编译比对以确认与原 ROM 的机器码一致。2,145 个函数对应 84 天的工作量,平均每个函数超过半小时,其中大部分时间花在理解调用关系、结构体布局与边缘情况,而不是敲代码本身。这一数据也说明为什么作者强调「AI 改变的是填法,不是要不要填」——瓶颈往往不在写,而在理解和验证。
对逆向工程工作流的实际影响
从工具链角度看,REA 代表了一类正在成型的模式:把专业工具(Ghidra/IDA/Hopper)作为能力底座,用 MCP 这类协议把 agent 接进去,让 AI 负责「读指令、推断意图、写代码、跑验证」这一串动作。
对做逆向的人来说,这意味着几件事。重复性的函数重写可以交给 agent 先跑一轮,人力集中在架构级理解和疑难函数上。跨工具的成本降低了,同一套 agent 配置可以迁移到不同的反汇编器。验证环节变得更重要——案例里 3,205 个测试用例和字节级比对说明,可信度建立在可验证的基础上,而不是「agent 说它写对了」。
反编译游戏的入门门槛确实在下降,但从一个函数到一整个游戏之间,那 84 天的工程量仍然需要有人去填。REA 改变的是填法,不是要不要填。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。