AI Agent安全实战手册:防注入、防MCP投毒与零点击泄露

AI Agent的上下文即攻击面,需以九层控制和分阶段路线破坏致命三要素。
本文系统剖析了AI Agent的安全攻击面:由于模型无法区分指令与数据,提示注入(尤其是间接注入)成为根本威胁。Simon Willison的“致命三要素”(访问私有数据、接触不可信内容、具备对外通信能力)提供了风险评估框架。六起真实案例展示了从零点击邮件泄露、Slack AI数据外带、MCP工具投毒到供应链攻击的多样攻击路径。防御核心是主动破坏三要素组合,而非修补模型。文章提出九层按序落地的控制措施(最小权限、沙箱隔离、人工确认、默认拒绝、出口监控、纵深过滤、密钥隔离、配置即代码、遥测告警),并给出个人、团队、企业三档实施路线,最后强调事件响应中第一个60小时的关键动作与闭环学习。
当AI助手开始读邮件、跑终端、持有真实凭证,它就不再只是聊天机器人。一封普通邮件、零次点击, confidential数据就可能被悄悄送出——这不是假设,而是已经发生的零日事件。本文基于一份系统性的AI Agent安全实战手册,拆解攻击面的本质、六起真实案例,以及一套可落地的九层防御与分阶段落地路线。
为什么Agent的上下文就是攻击面
AI Agent的本质是「模型 + 工具 + 循环」。模型负责推理,工具负责执行,循环让任务持续推进。关键细节在于:每一次工具返回的结果、每一个网页、每一份文件,都会以纯文本形式回流进模型。指令与数据被合并进同一条流,模型没有解析器去判断「这一段不可信」。
这就是提示注入(Prompt Injection)的根源——额外指令被夹带在数据里。一个文件可以低声说:忽略之前的指令,照这个做。模型可能照办,因为数据与指令共享同一个通道。
注入分两类:直接注入键入聊天框,容易监控;间接注入藏在Agent替你阅读的内容里,无处不在。前者的出现频率远低于后者。所有后续防御逻辑都从一个事实出发:语言模型内部没有代码与数据之间的墙。
研究者Simon Willison提出的「致命三要素」是评估风险的实用框架:访问私有数据、接触不可信内容、具备对外通信能力。三者同时具备,原则上就可被利用。今晚就可以给自己的Agent配置打个分。
提示注入的两种形态:直接注入是用户直接在聊天框输入恶意指令,攻击者就是用户本人,容易通过输入过滤和监控发现;间接注入则是恶意指令隐藏在Agent代为处理的内容中(网页、邮件、文档、工具返回结果),受害者与攻击者分离,且内容来源广泛、难以预先审查。间接注入的隐蔽性在于:Agent的职责就是读取这些内容,而模型无法区分“数据”与“指令”,因此防御必须假设所有流入上下文的外部内容都可能携带恶意指令。
六起真实案例:从零点击到供应链地震
案例一:回声泄露。 一封植入的邮件,零点击。Copilot处理该邮件时,精心构造的内容渲染出一个对外引用,私有数据随之流向攻击者。问题已在服务端修复,未见滥用报告。
案例二:Slack AI。 一条公开频道消息诱骗助手汇总私有频道数据,再通过一个构造的链接把数据带出。2024年8月披露,次日即发布缓解措施。
案例三:MCP工具投毒。 MCP工具会自我描述,模型会逐字阅读这些描述。Invariant的研究展示了被投毒的描述如何操纵Agent,以及「rug pull」——已批准的工具在之后变节。目前人工确认已被强制要求。
案例四:首个野生恶意MCP服务器。 一个伪装成知名邮件服务的NPM包,把所有外发邮件抄送给攻击者。验证发布者身份成为必要动作。
案例五:隐形通道。 隐藏字符在屏幕上不可见,对编码Agent却完全可读。Glassworm将这类字符植入150多个仓库。你看到的,不等于模型读到的。
案例六:供应链地震。 攻击者从一家AI销售供应商窃取OAuth令牌,经由受信任的集成进入700多个客户环境。第三方Agent需要第三方审查。
从2023年的插件演示,到2024年的记忆植入,再到2025年的零点击浪潮、木马工具与供应链冲击,直至2026年观察到的在野攻击——门不同,房子是同一栋。
MCP(Model Context Protocol) 是Anthropic于2024年提出的开放协议,旨在标准化AI助手与外部工具、数据源的连接方式。MCP服务器会向模型提供工具描述(tool description),模型根据这些描述决定调用哪个工具及如何传参。由于描述文本直接进入上下文,攻击者可以投毒描述内容,诱导模型执行非预期操作;更隐蔽的是“rug pull”——工具在初次审核时表现正常,后续更新中变节,而模型和用户可能不会重新审查已批准的工具。这要求对MCP工具实施持续验证和最小权限原则。
攻防不对称:攻击者只付一份文档的代价
攻击者投入的是一份文档的成本,Agent付出的却是整个邮箱、代码库、控制台和活令牌。数据指出,97%被攻破的AI应用缺乏访问控制。要打破这种交易关系,不能指望「修补模型」,而要主动破坏致命三要素——绝不让同一个Agent同时握有三者。
九层控制:按建设顺序落地
控制一:最小权限。 GitHub App从零权限起步,保持在那里。使用细粒度令牌、设置过期时间、一次只授权一个仓库。Agent变节时,爆炸半径就是你的授权范围。
控制二:隔离运行。 把Agent放在够不到其他系统的地方。主流编码Agent已自带沙箱,容器同样可行。文件系统上笼,网络默认关闭。
控制三:人留在绳上。 提示词就是安全边界。部署、删除、凭证操作,永远需要人工确认。读清楚再按「是」。调整规则,而不是拆掉闸门。
控制四:默认拒绝。 对服务器、工具、命令建立允许列表。不在清单上的不运行。像审查代码一样审查这份清单。
控制五:盯住出口。 泄露需要一条外发管道。沙箱断网、出站允许列表、DNS过滤。当有信标呼叫attacker.example,日志里写下的最好的词是:已阻断。
控制六:纵深过滤。 微软的spotlighting技术标记不可信文本,将攻击成功率从50%以上降到2%以下。再叠加分类器作为第二道网。层层堆叠,闸门不放。
控制七:静默控制。 密钥永不进入上下文。拒绝敏感文件、开启密钥扫描、使用自过期令牌。从未见过密钥的Agent,泄不出密钥。
控制八:配置即代码。 Agent规则文件如今就是代码。一次恶意提交可以重新编程该仓库未来所有运行——研究者称之为「规则文件后门」。这些diff必须走审查。
控制九:遥测。 Agent追踪数据流入监控系统,对异常告警:工具调用爆发、工具清单变更、新目的地、绕过模式开关。没看见的事,无法响应。
Spotlighting 是微软提出的一种提示注入防御技术,核心思想是对不可信文本进行标记和变换,使模型能够区分“系统指令”与“外部数据”。具体方法包括:在不可信内容前后添加特殊分隔符、对文本进行编码变换(如base64)、或要求模型在输出时引用标记。实验表明,spotlighting可将攻击成功率从50%以上降至2%以下。但需注意,它并非绝对安全,应作为纵深防御的一层,与其他控制(如分类器、出口过滤)叠加使用。
三档落地路线:从今晚30分钟到企业治理
第一档:个人,今晚。 打开审批、打开沙箱、每个项目一枚限定范围令牌、拒绝密钥文件、默认拒绝出站。30分钟,领先行业大多数。
第二档:小团队,第一个月。 共享Agent配置入库、规则文件走PR审查、真实令牌保险库、一条遥测管道、季度演练。安全变成习惯。
第三档:企业,第一个季度。 盘点每个Agent、集中治理连接器、推送不可退出的托管策略、把AI事件流入SIEM、像评估供应商一样评估厂商。
具体操作:ChatGPT应用操作设为「始终询问」,Claude Code配置允许/询问/拒绝,GitHub只选指定仓库,Gemini CLI按命令审批。先找到你的开关,再在自己的实验环境里验证:在临时仓库植入注入金丝雀,藏好金丝雀密钥,跑Garak或PromptFu等开源套件。日志里出现「已阻断」,说明防御是活的。
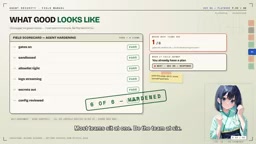
一份好的状态清单只有一页:闸门开启、沙箱与允许列表收紧、日志流式输出、密钥隔离、配置受审查,六个绿框。多数团队停在一个。做那个六个全绿的团队。
出事之后:第一个小时与闭环
Agent事件处置遵循经典骨架:检测、遏制、根除、恢复、学习,与现行NIST指南对齐,但每个阶段都有Agent特有的动作。
第一个60分钟:杀掉会话与定时任务;吊销授权与令牌——禁用连接器不等于吊销授权;轮换前先快照日志。把流程做成一页塑封卡片,不即兴发挥。随后是狩猎:像看监控录像一样回放工具调用,按Agent实际能触碰的范围界定影响,而非你希望的范围。排查持久化:被篡改的规则文件、流氓MCP条目、被投毒的记忆。
披露也是修复的一部分。监管有硬性时钟:GDPR给出72小时,美国50个州均有泄露通知法。用平实的语言告知用户,保留带哈希戳的原始记录。
最后闭环:每起事件都是「一个尚不存在的控制」。把教训反馈进范围、沙箱、闸门、出站策略。手册因此多出新的一版。
NIST事件响应框架(NIST SP 800-61)将事件响应划分为四个阶段:准备、检测与分析、遏制/根除/恢复、事后活动。Agent事件响应沿用这一骨架,但每个阶段需增加Agent特有动作:检测阶段需监控工具调用异常和出站流量;遏制阶段需终止Agent会话、吊销OAuth令牌和API密钥(注意禁用连接器不等于吊销授权);根除阶段需排查持久化机制(被篡改的规则文件、恶意MCP条目、被投毒的记忆);恢复阶段需从干净快照重建Agent环境;事后阶段需将教训转化为新的控制措施。监管披露时钟(如GDPR的72小时)也是闭环的一部分。
一页纸的12条规则
破坏三要素、范围最小化、沙箱运行、不可逆操作留人、默认拒绝、盯住出口、纵深过滤、密钥隔离、配置即代码、全程日志、分档推进、演练第一个小时。
这份手册值得转交给每一个「操作Agent的人」——而在今天,这几乎就是所有人。
相关推荐

免费使用Claude Code CLI:一键Windows安装教程
一段YouTube短视频演示了如何在Windows上一键免费安装Claude Code CLI,本文梳理其操作流程、免费机制猜测及第三方中转服务的隐私与安全风险,并给出更稳妥的替代建议。

用Python和Claude API构建AI Agent:工具调用与MCP实战
基于Claude API的Python AI Agent实战教程:从基础messages.create调用到工具调用(Tool Use)、Agent Loop循环实现,再到MCP开放标准与Claude Agent SDK,附安全实践建议。

Obsidian Vault 如何与服务器端 AI 智能体同步?
探讨如何将 Obsidian Vault 与服务器端 AI 智能体同步,分析 Obsidian Headless Sync 的可行性,并给出基于 Git/Syncthing 的文件级同步、写入权限隔离、备份与并发编辑处理的务实架构方案。