AI Agent工业级开发指南:从Demo到能扛业务的四层架构
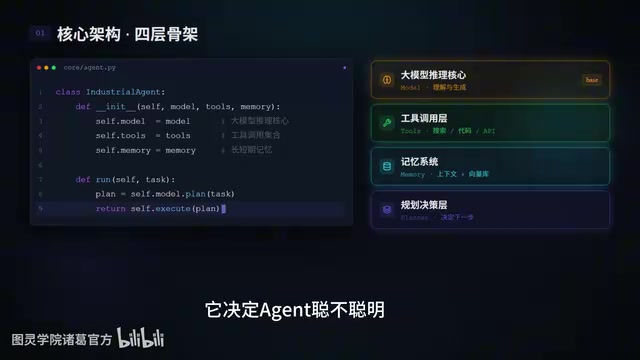
从Demo到工业级Agent,核心是用四层架构与ReAct循环保障稳定性、记忆与容错。
本文从"调通接口≠会做Agent"的认知误区切入,系统梳理了工业级Agent与玩具Demo之间的本质差距——稳定性、记忆和容错。文章介绍了工业级Agent的四层架构:大模型推理核心、工具调用层(Tools)、记忆系统(Memory)和规划决策层(Planner),并强调Planner才是决策者,Tools只是执行者。核心运行逻辑ReAct循环(思考→行动→观察)的稳定性直接决定Agent会不会绕圈或卡死,可观测性是从实验走向生产的关键。文章还通过三道实战题检验读者对架构职责的理解,并指出向量库作为长期记忆载体是RAG在Agent体系中的落地方式。最终结论是:能跑通一次不算本事,能稳定跑下去才是工业级。
会调大模型接口,就等于会做Agent吗?
很多开发者以为调通一次大模型接口就掌握了智能体开发,但这个认知偏差恰恰是Demo和工业级Agent之间的鸿沟。能跑一次的叫Demo,能扛住真实业务的才叫工业级。
据B站相关技术UP主的拆解,两者差距集中体现在三点:稳定性、记忆、容错。一个只能跑通单次任务的脚本,遇到真实业务的复杂输入、异常返回、长上下文场景时往往直接崩溃。工业级Agent的价值不在于能否完成一次任务,而在于能否稳定、可靠地持续运行。
这套逻辑背后其实是工程思维和玩具思维的本质区别——前者关注系统在边界条件下的表现,后者只关注理想路径能否走通。
工业级Agent的四层架构
一个完整的工业级Agent通常由四层构成,从下往上层层递进:
- 底层:大模型推理核心——整个系统的智力来源,负责语言理解与生成。
- 工具调用层(Tools)——让模型能真正操作外部世界,搜索、跑代码、调接口都在这一层实现。
- 记忆系统(Memory)——短期记忆负责上下文,长期记忆存入向量库。
- 规划决策层(Planner)——位于最顶层,决定Agent聪不聪明。
把项目拆开看会更清晰:Planner把模糊需求拆解成可执行的步骤,是Agent的"大脑";Tools是它的"手脚",负责实际执行;Memory则是它的"记忆库"。三者协同配合,Agent才能真正干活。
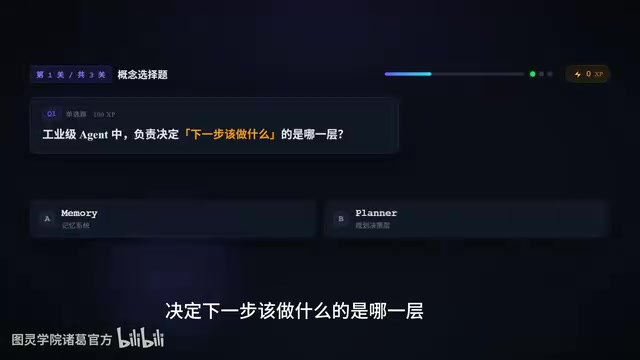
这种分层设计的好处在于职责解耦:决策与执行分离,让系统更易调试和扩展。一个常见的认知误区是把Tools当成决策者,实际上Tools只是执行者,真正决定"下一步做什么"的永远是Planner层。
ReAct循环:决定Agent会不会绕圈
Agent的核心运行逻辑被称为ReAct循环:先思考(Reason),再行动(Act),然后观察结果(Observe),接着继续思考,一圈一圈地转,直到任务完成。
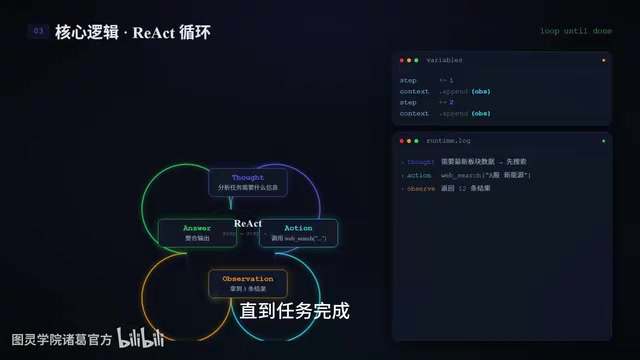
这个循环稳不稳,直接决定了Agent会不会绕圈、会不会卡死。在实际部署中,循环失控是最常见的问题之一:模型可能反复调用同一工具、陷入无意义的思考死循环,或者在观察到错误结果后无法有效修正路径。
从代码层面看,实现起来其实相当清爽:初始化Agent时传入模型、工具、记忆,然后一句 run 就够了。底层的日志会完整记录Agent自己思考、搜索、观察、总结的全过程——这也是调试Agent行为的关键窗口。可观测性做得好不好,往往决定了一个Agent项目能否顺利从实验走向生产。
ReAct(Reasoning + Acting)是由谷歌和普林斯顿大学研究者于2022年提出的提示框架,核心思想是将语言模型的推理过程与外部工具调用交织在一起,而非先推理完再行动。传统的Chain-of-Thought(CoT)只让模型"想",ReAct在"想"的每一步之后都插入一个"做"的动作,并将动作结果作为新的观察反馈给模型,从而形成闭环。这种设计解决了纯推理模式下信息过时、幻觉难以纠正的问题——当工具返回真实结果后,模型的下一轮推理有了事实锚点,显著降低了"一本正经胡说八道"的概率。在工程实现中,ReAct循环通常有最大步数限制(max_iterations)和超时机制作为安全阀,防止模型陷入无限循环,这也是从Demo升级到工业级时必须补上的工程细节。
三道实战关卡:检验你的掌握程度
理论讲完,来点真格的。通过三道关卡可以快速检验对Agent核心概念的理解。
第一关:谁决定下一步该做什么?
答案是 Planner(规划决策层)。它把大目标拆成小步骤,是Agent的大脑。这一关考察的是对"决策位置"的理解——很多人会误以为是模型本身或工具在做决策。
第二关:模块与职责连线
- Planner → 拆解目标
- Tools → 调用外部能力
- Memory → 保存上下文和长期知识
特别要注意:Tools是执行者,不是决策者,这一点最容易混淆。理清这层关系,才能在架构设计时把决策逻辑和执行逻辑正确分离。
第三关:补全代码
工具里配置 Code Runner 让Agent能执行代码,记忆里传入一个 向量库,最后用 agent.run 触发任务。三处填对,你就写出了第一版工业级Agent的雏形。
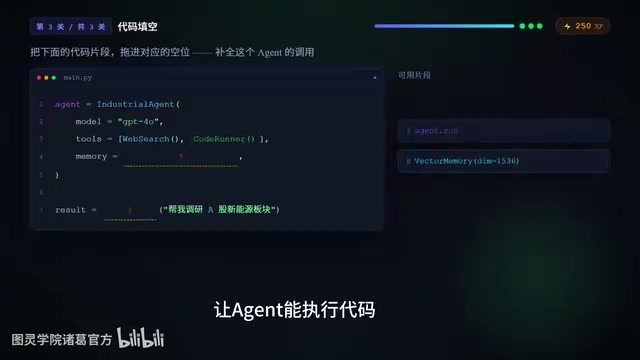
向量库作为长期记忆的载体,让Agent能够检索历史知识和外部文档,这也是RAG(检索增强生成)在Agent体系中的落地方式。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与大模型生成能力结合的技术范式。其基本流程是:将文档切片后通过嵌入模型(Embedding Model)转化为高维向量,存储到向量数据库(如Chroma、Pinecone、Milvus等);当Agent需要回答问题时,先将问题也向量化,在数据库中检索语义相似的文档片段,再将这些片段作为上下文拼入Prompt,让大模型基于真实材料生成回答。在Agent体系中,向量库承担的是"长期记忆"角色,弥补了大模型上下文窗口有限、无法记住历史对话和企业私有知识的天然缺陷。与短期记忆(当前对话上下文)不同,向量库中的知识可以跨会话持久存在,也可以按需更新,是企业级Agent落地的关键基础设施之一。
从"能跑"到"能扛"的距离
总结这套Agent开发方法论,核心要记住三个模块和一套循环:
- 三个模块:Planner(规划)、Tools(工具)、Memory(记忆)
- 一套循环:思考 → 行动 → 观察
更要记住那个最朴素的道理:能跑通一次不算本事,能稳定跑下去才是工业级。从Demo到工业级Agent,本质是从"验证可行性"到"保障可靠性"的跨越。
对于想要把Agent真正落地到企业业务的开发者来说,稳定性、记忆和容错能力才是需要长期打磨的核心,而这三者恰恰是当前大量Agent项目最容易被忽视的地方。
相关推荐
豆包工作实测:AI如何一天完成一周产品规划
一段B站爆款视频用「把老板做成AI宠物卖千万」的段子,实测了豆包工作这款AI Agent工具:从桌宠应用生成到可行性报告、商业计划书、PPT和网页Demo,一天完成一周产品规划。本文拆解其真实能力与营销边界。
AI超级员工系统实测:智能获客与Agent搭建功能拆解
本文基于B站教程拆解AI超级员工系统的三大核心功能:AI智能获客、企业智能体Agent搭建与微信私域自动化管理,客观分析其能力边界与合规风险,帮助创业者理性判断是否值得尝试。
WorkBuddy入门实战:腾讯AI智能体如何重塑职场办公
WorkBuddy是腾讯推出的AI智能体桌面工具,能读取本地文件、执行多步骤任务、定时自动运行。本文详解WorkBuddy入门用法及其与传统AI工具的核心区别,帮助职场人快速掌握Agent办公提效技巧。