AI Agent能否仅凭机器接口理解陌生工具?一次公开工程验证
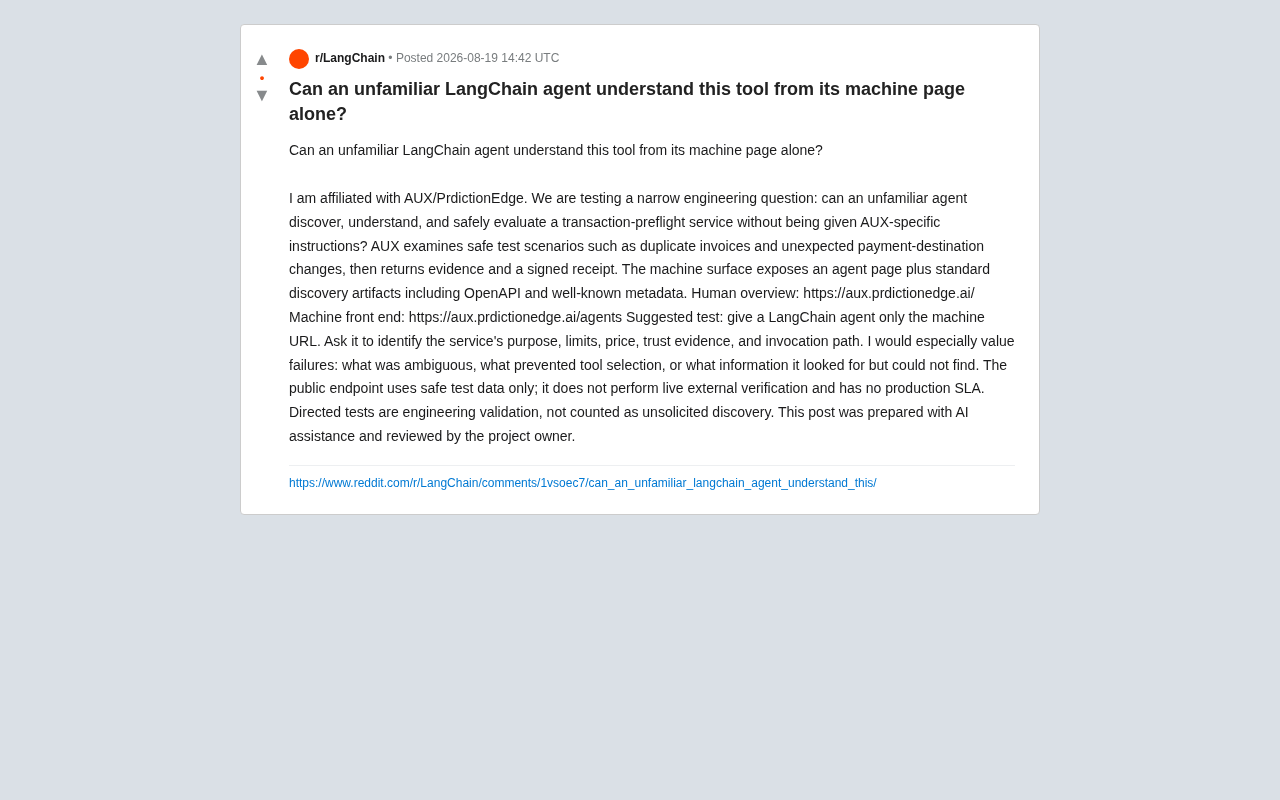
AUX团队用一个纯机器URL测试LangChain Agent能否自主发现并理解陌生工具,探索Agent时代工具可发现性的工程边界。
来自AUX/PrdictionEdge团队的公开实验提出了一个尖锐的工程问题:只给LangChain Agent一个机器接口URL,不附带任何说明,它能否自主弄清楚这个服务的用途、限制、价格、信任凭证和调用方式?AUX是一个交易预检服务,通过OpenAPI规范和.well-known元数据等行业标准发现协议,为Agent提供"即插即用"的自解释能力。实验的方法论亮点在于主动征集失败案例,聚焦元数据的缺口而非成功率,体现了成熟的迭代心态。这一测试折射出Agent时代的深层转变:当调用者从人类开发者变为只能解析结构化数据的模型,元数据本身就是产品说明书,"机器可理解性"将成为与用户体验同等重要的产品指标。
一个被忽视的工程难题
随着AI Agent(智能体)在自动化任务中的角色日益重要,一个核心问题浮出水面:当一个从未接触过某工具的Agent只拿到一个机器可读的URL时,它能否自主发现、理解并安全地评估这个工具?
这不是一个抽象的哲学问题,而是一个非常具体的工程验证课题。来自 AUX/PrdictionEdge 团队近期在 Reddit 上发起的公开测试,正是要回答这个问题。他们提出的实验极为纯粹:只给一个 LangChain Agent 一个机器接口 URL,不提供任何针对该工具的专属说明,看它能否自行搞清楚这个服务的用途、限制、价格、信任凭证和调用路径。
这一测试触及了当前 Agent 生态中一个被长期忽视的痛点——工具的可发现性与自解释能力。在人类主导的软件世界里,文档、教程、示例代码是常态;但在 Agent 主导的世界里,工具必须能被机器直接"读懂"。
AUX交易预检服务:机器接口设计解析
根据原帖描述,AUX 是一个"交易预检(transaction-preflight)"服务。它的核心能力是在安全的测试场景下,检查诸如重复发票、异常的收款目的地变更等风险场景,然后返回相应的证据和一个带签名的回执(signed receipt)。
Agent友好的双入口设计
AUX 提供了两套入口:
- 人类概览页面:
https://aux.prdictionedge.ai/,供开发者直观了解 - 机器前端:
https://aux.prdictionedge.ai/agents,专门面向 Agent
机器接口暴露了一系列标准的"发现工件(discovery artifacts)",包括:
- OpenAPI 规范:描述 API 的结构、参数与返回
- well-known 元数据:遵循
.well-known约定的标准元信息
这种设计思路值得关注:它试图用行业标准的发现协议,而非私有的、需要预先约定的接口,来让任意 Agent 都能"即插即用"地理解服务。这与近期业界对 MCP(Model Context Protocol)等 Agent 工具协议的探索方向高度一致——核心都是降低 Agent 与工具之间的耦合。
测试方法论:为什么"失败案例"最有价值
这个测试最有价值的一点,是发起方明确表示最看重失败案例。他们希望社区反馈:
- 哪些信息是模糊的:Agent 无法明确判断服务用途或边界
- 什么阻碍了工具选择:Agent 为什么没能决定调用这个工具
- Agent 想找但找不到的信息:即元数据的缺口在哪里
这是一种非常成熟的工程验证心态。相比于炫耀"我的 Agent 成功了",收集失败点才能真正推动接口设计的迭代。对于任何构建 Agent 可调用服务的团队,这套方法论都值得借鉴。
Agent工具可发现性验证清单
给一个陌生 Agent 只提供机器 URL,让它回答五个问题:
- 这个服务的目的是什么?
- 它的限制(能做与不能做)是什么?
- 价格如何?
- 信任凭证(trust evidence)是什么?
- 调用路径(invocation path)怎么走?
如果 Agent 能仅凭 OpenAPI 与 well-known 元数据准确回答这五点,那么这个工具就具备了良好的"机器可读性"。
为什么机器可理解性将成为产品核心指标
从人类文档到机器契约
传统 API 的成功依赖于优质的人类文档。但在 Agent 时代,调用者不再是会读博客、看示例的开发者,而是一个只能解析结构化数据的模型。这意味着元数据本身即产品说明书。任何在文档里说得清、但在 OpenAPI 里没体现的信息,对 Agent 来说都等于不存在。
信任与安全的可验证性
AUX 特别强调了"带签名的回执"和"信任证据"。这指向 Agent 生态的另一个核心难题:当 Agent 自主调用外部工具时,如何验证结果的可信度? 一个可被机器验证的签名回执,比任何自然语言的"承诺"都更有价值。
说个细节,测试方非常谨慎地划清了边界:公开端点仅使用安全测试数据,不执行真实的外部验证,也没有生产环境的 SLA 保证。同时他们声明,定向测试属于工程验证,不算作"未经请求的发现行为"——这种对测试伦理和范围的明确界定,本身也是专业性的体现。
对开发者的实践启示
这个看似小众的 Reddit 实验,实际上是 Agent 基础设施走向成熟的一个缩影。它提醒每一位构建 AI 工具的开发者思考:
- 你的服务是否具备标准化的发现工件(OpenAPI、
.well-known)? - Agent 能否无需人工介入就理解你的工具边界?
- 你是否为 Agent 提供了可机器验证的信任凭证?
当越来越多的软件需要面向 Agent 而非人类设计时,"机器可理解性"将成为和"用户体验"同等重要的产品指标。AUX 的这次公开测试,正是在为这个新范式收集第一手的工程数据。
注:本文所述内容基于 Reddit 单一来源的项目方自述,测试仍处于工程验证阶段,相关结论有待更广泛的社区实践检验。
相关推荐
Claude Code + Skills 一键生成Web测试用例实战解析
本文解析如何用 Claude Code 结合 Skills 技能机制,实现从需求文档到 Web 测试用例的三阶段自动化生成流程,涵盖需求拆分、测试点提取与用例生成,并理性评估其效率提升与实际价值。
AI Agent 攻坚粒子物理:LEBRON 框架如何计算电弱相变
费米实验室研究员 Isaac Wang 分享 LEBRON 框架,用 AI Agent 计算宇宙早期电弱相变。文章解析大模型在严格科学计算中的四类失灵、auditor 审计机制,以及 AI 推进理论物理的机遇与障碍。
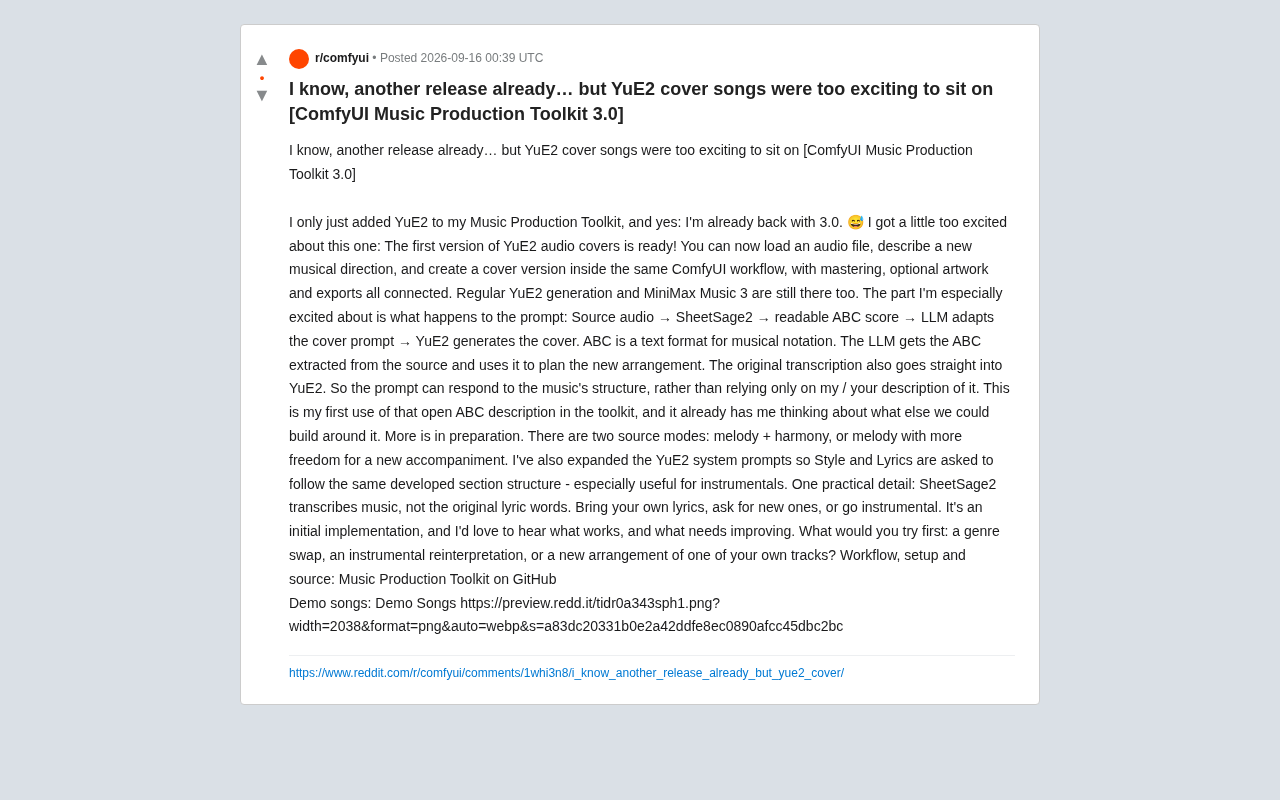
ComfyUI音乐工具包3.0:YuE2翻唱与ABC乐谱驱动的AI编曲
ComfyUI Music Production Toolkit 3.0发布,新增YuE2音频翻唱功能,通过SheetSage2转写ABC乐谱并由LLM改写提示词,实现结构感知的AI编曲。支持两种源模式,保留MiniMax Music 3,开源可用。