AI Agent如何工作:模型只发请求,代码才执行

模型只发工具请求,harness执行并记录,循环直到模型不再请求。
文章用诊所类比拆解AI Agent的工作机制:模型像一位零记忆的医生,只能写检查单(工具调用请求),harness像助理,负责实际执行并把结果钉进病历(历史)。每次调用,harness都重发系统提示词、工具列表和完整历史,因此token成本随步骤增长,提示词缓存只降价不减窗口。循环的终止条件是模型不再请求工具。文章还通过四个边界测试澄清常见误解,并提出三道必备护栏:回合或预算上限、高风险工具前的人类审批、严格schema加清晰错误信息,同时建议步骤固定时改用简单工作流。
AI Agent如何工作:模型只发请求,代码才执行
你输入“修复失败的测试”,编码Agent思考片刻,屏幕滚动几行,然后测试通过。但模型从未碰过你的终端——那是谁运行了测试?又是谁决定任务完成?这段来自YouTube的技术讲解用一个诊所类比拆解了Agent Loop的完整机制。
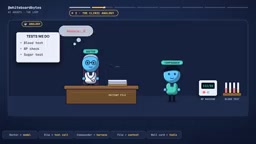
诊所类比:一个零记忆的医生
想象一家社区诊所。医生坐在桌前,只能写检查单——验血、量血压。诊所助理拿着单子去操作机器,再把报告带回来。每张单子和每份报告都被钉进病历夹。墙上贴着一张卡片,列出这家诊所唯一能做的检查项目。
关键转折在于:这位医生没有任何记忆。每次做决定前,她都要从第一页开始重读整本病历。当她觉得信息足够时,就写下处方而非新的检查单——就诊结束。
真实医生当然有记忆,但语言模型没有。这个画面是理解Agent的基础。
Agent的两个组成部分
一个Agent由两部分构成:模型负责阅读和决策,harness(运行框架)是你包裹在模型外面的代码。每次调用时,harness向模型发送三样东西:系统提示词、工具列表、以及完整的历史消息。
每个工具都有名称、简短描述和schema(即输入参数必须满足的形状)。这就像诊所墙上的检查项目卡片。示例Agent获得四个工具:运行测试、读文件、编辑文件、git push。
模型想使用工具时,并不写代码。它只是填一张小表单:工具名加参数,简单的键值对。比如 read_file 配 path: discount.py。这里的分工必须记住——模型只负责请求,harness负责执行并记录。
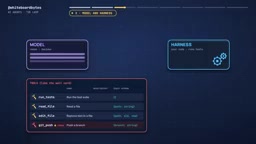
工具调用的schema是模型与harness之间的契约。它通常用JSON Schema描述,定义参数名、类型、是否必填,有时还包括枚举范围和描述文字。harness在把工具列表发给模型时一并附上schema,模型据此生成结构化合法的调用请求。harness收到请求后应先按schema校验参数形状,再执行实际逻辑;形状不符时返回结构化错误,让模型有机会修正。需要强调的是,schema只约束“长什么样”,不保证“值对不对”——路径可以是合法字符串,但文件未必存在,这类语义校验必须由harness的代码完成。
走一遍完整循环
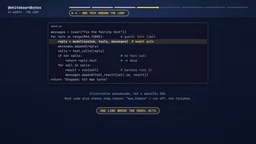
第一步,harness发送请求。第二步,模型回复一个工具调用,比如“运行测试”,不带参数——它自己不运行任何东西。第三步,harness在你的机器上实际运行测试。第四步,harness把结果作为新消息钉进历史:一个测试失败,折扣计算有误。第五步,用更长的历史再次调用模型——同一个医生重读更厚的病历。
随后加速播放:模型请求读文件,发现bug(折扣计算多了一个零),请求编辑文件,再请求运行测试,结果通过。此时模型不再请求工具,直接写出答案“已修复”。
谁决定任务结束?是模型——通过不再请求工具。harness看到没有工具调用,便停止循环。诊所里是五次到访、四张检查单和一张处方;代码里就是一个循环:调用模型,若请求工具则运行并追加结果,否则结束。
Agent Loop本质上是一个“调用—执行—追加—再调用”的while循环,而不是模型内部自主运行的过程。控制流始终在harness手里:它构造请求、解析模型回复、判断是否存在工具调用、执行工具、把结果以工具角色消息追加进历史,然后进入下一轮。所谓“模型决定任务结束”,准确说是模型输出中不再包含工具调用,harness据此跳出循环并把最后一条文本作为最终答案。这也是为什么回合上限、审批和错误处理都必须写在harness里——模型无法跳出自己的循环,只有外部代码能按下停止键。
被忽视的成本:每次调用都重发全部历史
模型没有记忆,所以每次调用都要重发系统提示词、工具列表、每一张检查单和每一份结果。输入随每次往返增长。在示例中,首次调用约发送1500个token,五次调用合计接近10000个token——每个新调用都携带所有旧步骤。步骤翻倍,近期历史大约增长四倍。
一次粗心读取大文件,之后每次调用都要重发它。这带来三重代价:花钱、增加等待时间(往返串行执行)、填满上下文窗口(模型有限的工作空间,越拥挤准确率越可能下降)。
一种常见缓解手段是提示词缓存:服务商把重复的开头准备好,重发更便宜也更快。
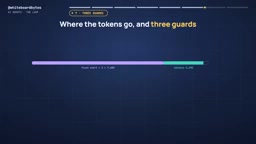
但缓存只是降低价格标签,不改变上下文窗口的高度——缓存token仍然计入窗口。
**提示词缓存(Prompt Caching)**是服务商侧的一项优化:如果多次请求的开头部分(系统提示词、工具定义、早期历史)完全相同,服务商可以复用已计算好的中间状态,避免重复计算,从而降低单价并缩短首token延迟。它通常要求前缀严格一致,一旦中间插入新内容,缓存就会从变化点之后失效。因此实践中的技巧是把稳定内容放前面、易变内容放后面。但缓存不改变模型一次能看多少token这一硬限制——被缓存的token依然占据上下文窗口,窗口填满时该截断还是要截断。
四个边界情况的测试
测试通过时,模型运行了测试吗? 没有。模型只写了请求,harness在你的应用中运行测试。
测试运行器在第四次调用时崩溃,整个Agent会崩溃吗? 不一定。设计良好的harness把错误作为标记为error的工具结果发回,模型读到后通常会尝试别的办法或给出解释。
开启提示词缓存后,上下文窗口填满得更慢吗? 不会。缓存让重复开头更便宜更快,但缓存token仍计入窗口。
在Claude Agent SDK中设置Max turns为3,五次调用的运行会怎样? 按其计数规则,turn 1、2、3分别运行测试、读文件、编辑文件,然后停止并报错——修复完成了但从未测试,也没有最终答案。护栏是安全网,不是终点线。
每个Agent都需要的三道护栏
第一道:回合或预算上限。 防止Agent永远请求工具。
第二道:高风险工具前的人类审批。 比如git push。当模型请求push时,harness暂停,展示确切命令并等待。你说不,拒绝作为工具结果返回,循环继续——模型通常换个思路或停下解释。
第三道:严格schema加清晰错误信息。 schema保证参数形状,不保证值正确。路径是合法字符串,但文件不存在——你的代码需要检查并返回清晰错误。
另外两条实践建议:保持工具输出精简;历史变长时压缩成简短摘要。
**人类审批(Human-in-the-loop)**的实现方式是在harness执行高风险工具前插入一个中断点:暂停循环,把模型请求的完整命令展示给用户,等待批准或拒绝。批准则照常执行;拒绝则不是抛出异常终止整个Agent,而是把“用户拒绝”作为一条工具结果消息追加进历史,让模型读到后自行调整策略。这种设计保留了循环的连续性,也把不可逆操作的控制权交回人类。审批点应设在有副作用且难以撤销的工具上,例如推送代码、删除文件、调用付费外部API,而不是每一次只读操作。
什么时候不该构建Agent
如果步骤永远不变,简单的固定工作流更便宜也更容易信任。第一次构建时从小处开始:写两三个命名清晰的工具,第一天就加上回合上限,记录每次调用和结果以便阅读trace,然后对任何高风险操作添加审批。
一句话总结:模型只负责请求,harness运行工具、钉住结果、再次询问,直到模型不再请求工具。加上三道护栏,你才拥有一个Agent。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。