AI Agent审计难题:如何证明智能体做了什么?
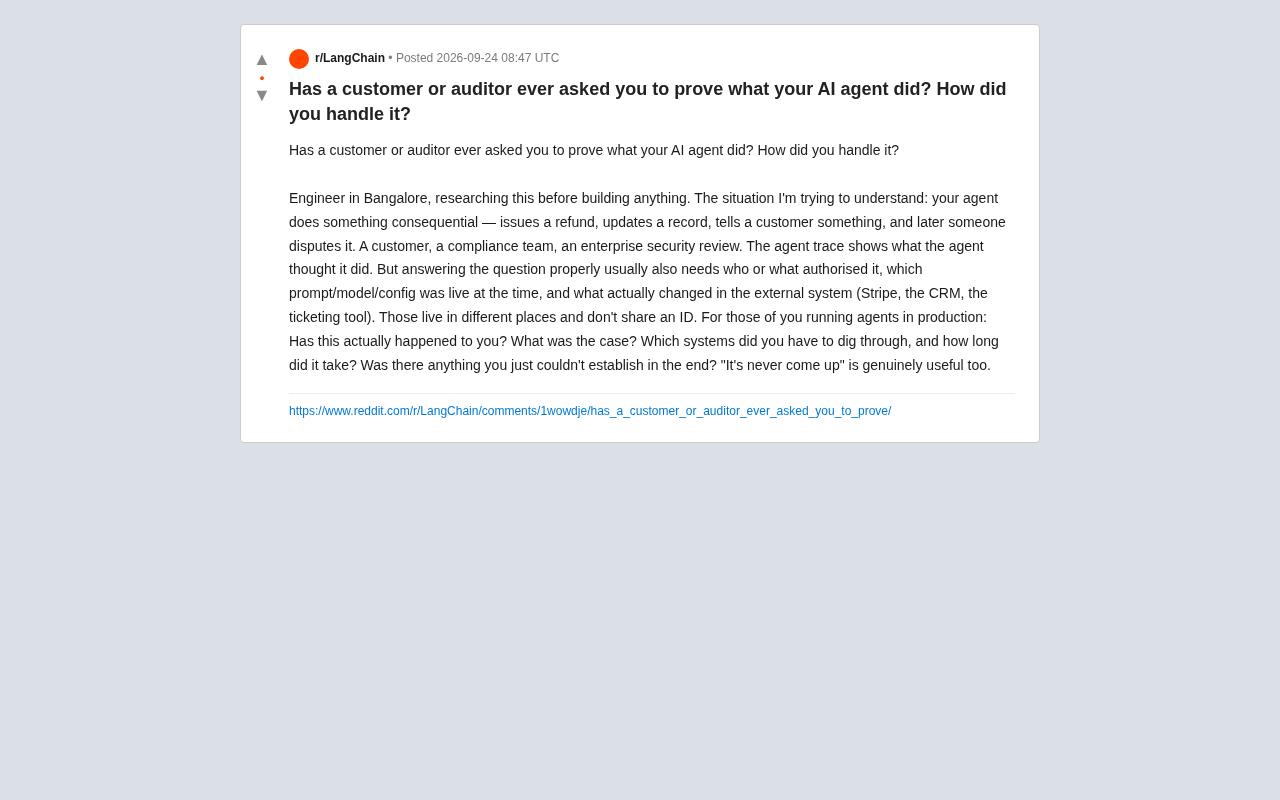
AI Agent进入生产环境,可审计性是商业落地不可忽视的核心工程挑战。
当AI Agent开始执行退款、修改记录等有实际业务后果的操作,"它做了什么"不再是一个简单的技术问题,而是涉及合规、法律和企业安全的审计挑战。本文指出,Agent的执行轨迹只记录了其自身意图,完整的责任追溯还需要三类信息:操作的授权来源、执行时的运行时配置版本,以及外部系统的实际变更结果。这三类数据分散在不同系统且缺乏共享关联ID,是当前AI Agent工程化落地中最容易被忽视却影响深远的软肋。面向金融、医疗等强监管行业,可审计性已是产品准入的硬性门槛,而企业安全评审也在将其变为商业合同能否落地的决定因素。文章建议开发者在架构早期就设计统一关联ID和运行时快照机制,而非等到问题发生后再补救。
一个被忽视的生产环境难题
当AI Agent(智能体)从演示环境走向真实业务,一个棘手的问题浮出水面:如果有人质疑智能体做过的某个操作,你能拿出证据吗?
一位来自班加罗尔的工程师在Reddit上抛出了这个问题。他正在构建AI Agent系统之前做前期调研,想搞清楚一个具体场景:假设你的智能体做了一件有实际后果的事——发起了一笔退款、更新了一条客户记录、或者向客户传达了某个信息——事后有人对此提出异议。质疑方可能是客户本人、公司的合规团队,或者是一次企业安全审查。
这个问题看似简单,实则触及了当前AI Agent工程化落地中最容易被忽视的软肋:可审计性与可追溯性。
智能体的"思考轨迹"远远不够
很多人以为,只要保存了Agent的执行轨迹(trace),就能回答"它做了什么"。但原帖作者一针见血地指出:agent trace只能展示智能体自认为它做了什么,而一次完整的责任追溯至少还需要三类信息:
- 谁或什么授权了这次操作——是用户点击确认,还是某个自动化策略触发?
- 当时运行的是哪个版本——具体的prompt、模型、配置在操作发生的那一刻是什么状态?
- 外部系统里究竟发生了什么改变——Stripe里真的产生了退款?CRM里的字段真的被改写了?工单系统里的状态真的流转了?
问题的核心在于:这些关键信息分散在完全不同的系统里,而且彼此之间没有共享的ID。Agent的日志在一处,授权记录在另一处,Stripe的交易流水又在第三方平台,CRM的变更历史则埋在SaaS工具的深处。当你需要把它们串成一条完整的证据链时,才发现根本无从下手。
在可观测性工程中,trace(执行轨迹) 是指记录一次请求从发起到完成的完整调用链,通常包含各步骤的时间戳、输入输出和状态码。对于AI Agent,trace还会包含LLM的推理步骤、工具调用序列和中间思考过程(如Chain-of-Thought的输出)。OpenTelemetry等开源标准已被广泛用于分布式系统的trace采集,部分Agent框架(如LangChain、LlamaIndex)也内置了trace导出能力。
然而,这类trace本质上是Agent的视角记录,即Agent"认为"自己做了什么,而非外部世界实际发生了什么。这与传统数据库的Write-Ahead Log(WAL)或事件溯源(Event Sourcing)架构有本质区别——后者记录的是已经提交并持久化的状态变更,具有更强的事实约束力。AI Agent的trace缺少这种"外部世界已确认"的语义,因此在责任追溯场景下存在先天不足。
为什么这是一个真实的工程痛点
传统软件系统里,每一次数据库写操作、每一次API调用都有明确的调用方、时间戳和事务ID,审计相对直接。但AI Agent引入了新的不确定性维度:
决策过程的非确定性。 同样的输入,不同版本的模型或prompt可能产生不同的行为。如果没有记录"当时运行的是哪个配置",你甚至无法复现问题,更别说解释它为什么这么做。
授权链条的模糊性。 智能体常常在半自动或全自动模式下运行,一个操作背后可能是用户授权、也可能是某条规则或另一个上游Agent触发的。这条授权链如果断掉,责任归属就成了悬案。
跨系统的状态割裂。 Agent声称"我发起了退款",但这只是它的意图记录。退款是否真的在Stripe成功执行、金额是否正确、有没有被后续操作回滚,这些真相只存在于外部系统,而它们与Agent的日志之间缺少关联标识。
解决跨系统关联问题的一种成熟模式是分布式追踪中的Correlation ID(关联ID):在一次业务操作发起时生成全局唯一标识符,并随调用链传播到每个下游系统,使得散落在不同日志中的记录可以被重新串联。这一思路已在微服务架构中广泛应用,但在AI Agent场景中需要额外覆盖:将同一个ID写入LLM调用记录、工具调用参数、以及外部系统(如Stripe的metadata字段、CRM的备注字段)。
另一个相关概念是不可变审计日志(Immutable Audit Log),即操作记录一经写入就不可修改或删除,通常通过append-only存储或加密哈希链(类似区块链的思路)实现。这与普通应用日志的最大区别在于:它设计的第一目的是"事后可证明",而非"实时可观测"。对于承担高风险业务操作的Agent,这两种机制的结合是构建完整责任追溯链的工程基础。
合规与企业采购正在放大这个需求
原帖特别提到了三种质疑来源:客户争议、合规团队、企业安全审查。这三者恰恰对应了AI Agent商业化落地必须跨越的门槛。
对于面向金融、医疗、法律等强监管行业的Agent产品,审计能力不是加分项而是准入条件。当审计员问"证明你的智能体在这笔交易中做了什么"时,一句"我们有执行日志"是远远不够的——审计员要的是从授权、决策到外部系统实际变更的完整闭环证据。
企业安全评审同样如此。采购方的安全团队会追问:如果Agent做错了事,你们多久能定位、能否还原当时的完整上下文、有没有什么是永远查不清的。这些问题的答案,直接决定了一笔企业订单能否成交。
在强监管行业,可审计性的要求有明确的法规依据。金融领域的SOX法案(萨班斯-奥克斯利法案)要求企业保留完整的业务操作记录以供审计;医疗领域的HIPAA要求对涉及患者数据的每次访问和修改留存访问日志;欧盟的AI Act(人工智能法案)对高风险AI系统明确要求具备日志留存和人工审查能力,且日志须能追溯到具体决策时刻的系统状态。
对于希望向企业客户销售Agent产品的团队,SOC 2 Type II认证是常见的安全审查门槛,其中"可用性"和"处理完整性"控制项会直接考察操作记录的完整性与可核查性。这意味着可审计性不仅是技术设计问题,更是影响合规认证和商业合同签署的业务问题。
值得每个Agent开发者提前思考
这位工程师的提问方式本身就很有价值——他在动手构建之前先调研真实痛点,而不是先建后补。他甚至坦言"'从来没遇到过'这个回答也很有用",因为这能帮助判断这个问题在当前生产实践中的普遍程度。
对正在或计划构建AI Agent的团队来说,这个帖子提出了几个应当在架构设计早期就纳入考虑的问题:
- 是否为每一次有后果的操作建立了贯穿授权、决策、执行的统一关联ID?
- 是否记录了操作发生时的完整运行时快照(prompt、模型、配置版本)?
- 是否有机制去核对Agent的意图与外部系统的实际结果是否一致?
- 当出现争议时,你的团队定位一个问题需要翻查几个系统、花费多长时间?
可审计性往往是事后才被想起的能力,而那时补救的成本已经高得多。在Agent真正承担起发退款、改记录这类有实际业务后果的职责之前,把追溯链条设计进系统,可能是决定它能否走进企业生产环境的关键一步。
相关推荐
AI没有意图也没有动机:重新理解智能与自主性的边界
Hacker News热议"AI没有意图也没有动机"这一论断。本文剖析大语言模型作为概率预测系统的技术真相,探讨拟人化陷阱、AI安全的正确框架,以及为何清醒认知AI本质对产品设计与公共叙事至关重要。
arXiv获1720万美元资助 独立运营为科研开放铺路
全球预印本平台arXiv获得Simons Foundation、XTX Markets和Siegel Family Endowment共计1720万美元的多年期慈善资助,支持其转型为独立非营利组织。本文解析这笔资金对开放科学与AI研究生态的深远意义。
AI成气候周焦点:能源需求与减碳潜力的双重博弈
在纽约气候周上,人工智能成为无法回避的核心议题。本文分析AI数据中心的能源消耗如何挑战企业气候承诺,以及AI作为减碳工具的双重角色与政策投资影响。