AI Toolbox 3.0:跨平台管理ChatGPT、Claude等四大AI对话的效率工具

AI对话散落多平台,检索管理成隐性痛点
当你每天在ChatGPT、Claude、Gemini和Grok之间来回切换时,一个隐性问题正在悄然累积:对话记录散落在四个孤立的平台里,无法统一检索,难以归档,更谈不上组织管理。想找回上周那段关键的提示词,往往只能靠记忆和无尽的滚动翻找。
ChatGPT、Claude、Gemini、Grok技术背景: ChatGPT由OpenAI开发,基于GPT系列大语言模型,是最早面向公众的对话式AI产品。Claude由Anthropic公司推出,强调安全性和可解释性,采用Constitutional AI技术框架。Gemini是Google的多模态大模型,2025年3月发布Gemini 2.5 Pro版本,整合了搜索引擎的海量数据优势。Grok则是Elon Musk旗下xAI公司的产品,2025年2月发布Grok 3版本,定位更加开放和实时。这四家产品代表了当前AI大模型的主流阵营,各自拥有独立的用户界面、数据存储和API体系,彼此之间不互通数据。
这种数据孤岛问题,实际上是信息技术领域反复出现的经典困境。从早期的即时通讯工具(MSN、QQ、Yahoo Messenger互不兼容),到后来的云存储服务(Dropbox、Google Drive、iCloud各自封闭),再到如今的AI对话平台,数据互不互通始终是用户的核心痛点。欧盟《数字市场法案》(DMA)正在推动平台互操作性,但AI对话数据的标准化尚未进入监管视野。目前,各AI平台的对话导出功能参差不齐——ChatGPT支持一次性全量导出,Claude和Gemini的导出功能相对有限,这进一步加剧了跨平台管理的困难。
AI Toolbox 3.0正是瞄准了这一痛点。作为一款Chrome浏览器扩展,它在Product Hunt上夺得当日榜单第一名,收获412个投票和62条评论,同时在Chrome Web Store拥有40,000+用户、4.5星评分,覆盖150多个国家。这些数据说明:管理AI对话,正在成为一个真实且高频的需求。
Chrome浏览器扩展开发生态: Chrome浏览器扩展(Chrome Extension)是基于Web技术(HTML、CSS、JavaScript)开发的浏览器插件,可以修改或增强浏览器功能。Chrome Web Store是Google官方的扩展分发平台,拥有严格的审核机制和隐私政策要求。扩展可以访问用户浏览的网页内容、修改DOM结构、拦截网络请求,这使得第三方工具能够在不依赖官方API的情况下,直接从网页界面抓取和管理AI对话数据。截至2025年,Chrome浏览器市场占有率超过60%,使得Chrome扩展成为最具影响力的浏览器插件生态。
AI Toolbox核心功能:在四大AI之上构建统一管理层
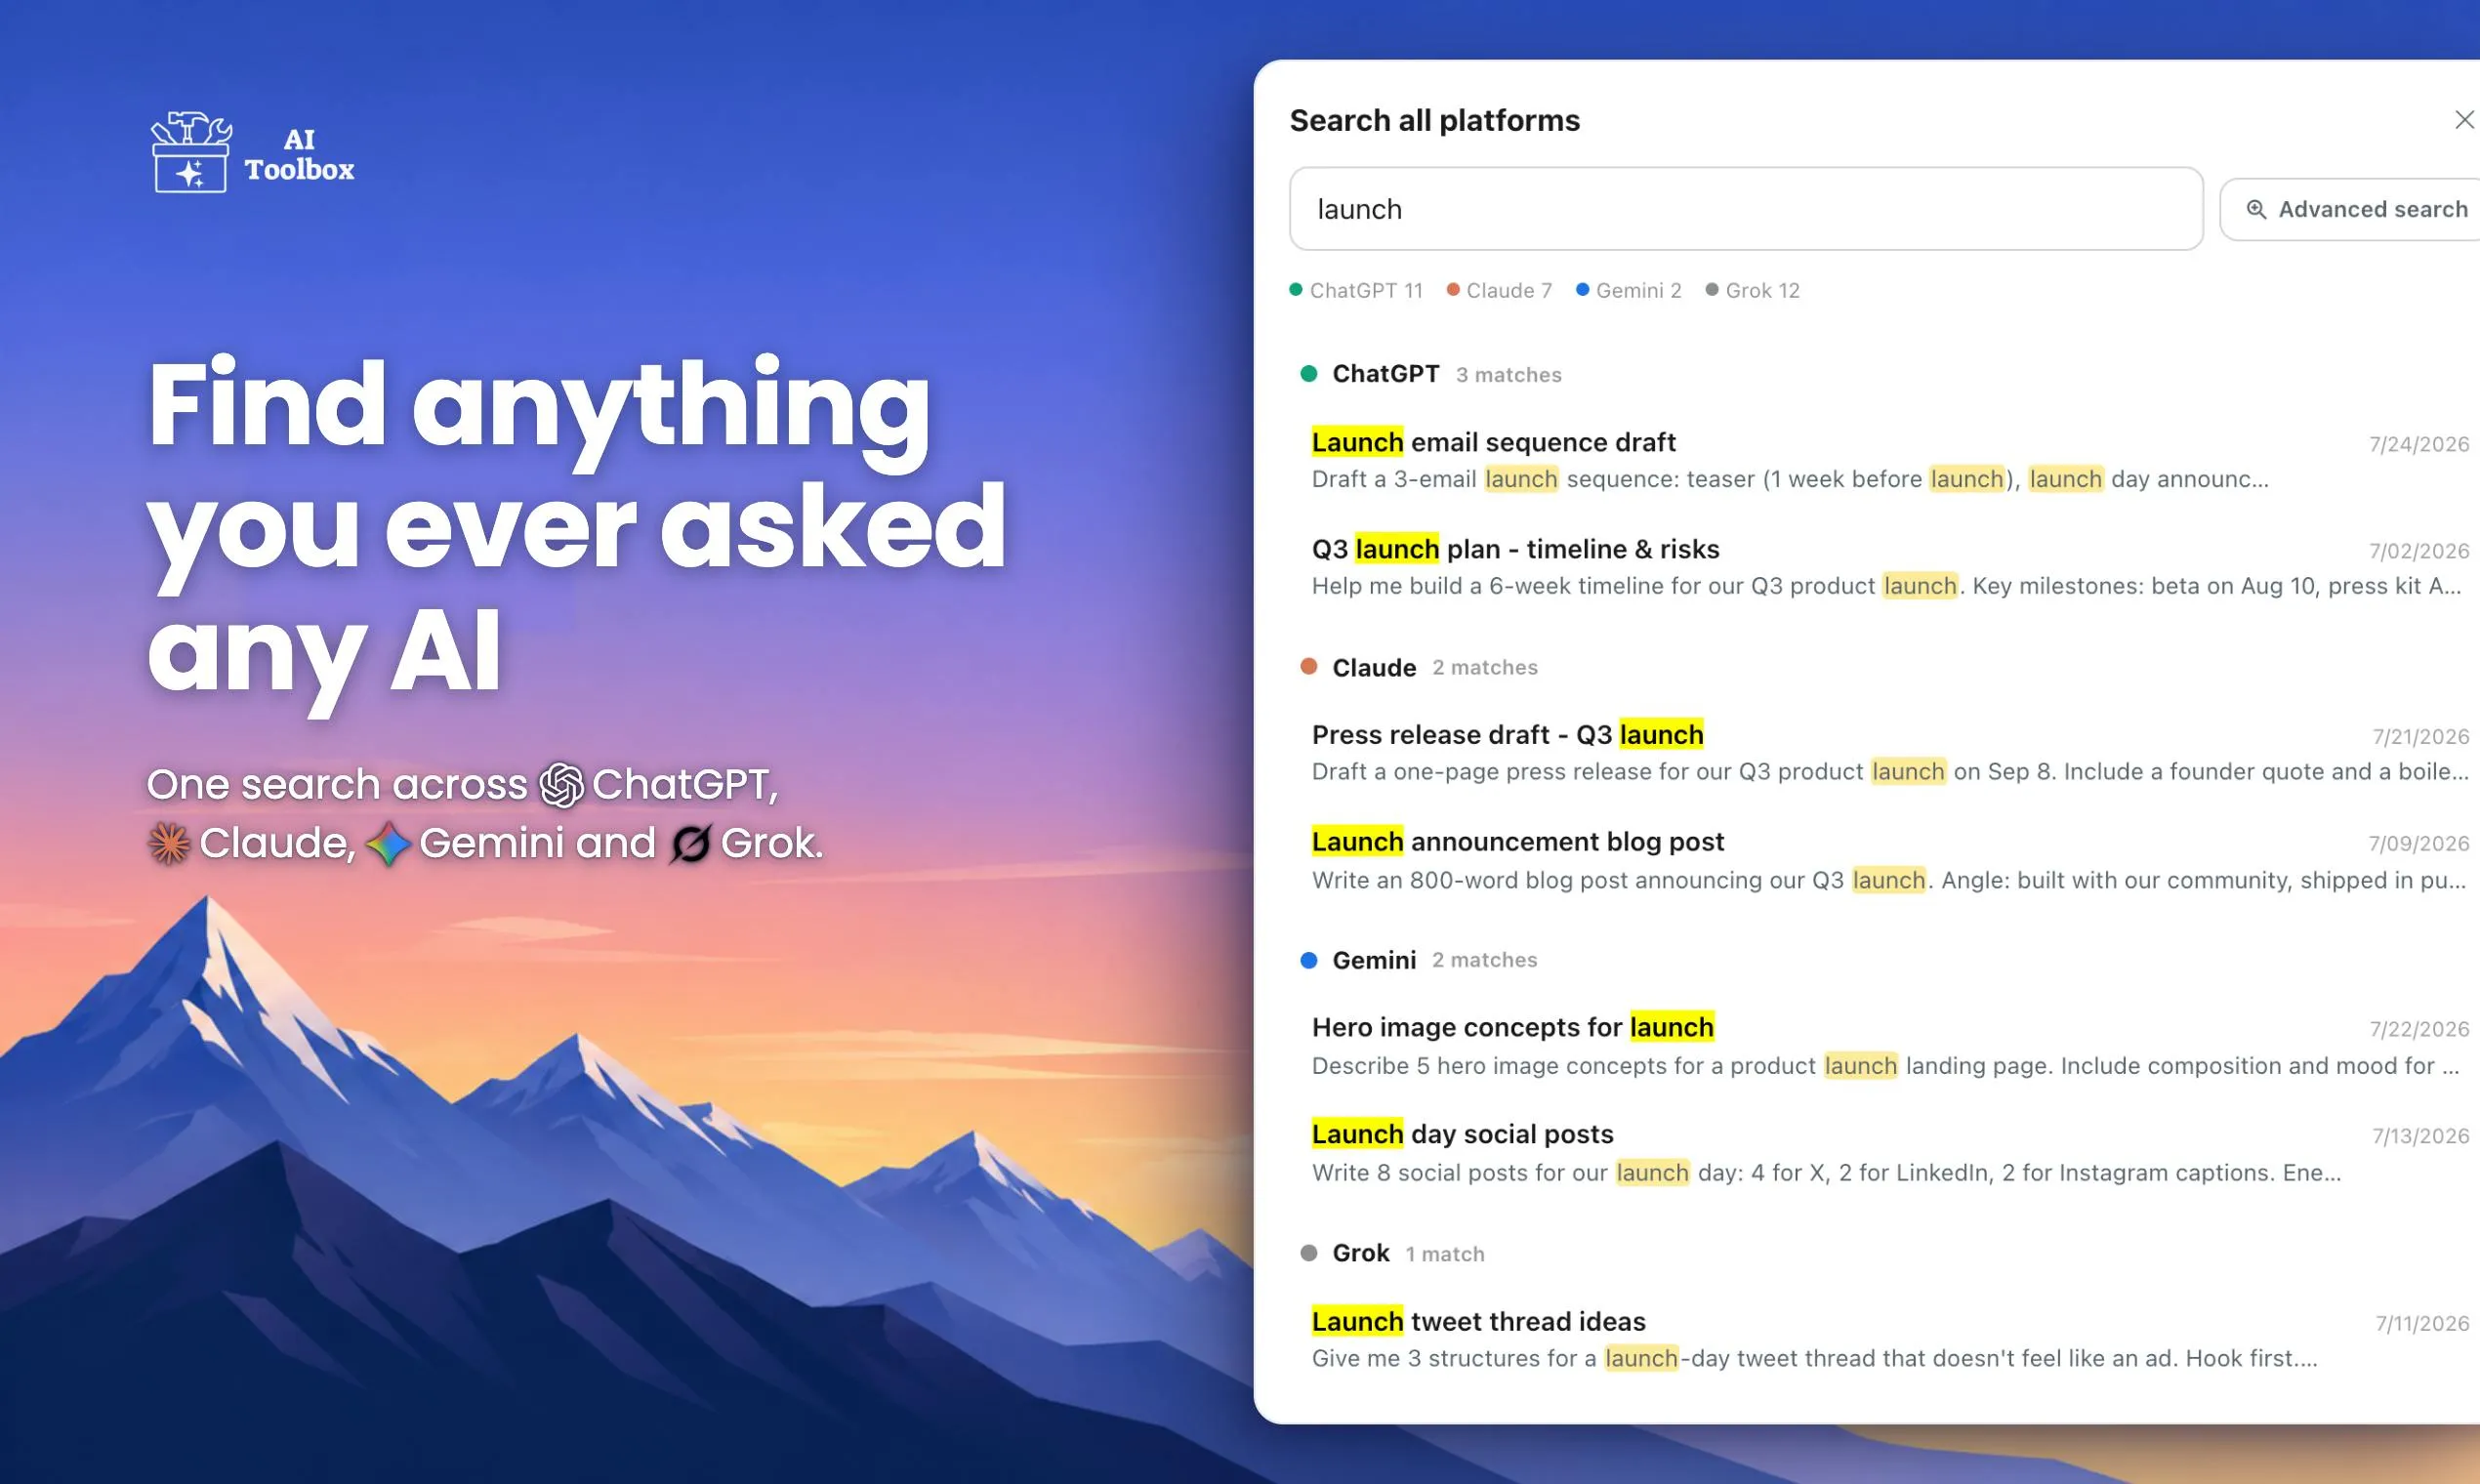
开发者Adi Leviim将AI Toolbox定位为「ChatGPT、Claude、Gemini和Grok之上缺失的一层(the missing layer)」。这个定位相当精准——它并不试图取代任何一个大模型,而是充当一个横跨多平台的组织与检索层。
Product Hunt平台与产品验证: Product Hunt是全球最具影响力的新产品发现社区,每天展示数十款新产品,由用户投票决定排名。登上日榜第一意味着在24小时内获得最多社区认可,通常需要数百票支持和活跃的讨论。对于早期产品而言,Product Hunt既是验证市场需求的试金石,也是获取种子用户的重要渠道。AI工具类产品在该平台尤其活跃,2024-2025年间AI相关产品占据了榜单的显著比例,反映出开发者社区对AI工具层的持续探索热情。
全文搜索与跨平台对话检索
最实用的功能莫过于全文搜索。你可以在所有历史对话中进行关键词检索,甚至能够同时跨四个平台搜索。无论你当初是在Claude还是Gemini里讨论过某个问题,一次搜索就能精准定位。对于重度使用者而言,这几乎是从「大海捞针」到「一键直达」的体验跃迁。
这种跨平台搜索的技术实现并非易事。由于各平台的网页结构、对话存储方式和渲染逻辑各不相同,扩展需要为每个平台编写独立的内容解析器(parser),从DOM中提取对话文本并建立本地索引。全文搜索通常依赖倒排索引(Inverted Index)技术——与搜索引擎的核心原理相同——将每个词汇映射到包含该词汇的对话记录,从而实现毫秒级检索响应。
文件夹与子文件夹归档管理
AI Toolbox提供了文件夹与子文件夹的层级结构,让用户能像整理文档一样组织对话。配合书签功能,可以标记重要的对话节点,随时回溯。这种把AI对话「文档化」的思路,实际上是把非结构化的聊天记录重新纳入了可管理的知识体系。
这一设计与个人知识管理(PKM)领域正在发生的范式转变密切相关。传统PKM强调的是对既有信息的收集和整理(如Evernote的剪藏功能),而AI时代的PKM正在演变为对生成过程的管理——不仅要保存结果,还要记录产生结果的上下文、提示词和推理路径。Tiago Forte提出的PARA方法论(Projects、Areas、Resources、Archives)和Nick Milo的ACCESS框架,为组织数字信息提供了系统化方法,但这些框架尚未充分考虑AI对话这种新型知识载体。AI Toolbox的文件夹分类和书签功能,实际上是在填补这一方法论空白,让用户能够用熟悉的文件管理范式驾驭全新的知识形态。
提示词库与多步骤工作流链条
对于经常复用提示词的用户,AI Toolbox内置了提示词库(Prompt Library),支持通过//快捷指令直接插入提示词,还能构建多步骤链条(multi-step chains)。这一功能将常用工作流固化下来,减少重复输入,是提升AI使用效率的关键设计。
提示词库和多步骤链条功能的背后,是**提示词工程(Prompt Engineering)**这一新兴学科的实践落地。提示词工程研究如何通过精心设计的输入文本,引导大语言模型产出更准确、更有用的回答。常见技术包括Few-shot prompting(提供少量示例引导模型理解任务)、Chain-of-Thought(要求模型展示逐步推理过程)、Role prompting(为模型设定特定角色和身份)等。一个经过反复迭代和验证的提示词模板,其价值远超单次使用——它本质上是一种可复用的认知工具。多步骤链条则对应了AI工作流编排的概念,类似于LangChain等开发框架实现的Prompt Chaining(提示词链式调用),但AI Toolbox将其降低到了普通用户无需编程即可操作的层面,大幅降低了使用门槛。
数据导出与隐私保护:Local-first架构详解
批量导出为Markdown、PDF、JSON
AI Toolbox支持将对话批量导出为Markdown、PDF、JSON三种格式。这对需要归档、二次编辑或将AI产出接入其他工作流的用户极为友好。Markdown适合写作与知识库搭建,PDF适合分享存档,JSON则为开发者的数据处理留出了接口。
Markdown与知识管理生态: Markdown是一种轻量级标记语言,使用纯文本格式编写,可轻松转换为HTML、PDF等格式。由于其简洁性和可读性,Markdown已成为技术文档、笔记工具和知识管理系统的事实标准。Notion、Obsidian、Logseq等主流知识管理工具均原生支持Markdown。将AI对话导出为Markdown格式,意味着用户可以将这些内容无缝接入现有的个人知识库(PKM,Personal Knowledge Management),进行进一步的标注、链接和检索。这种互操作性是知识工作者高效管理碎片化信息的关键。
JSON格式与开发者生态: JSON(JavaScript Object Notation)是一种轻量级数据交换格式,因其结构清晰、易于机器解析和人类阅读而成为Web开发和API通信的主流标准。AI Toolbox支持JSON导出,意味着开发者可以将对话数据导入数据库、用Python等语言进行批量分析,或接入自动化工具链(如Zapier、Make、n8n)实现更复杂的工作流。例如,开发者可以编写脚本自动分析历史对话中的高频问题模式,或将有价值的AI回答自动归类到特定知识库中,实现从手动管理到自动化管理的跃迁。
实时上下文计量器
一个容易被忽略但颇具巧思的功能是实时上下文计量器(live context meter)。它能帮助用户直观感知当前对话已占用多少上下文窗口,从而避免因超出模型上下文限制而导致的信息丢失或回答质量下降。这体现了开发者对大模型使用细节的深入理解。
上下文窗口(Context Window)机制: 上下文窗口是大语言模型一次能够处理的最大文本长度,通常以token(词元)为单位计量。一个token大约对应0.75个英文单词或0.5个中文字符。早期GPT-3的上下文窗口仅4K tokens,而2025年主流模型已普遍达到128K甚至200K tokens——例如Claude 3.5支持200K tokens,GPT-4 Turbo支持128K tokens。超出上下文窗口后,模型会「遗忘」最早的输入内容,导致对话连贯性下降。但即使在窗口范围内,研究也表明模型对位于中间位置的信息关注度较低(即「Lost in the Middle」现象)。实时上下文计量器通过解析对话内容估算已用token数,帮助用户在接近上限前及时总结或开启新对话,这对长文本创作和复杂推理任务尤为重要。
本地优先的隐私保护策略
值得强调的是,AI Toolbox采用**Local-first(本地优先)**架构——所有对话数据都保留在浏览器本地,而非上传至第三方服务器。在AI隐私日益受到关注的当下,这一设计既降低了数据泄露风险,也减轻了用户对敏感对话被收集的顾虑。对于企业用户和处理机密信息的专业人士而言,这可能是决定是否采用的关键因素。
Local-first架构与数据隐私: Local-first是一种软件架构理念,强调数据优先存储在用户本地设备,而非远程服务器。这种设计赋予用户完全的数据所有权,即使断网或服务商停止运营,数据依然可用。在AI领域,用户与大模型的对话可能包含商业机密、个人隐私或创意雏形,上传至第三方服务器存在泄露风险。Local-first通过将数据存储在浏览器的IndexedDB或LocalStorage中,避免了数据经过开发者服务器的环节。但这也带来局限:数据无法跨设备自动同步,需要手动导出导入,或依赖端到端加密的同步方案(如Syncthing、端到端加密的云存储)。值得注意的是,浏览器本地存储并非绝对安全——恶意扩展、浏览器漏洞或本地设备被入侵都可能导致数据泄露,但相比将数据集中存储在开发者服务器上,攻击面已大幅缩小。
产品定位分析:跨平台AI工具层的机会窗口
AI Toolbox的成功折射出一个更大的趋势:围绕主流大模型的「效率工具层」正在成为一个独立的产品赛道。
随着ChatGPT、Claude、Gemini、Grok各自筑起数据孤岛,用户被迫在多平台间切换的痛点越来越明显。而这些大模型厂商出于竞争考量,短期内几乎不可能主动打通彼此的数据。这就为第三方工具留出了清晰的机会窗口——做官方不会做、也不愿做的跨平台整合。
从商业角度看,「一次安装覆盖四大AI」的策略极具吸引力。用户无需为每个平台单独寻找工具,一个扩展解决所有问题,这种「聚合价值」正是其能快速积累4万用户的核心原因。
当然也需理性看待其局限:作为浏览器扩展,它高度依赖各大模型平台的网页界面结构,一旦平台改版,兼容性就需要及时跟进维护。这涉及到Web Scraping(网页抓取)技术的根本挑战——Chrome扩展通过Content Script注入目标网页,读取和操作DOM(文档对象模型)来获取对话数据。一旦平台修改了HTML结构、CSS类名或采用动态渲染策略,扩展可能立即失效。更深层的风险在于平台方的主动对抗——如果AI平台认为第三方工具损害了其数据生态或商业利益,完全可以通过技术手段(如混淆DOM、检测扩展注入)或服务条款约束来限制此类工具。这种平台与第三方工具之间的博弈关系,是所有依附型产品面临的结构性风险,类似于早期Twitter第三方客户端最终被官方API政策扼杀的历史。
此外,Local-first虽然保障隐私,但也意味着数据无法跨设备同步(除非另有机制),这在多设备工作场景下可能带来不便。
AI对话作为知识资产:个人知识管理的新形态
AI Toolbox 3.0的价值,本质上是把「AI对话」重新定义为一种值得管理的知识资产。当我们与AI的交互越来越频繁、越来越深入,那些包含着思考过程、解决方案和创意火花的对话,理应像文档、邮件一样被组织、检索和复用。
这一趋势背后有着更深远的认知科学基础。认知科学家Andy Clark提出的「延展认知」(Extended Cognition)理论认为,人类的认知过程并不局限于大脑内部,而是延伸到所使用的工具和环境中——笔记本、计算器、搜索引擎都是认知的一部分。在这一框架下,AI对话工具实质上已经成为人类思维的外部延伸,而对这些对话的有效管理,就是对自身认知能力的维护和增强。当一个知识工作者积累了数千条AI对话后,这些对话构成的并不仅仅是历史记录,而是一个随时可以检索、复用和演化的外部思维库。
对于每天与多个大模型打交道的专业用户、内容创作者和开发者来说,这类工具正从「锦上添花」逐渐变为「刚需基础设施」。AI Toolbox登顶Product Hunt,或许正是这一趋势的一个明确信号。
核心要点
核心要点
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。