AI编程工具20强榜单:从夯到拉的评分矩阵

B站UP主用六维加权评分体系将20款AI编程工具分为T0至T4五档,Claude Code与Codex并列榜首。
文章拆解了B站UP主对20款AI编程工具的评分榜单。评分体系由编码能力(30%)、常任务可靠性(20%)、耐操性(15%)、耐久性(10%)、成本可控(10%)、国内可用性(10%)和5%的模型体验主观分加权构成,试图量化工具的综合实力而非单一编码能力。榜单分为五档:Claude Code与Codex以8.4分并列T0;Cursor与Gemini位列T1;Kimi、Copilot等构成T2主力;Continue、百度Comet等属T3;T4为不推荐。文章还分析了各工具亮点与短板,并针对国内开发者强调可用性与成本两大现实门槛,指出榜单仅供参考,选择需结合网络、预算与合规场景。
AI编程工具层出不穷,但到底哪些真正好用?B站UP主在最新教程中,用一张表格对20款工具进行了从“夯”到“拉”的评分,并给出了详细的评分维度与权重。本文将结合该视频内容,拆解这份榜单背后的逻辑,并分享其中值得关注的工具表现。
评分维度:六个维度的加权游戏
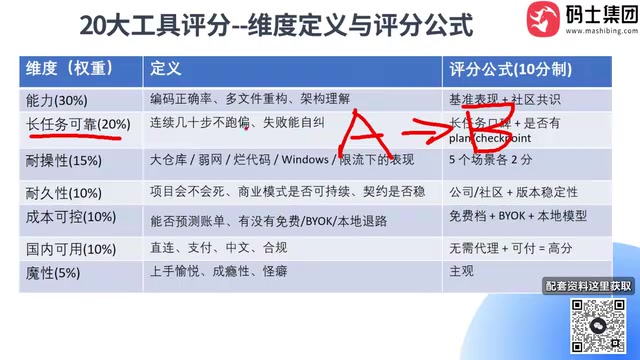
UP主将评分拆解为六个维度,每个维度赋予不同权重:编码能力(30%)、常任务可靠性(20%)、耐操性(15%)、耐久性(10%)、成本可控(10%)、国内可用性(10%),另外还有5%的模型体验分(主观感受)。综合评分即各维度加权求和。
- 能力:考察代码正确率、多文件重构和架构理解,依据公开基准测试和社区共识评分。
- 常任务可靠性:关注连续几十步任务中是否会“跑偏”,以及出错后能否自我纠正。评分主要看社区口碑和工具源码中是否有plan/checkpoint等机制。
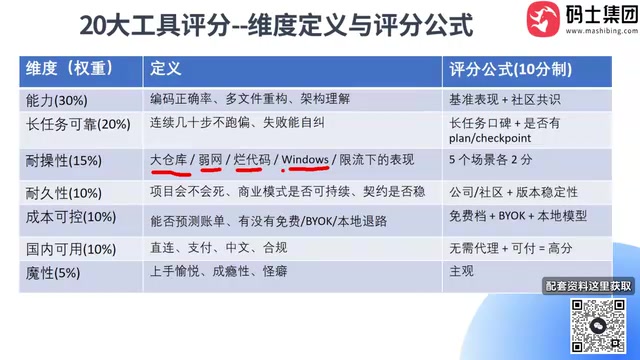
- 耐操性:在五个场景(大仓库、弱网、烂代码、Windows兼容、限流)中取两个最高分,反映工程鲁棒性。
- 耐久性:评估工具背后的公司或社区能否持续维护,包括商业模式、版本稳定性等。
- 成本可控:是否免费、是否支持BYOK(自带模型Key)、能否本地部署。
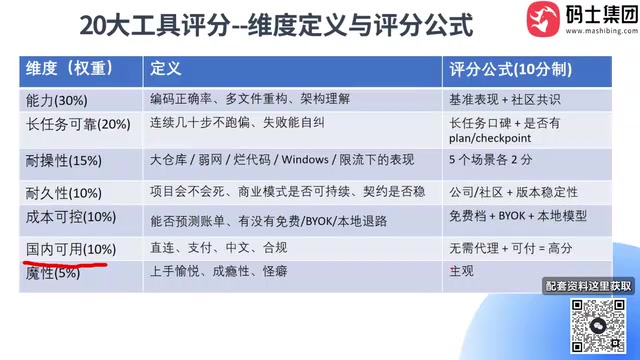
- 国内可用性:是否需要代理、支付是否方便、中文场景支持、企业合规性。
这个体系试图量化工具的综合实力,而非单一编码能力。
BYOK(Bring Your Own Key) 指用户自带模型 API Key 接入工具,而非强制购买工具官方提供的订阅或额度。对开发者而言,BYOK 意味着可以自由选择底层模型(如用国产模型 Key 替代海外模型),按实际 token 用量付费,成本更透明、更可控;同时也避免了工具绑定单一模型厂商带来的涨价或停服风险。榜单中“成本可控”维度把 BYOK 作为重要加分项,正是因为它在费用灵活性和模型可替换性上给了用户主动权。
本地部署 指将模型或工具运行在自有服务器、私有云甚至个人电脑上,数据不出内网。它既是成本手段(开源模型边际成本趋近于零),也是合规手段——代码不经过第三方服务器,可规避数据出境与保密风险。代价是需要自备算力,且模型能力通常弱于云端旗舰模型,维护成本也需自行承担。
榜单分层:T0夯、T1准顶、T2主力、T3一般、T4拉
根据综合评分,20款工具被分为五个层级:
T0 夯(8.4分)
仅有Claude Code和Codex两款,综合评分均为8.4。它们在编码能力和常任务可靠性上接近满分(9分以上),代表当前AI编程工具的最高水平,可直接用于生产环境。
T1 准顶(7.5-7.8分)
Cursor(7.8)和Gemini(7.5)。它们具备生产可用性,但与T0仍有差距。Cursor在模型体验上得分最高,用户粘性强;Gemini则依托Google的生态。
T2 主力(约7分)
包括Kimi、Kilo、Codeium、OpenCloudTrain、Copilot、Adder、DeepSeek广告 Harness等。这些工具日常使用基本足够,但缺少核心竞争力,适合作为辅助。
T3 一般(6分左右)
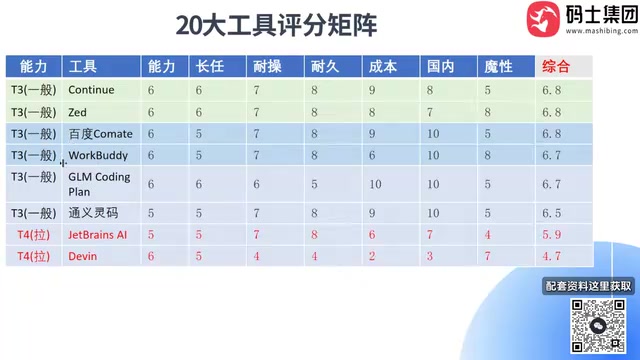
Continue、Zed、百度Comet、WorkBody、GLM同义零码等。它们往往只适用于特定场景,综合能力差一档。视频提到WorkBody近期较火,但因其偏向AI办公而非纯编程,在编程榜单中得分不高。
T4 拉(不推荐)
仅列入两款,UP主表示若扩展到30或40款,不推荐名单会更长。
榜单中“夯”与“拉”是网络流行语:“夯”原指砸实地基,引申为扎实、靠谱、实力过硬;“拉”即“拉胯”,指表现糟糕、掉链子。UP 主用 T0 到 T4 的分层借用了游戏或硬件圈常见的梯队(Tier)排序法,T0 为最高档,数字越大档位越低。这种分层方式的好处是比单一分数更直观——同一梯队内的工具差距不大,跨梯队则意味着能力有档差,便于读者按需对号入座。
工具亮点与短板:数据背后的故事
Claude Code和Codex在编码能力、常任务可靠性上得分极高,且耐久性(背靠大公司)有保障,但国内可用性受限于代理和支付。
Cursor模型体验分最高,用户黏性强,成本可控性较好(支持BYOK),但耐操性并非顶尖。
DeepSeek Harness作为国内开源模型工具,国内可用性得分很高,但耐久性因版本尚不稳定(预览版)而偏低。
Copilot耐久性得分较高(微软背书),但编码能力与T0有差距。
WorkBody因定位办公协同,在编程维度得分普通,但若用于文档处理可能更合适。
国内工具如通义零码、百度Comet在中文场景和支付便利性上有优势,但综合能力仍待提升。
Harness 在 AI 编程语境中通常指包裹在模型外层的“脚手架”或运行框架,负责把用户指令拆解为多步操作、调用工具、读写文件、执行命令并在出错时重试。同一底层模型搭配不同的 harness,实际编程表现可能差别很大,因此榜单把这类工具单列评估,而不是只比较模型本身。
预览版(Preview) 指功能尚未完全稳定、API 和行为可能随版本迭代变动的发布阶段。它通常免费或低价开放,适合尝鲜和评估,但不建议在关键生产流程中长期依赖,这也是 DeepSeek Harness 在“耐久性”维度得分偏低的原因之一。
国内开发者特别关注:可用性与成本
对于国内开发者,国内可用性和成本可控是两大现实门槛。UP主指出,许多海外工具需要代理,不仅增加费用,还存在封号风险;企业合规性也是考量点——代码上传至境外服务器可能违反规定。
成本方面,支持BYOK和本地部署的工具更灵活。例如,Claude Code和Codex可配置DeepSeek等国产模型的Key,按用量付费;而一些开源工具允许本地部署,边际成本趋近于零。
结语:榜单是参考,选择需结合场景
这份评分矩阵的价值在于提供了一套可量化的评估框架。T0工具虽强,但未必适合所有团队——网络环境、预算、合规要求都会影响选择。对于初学者,从T2工具入手练习,再逐步过渡到T0,或许是更务实的路径。UP主后续还将逐一详解每款工具,值得持续关注。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。