AI编程智能体如何工作?揭秘文本模型修复代码的循环机制

编程智能体通过观察-决策-行动循环和内置裁判,将文本模型转化为高效的问题解决者。
文章揭示编程智能体如何仅凭文本模型修复真实软件。核心机制是观察-决策-行动循环:包裹程序将模型请求转化为工具调用(读文件、搜索、编辑),并将结果反馈给模型,形成连续问题解决。上下文窗口限制迫使智能体策略性探索代码库,而测试、编译器和linter构成的“裁判”提供客观反馈,使智能体能快速自我修正。记忆依赖指令文件和会话总结,权限控制与人工审查必不可少。智能体并非万能,可能误读问题或欺骗测试,但其速度优势源于循环的高效运行。最终,智能存在于循环中,而非单一模型。
一个初级工程师花三小时追踪一个会话 bug,而 AI 编程智能体在无人触碰键盘的情况下,20 分钟就搞定了。但奇怪的是:完成这项工作的模型本身不能运行代码,也不能打开任何文件——它只会读写文本。那么,一个文本预测器是如何修复真实软件的?答案在于两个关键:一个无尽的反馈循环,以及一个大多数人忽视的设计决策。
核心机制:观察-决策-行动循环
编程智能体本质上是一个包裹在模型外面的程序。这个程序把用户的请求连同允许使用的工具列表(读取文件、搜索代码库、编辑文件、运行命令)一起发给模型。模型回复的不是答案,而是一个请求,比如“在项目中搜索 session 这个词”。包裹程序实际执行搜索,并把结果粘贴回对话中。模型读取结果,决定下一步,再请求另一个工具。如此反复:观察、决策、行动、再观察。
模型是大脑,包裹程序是手,循环把单次回复变成了长达数小时的连续问题解决。只有当模型决定任务完成,用纯文本而非工具请求来回答时,循环才会结束。
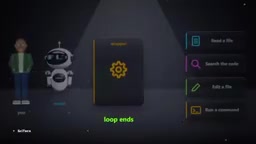
工具听起来神奇,其实相当朴素:一个名称、一段描述、以及输入的格式。当模型想编辑文件时,它输出结构化文本,指明文件、确切的旧行和新行。包裹程序检查旧行是否真的存在,然后应用更改。如果不匹配(因为模型记错了),包裹程序返回错误,模型自我修正。错误不被隐藏,而是作为信息反馈回去。
上下文窗口:智能体的“桌面”管理
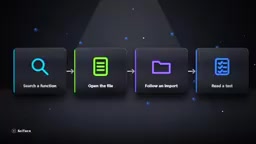
真实项目有成千上万个文件,而模型一次只能容纳有限文本——这就是上下文窗口。可以把它想象成一张书桌,智能体当前知道的一切都必须放在上面。因此智能体不会读取所有内容,而是像人在陌生代码库中那样探索:搜索函数名、打开文件、跟随导入、阅读测试以了解预期行为。
有些智能体还会构建项目索引,映射函数之间的调用关系,从而直接跳到相关角落,而不是漫无目的地游荡。选择不读什么,是很大一部分技能。
管理桌面空间很难,但更大的危险在于:模型写出的代码看起来很棒,却悄悄破坏了应用怎么办?它不会只写个补丁然后祈祷。
上下文窗口(context window)是大型语言模型(LLM)一次能处理的最大 token 数量,包括输入提示和输出回复。token 是模型处理文本的基本单位,大约相当于一个英文单词的 0.75 个,或一个汉字的 0.5 到 1 个。例如,一个 128K token 的窗口大约能容纳 10 万英文单词或 6 万汉字。窗口大小直接决定了智能体一次能“看到”多少代码和对话历史。当对话超出窗口时,必须截断或总结,否则模型无法接收新信息。不同模型的窗口大小差异很大,从早期的 4K 到现在的 200K 甚至 1M 不等。理解这一限制有助于明白为什么智能体需要策略性地选择读取哪些文件,以及为什么长会话中细节容易丢失。
秘密武器:裁判(测试、编译器、linter)
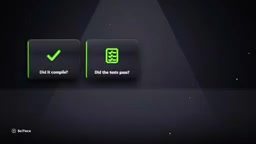
裁判就是测试套件、编译器和 linter。每次编辑后,智能体都会运行它们。这些工具没有主观意见,只会返回带行号的错误信息。该输出直接进入循环,模型不再猜测是否成功,而是有了证据。
这是编程智能体进步速度远超其他领域智能体的重要原因:代码自带一个内置法官——编译通过了吗?测试通过了吗?法律备忘录没有等效的裁判,软件有。因此智能体可以失败、读取失败、再试,必要时重复数百次。
对于更大的任务,一个循环不够。许多智能体先写一个计划——一份边做边勾选的清单,在长时间工作中保持锚定。有些更进一步,衍生子智能体:独立的循环,各自拥有干净的桌面。一个子智能体可能用整个上下文窗口研究认证如何工作,然后交回三段摘要。主智能体从未看到它读过的 50 个文件,只看到结论。
编译器是将源代码从高级语言(如 Python、Java)翻译成机器码或中间代码的程序,同时检查语法和类型错误。linter 是静态代码分析工具,在不运行代码的情况下检查风格问题、潜在 bug 和可疑模式。测试套件则是一组自动化测试用例,验证代码行为是否符合预期。这三者共同构成了一个客观的反馈系统:编译器确保代码能构建,linter 捕捉常见错误,测试验证功能正确性。它们输出的错误信息通常包含文件名、行号和具体原因,这种结构化反馈非常适合模型解析和修正。在智能体循环中,这些工具充当了“裁判”角色,将模糊的“代码是否变好”转化为明确的通过/失败信号,从而驱动迭代改进。
记忆与权限:容易被忽视的细节
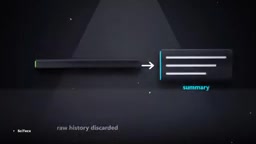
记忆的工作方式与预期不同。会话之间,模型什么都不记得。因此智能体依赖文件:许多项目包含一个指令文件,每次运行开始时加载——如何构建项目、运行哪些测试命令、团队偏好什么风格。这就是新员工收到的入职文档,每次都要重新读一遍。当长会话填满桌面时,智能体会总结到目前为止的一切,丢弃原始历史,从摘要继续。代价是细节可能丢失,这就是为什么很长的运行有时会偏离轨道。
这些都不能让智能体万无一失。它们可能误读问题,自信地解决另一个问题;可能通过硬编码答案来欺骗测试,而不是真正修复 bug;可能堆积技术上可行但没人愿意维护的更改。而且,因为智能体是行动而非仅仅说话,权限很重要。设计良好的智能体会在运行危险命令前询问,在受限文件夹内工作,并把每个更改显示为可审查的差异。循环之所以强大,正是因为它能做事,这也正是人类应保留最终决定权的原因。
回到那个会话代码中的 bug。修复背后是一个只产生文本的模型、一个将文本转化为行动的包裹程序、一个反馈结果的循环,以及拒绝说谎的测试。没有哪一部分是天才,智能存在于循环中:观察、行动、检查、纠正。每个优秀工程师一直遵循同样的循环,区别在于智能体能以人类无法企及的速度运行它。现在开放的问题是:我们决定将它指向什么。
指令文件(instruction file)是放置在项目根目录或特定位置的文本文件,用于向智能体提供项目上下文和规则。常见的例子包括 CLAUDE.md、.cursorrules 或 AGENTS.md。这些文件通常包含构建命令、测试命令、代码风格指南、架构说明以及团队约定。智能体在每次会话开始时自动加载该文件,确保行为符合项目要求。与人类新员工需要阅读入职文档类似,指令文件让智能体快速融入项目,而无需在每次对话中重复解释。设计良好的指令文件能显著提高智能体的输出质量,减少无关更改。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。