AI大模型本地部署42环路线图:5段拆解与通关指南

42环路线图助你定位本地大模型部署卡点,避开静默失败陷阱。
本文介绍了B站UP主提出的本地大模型部署42环路线图,将全流程分为决策、环境、接入、应用、长期化五段(98898),帮助用户定位自己卡在哪一环。文章指出B段(环境与跑通)公开资料最少但成本最高,新手常因报错信息不明确而损失判断力。作者按需求将使用者分为三类,给出不同路径和出口标准,并用八个问题自测卡点。特别强调第12、15、24、35环是静默失败高危环,跳过不报错但一周后暴露问题。时间预期上,第一次完整跑通需两三周,出字只是第17环,真正“能用”需关注解码速度、预填充速度和显存余量。最后给出三个不建议做的事和今晚就能做的三件事。
很多人在本地部署AI大模型时,都经历过类似的循环:显卡买了,引擎装了,模型也拉下来了,第一句话也成功输出了——然后屏幕前的人就不知道下一步该干嘛了。B站UP主把从「该不该买卡」到「三年后怎么卖」的整条路径拆成了42个环节,不教具体某一环的操作,只帮你定位:你现在在第几环、为什么总卡在同一个地方、今晚该动哪一环。
42环的全貌:5段结构速记
整条路线被划成五段,段位数字连起来是「98898」:
- A段·决策(9环):从「你要它干什么」一直到「劝你别买」,这一段花的是钱。
- B段·环境与跑通(8环):从装系统到第一次显存爆掉怎么自救,这一段花的是时间。
- C段·接入(8环):让模型真正被人用上。
- D段·应用(9环):知识库、Agent、微调。
- E段·长期化(8环):从开机自启一直到三年后卖掉。
记住这个分段结构,之后听到任何一环,都能直接对上它落在哪一段。
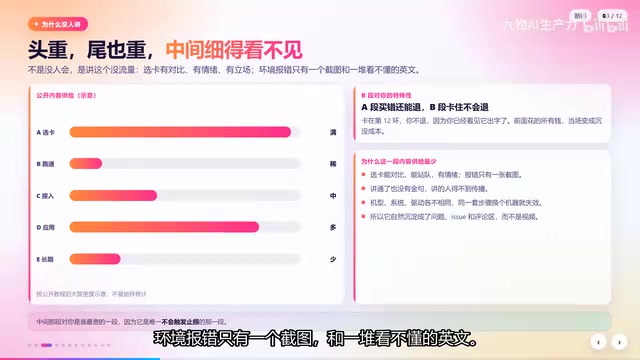
为什么你总卡在B段:供给偏了,中间最贵
五段内容里,B段的公开资料特别少。搜选卡评测能刷一整天,讲知识库的也一堆,但讲「装完跑不起来怎么办」的很少。UP主的判断很直接:不是没人会,是讲这个没流量——选卡有对比、有情绪、有立场,环境报错只有一个截图和一堆看不懂的英文。于是内容供给头重尾也重,中间细得几乎看不见。
但对新手来说,中间那段恰恰最贵。A段买错了还能退;B段卡住,前面花的所有钱都成了沉没成本,而且你不会退,因为你已经看到它出字了。
B段这八环值得单独摊开:第4环装什么系统、第11环驱动和CUDA对不对得上、第12环Python环境干不干净、第13环用哪种装法、第14环第一次跑通、第15环模型权重放哪、第16环格式别下错、第17环第一次显存爆掉。它们的共同点是:报错信息都不告诉你该干嘛。显卡不认你,只说找不到设备,不说你驱动版本差了两年;环境冲突只说缺一个包,不说你装了三份;显存爆掉只说内存不足,不说你其实是被上下文吃掉的。新人在这里损失的不是技术,是判断力——你不知道这个错是正常的还是致命的。
CUDA(Compute Unified Device Architecture)是NVIDIA推出的并行计算平台和编程接口,绝大多数本地大模型推理引擎(如llama.cpp、vLLM、TensorRT-LLM)都依赖它调用GPU算力。驱动是操作系统与显卡通信的底层软件,而CUDA运行时是建立在驱动之上的计算库。两者版本必须兼容:驱动版本过低会导致CUDA初始化失败,报错常为“CUDA driver version is insufficient”。此外,PyTorch等框架会捆绑特定CUDA版本,若与系统驱动不匹配,同样无法启用GPU。因此第11环“驱动和CUDA对不对得上”本质是检查驱动版本是否满足CUDA运行时的最低要求,通常通过nvidia-smi查看驱动支持的最高CUDA版本,再与框架所需版本比对。
GGUF和AWQ是两种常见的大模型量化格式,直接影响模型能否在你的硬件上运行以及运行效率。GGUF(GPT-Generated Unified Format)是llama.cpp使用的格式,支持CPU与GPU混合推理,对显存要求灵活,适合消费级显卡;AWQ(Activation-aware Weight Quantization)是一种面向GPU的4bit量化方法,通常用于vLLM等高性能推理引擎,需要足够的显存且对GPU架构有要求。下错格式会导致引擎无法加载模型,或性能远低于预期。第16环“格式别下错”指的是根据你选择的推理引擎和硬件条件,选择匹配的量化格式与量化等级(如Q4_K_M、Q5_K_M等),否则可能白白浪费下载时间和存储空间。
先定位:你属于哪一类使用者
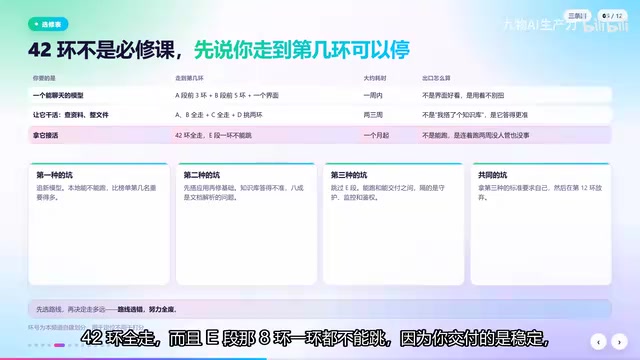
42环不是必修课。UP主按需求把路径分成三种走法:
第一种,只想要一个能聊天的本地模型。 走A段前3环、B段前5环,再挑一个界面,到第18环就可以停。大概一周,钱在三千以内。出口不是界面好看,是用着不别扭。
第二种,想让它干活,比如查资料、整文件。 A、B段走完,C段全走,D段挑知识库和定时任务两环,到第34环。两三周。出口不是「我搭了个知识库」,而是「它比直接问模型更准」。
第三种,想拿它接活。 42环全走,E段那8环一环都不能跳,因为你交付的是稳定,不是「能跑」。出口是它连续跑两周没人管也没事。
先想清楚你要的是哪一种,再决定走多远。不然你会拿第三种的标准要求自己,然后卡在第三种和第一种之间。
八个问题,测出你卡在第几环
回答下面八个问题,答「是」就往下一环:
- 系统装好了吗?
- 显卡驱动和CUDA对上了吗?
- 同一个包你是不是装了三个版本?
- 你知道自己用的是哪个引擎、哪种装法吗?
- 你第一次出字花了多久?
- 模型权重放在哪个盘、占了多少?
- 你下的文件后缀是GGUF还是AWQ?
- 第一次显存爆掉,你是降档解决的还是重装了系统?
UP主说大多数人卡在第3题——卡在第三题,你就在第12环。这不是能力问题,因为第三题从来不写在教程里。
四个「跳过后不报错」的高危环
有些环跳过去的时候悄无声息,一周后才来找你:
- 第12环·环境干净:跳过方式是「随便装装能跑就行」,等你装第二个引擎时全崩。
- 第15环·模型权重位置:跳过方式是全塞进系统盘,等第三个模型时连装都装不进去。
- 第24环·对话模板:跳过方式是直接用默认,模型看起来很笨,你以为是模型太小。
- 第35环·开机自启:跳过方式是每次手动敲命令,重启一次它就没了。
这四个环的共同点是静默失败——不报错,所以你不会去查,等一周后问题才浮出来。
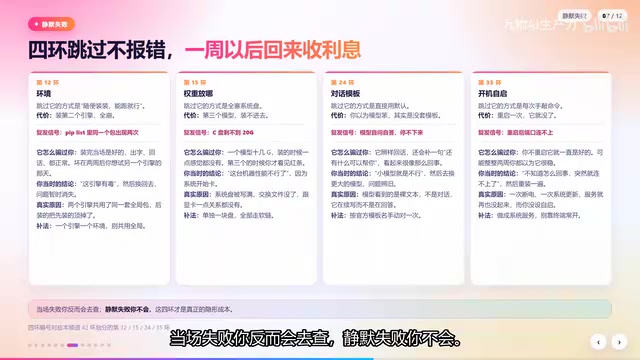
对话模板(Chat Template)是决定模型如何理解用户输入和生成回复的提示词结构。不同模型(如Llama 3、Qwen、ChatGLM)有各自的模板格式,包含系统提示、用户消息、助手回复的标记方式。若使用默认模板或错误模板,模型可能无法正确区分对话角色,导致回复质量下降、答非所问,甚至输出乱码。第24环“对话模板”之所以高危,是因为模板错误不会引发程序报错,只会让模型表现得“变笨”,新手常误以为是小模型能力不足。正确做法是在推理引擎中显式指定与模型匹配的模板,或使用引擎内置的自动模板检测功能。
时间预期:第一次完整跑通是两三周
UP主分享了自己的时间账:A段认真算要两三天,但大多数人花两小时就买了卡,这也是后面会后悔的原因;B段第一次走两到三天,第二次走半小时,差别不在变聪明了,而在于踩过的错不会重踩;C段一天,主要耗在界面和模板;D段一环一天起,知识库要两天;E段半天,但得在两周里反复验证。
第一次完整跑通大概是两到三周,不是两三个小时。心理预期错在这里:你按两三个小时规划,然后花了三天还没过第12环,就会得出「我不适合干这个」的结论。
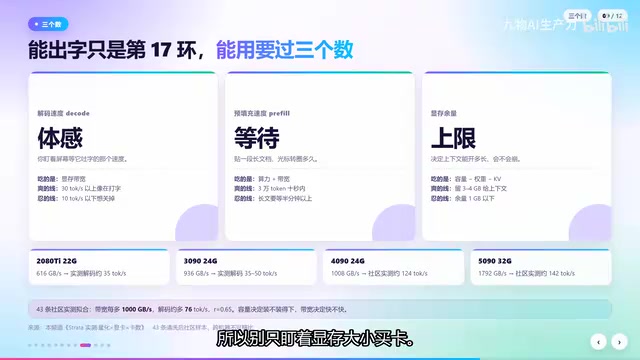
出字只是第17环,「能用」要过三个数
- 解码速度:决定你觉得它快不快。
- 预填充速度:决定你贴一段长文档要等多久。
- 显存余量:决定你能开多长上下文、会不会第二天就崩。
UP主提到社区有人把四十多条实测汇总:显存带宽每多一千GB/s,解码大约多7.6个token每秒,相关系数0.65。这是社区样本,不是实验室数据,只给方向不给绝对值。但结论够硬:容量决定装不装得下,带宽决定你觉得它快不快。所以别只盯着显存大小买卡。
解码速度(Decode Speed)指模型生成每个输出token所需时间的倒数,通常以tokens/s衡量,反映对话的流畅感;预填充速度(Prefill Speed)指模型处理输入提示词(如长文档)时每秒能处理的token数,决定你等待首字回复的时间。两者受显存带宽、模型量化程度、批处理大小等因素影响。显存余量则指加载模型后剩余的显存空间,它决定了你能设置的上下文长度(Context Length)以及能否同时运行其他任务。上下文越长,键值缓存(KV Cache)占用越多,显存余量不足会导致推理中断。因此,评估“能用”需同时关注这三个指标,而非仅看模型能否出字。
三个不建议做的事
第一,别为了跑通一个demo去买新卡。 先用手上那张卡走到第17环,你才知道自己真正缺的是显存还是带宽。顺序反了一定会买错。
第二,别一上来就搭知识库做微调。 那是第26环以后的事。你连第12环都没过,搭出来的东西不好用,你会以为是模型不行。
第三,没有验证手段就别微调。 你会得到一堆「我觉得变好了」,然后在真实场景里发现它更差。
这三条不是劝你别做,是劝你把顺序做对。顺序对了,每一步都能验证;顺序错了,你连错在哪都不知道。
今晚就能做的三件事
- 回答那八个问题,写下你卡在第几环。 写出来之后,你会发现自己的问题比上面说的更具体。
- 如果卡在第12环,先别碰新东西。 把环境清干净,走一遍最小可复现的路径,记下每一步用了什么版本。
- 在评论区留下三个信息:卡的型号、你跑的模型和量化方式、卡在第几环。 按环号对照,你会发现很多人跟你卡在同一环。
这三件做完,你明天该动哪一环就确定了。UP主最后给了个建议:把五段环「98898」的图截下来——A段问三个数字,B段解八种报错,C段让它被用上,D段让它干活,E段让它活过两周。高危的是第4(实体环,跳了不报错)以及第12、15、24、35环,后续会从最卡人的B段八环开始一环一期往下讲。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。