AI大模型求职指南:工程化落地与算法研究两大方向全解析

在AI大模型热潮持续升温的当下,越来越多的技术从业者希望转型进入这一领域。但面对纷繁复杂的岗位名称和技术栈,很多人陷入了迷茫:到底该往哪个方向发力?需要掌握哪些核心技术?本文基于一线大模型就业市场的分析,为你梳理清晰的求职路径与技术脉络。
大模型求职的两大核心方向
分析AI大模型就业市场时,有一个常见的认知误区:很多人习惯用「岗位名称」给自己定位。但实际上,更科学的分类方式应该基于工作的实际性质,而非头衔。
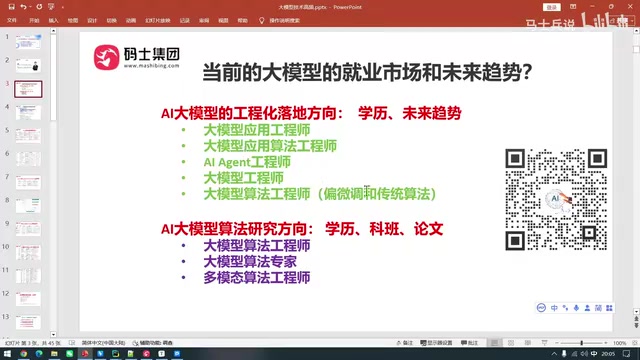
从工作性质出发,大模型相关岗位可以清晰地划分为两大类:
- 大模型工程化落地:偏向应用与工程实现,负责将大模型能力真正落地到业务场景中。
- 算法研究方向:偏向底层研究,涉及模型架构、训练方法、算法创新等前沿探索。
这两个方向在薪资待遇、准入门槛和职业发展路径上都存在显著差异。选择哪一条路,往往决定了你未来数年的学习重心与职业轨迹。
算法研究方向:高门槛与高回报并存
专注算法研究的岗位,薪资水平通常远高于行业平均线。这类岗位站在大模型技术的最前沿,负责模型的核心创新工作。
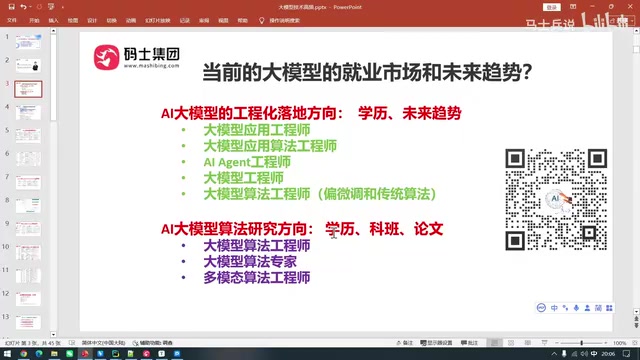
大模型算法研究方向涵盖的技术领域极为宽泛,主要包括:预训练架构优化(如注意力机制改进、长上下文建模)、高效微调方法(如LoRA、QLoRA、Prefix Tuning)、对齐技术(如RLHF、DPO,旨在让模型行为符合人类意图)、模型压缩与推理加速(量化、蒸馏、投机解码),以及多模态融合等前沿方向。这一赛道的主要玩家是头部大厂(OpenAI、Google DeepMind、Anthropic、百度、阿里、字节)和顶尖高校实验室。
但高回报的背后,是极高的准入门槛:
- 学历要求:通常需要985院校硕士及以上学历,这是最低标准,而非优选条件。
- 科研背景:往往还需要有相关领域的论文发表作为敲门砖。论文发表经历之所以成为硬门槛,是因为这类岗位本质上是「工业界科研岗」,需要候选人具备独立提出问题、设计实验、得出可复现结论的能力,而学术论文正是这一能力最直接的证明材料。
如果你具备985、211的硕士或博士学历,并手握相关研究成果,算法研究方向是值得冲刺的高价值赛道。但对于大多数普通技术从业者而言,这条路的准入壁垒相当高,需要客观评估自身条件再做决策。
工程化落地:更适合大多数求职者的方向
对于大部分求职者来说,大模型工程化落地是更现实、也更具可操作性的选择。这个方向不强调顶尖学历和科研背景,而是更看重工程能力和技术实践。
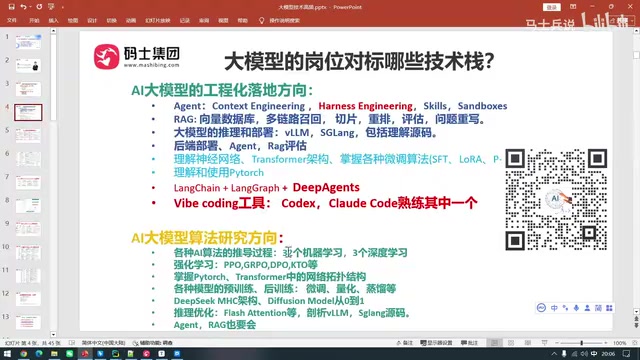
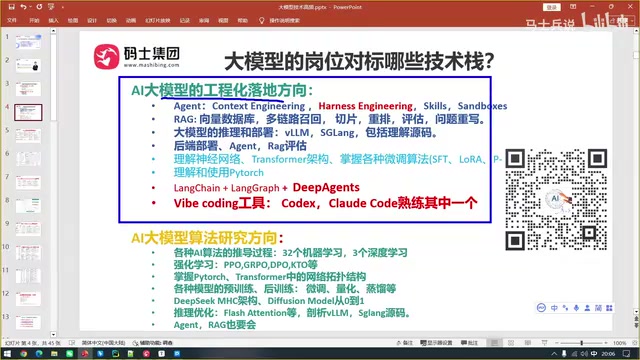
工程化落地的核心,是把大模型的能力真正「用起来」——将通用的大模型能力转化为解决实际业务问题的产品和系统。这需要掌握一整套围绕大模型应用的工程技术栈。
要深刻理解这套技术栈,梳理其演进时间线至关重要:2017年Transformer架构奠定基础;2020-2022年GPT-3等大模型证明「涌现能力」,Prompt Engineering随之兴起;2023年初ChatGPT引爆应用热潮,LangChain等应用框架快速崛起,RAG成为主流落地方案;2023年中后期,Agent范式和Function Calling(工具调用)成为新焦点;2024年起,Multi-Agent、长上下文处理以及RAG与Agent的融合(Agentic RAG)成为新热点。这条时间线揭示了一个规律:每一项新技术往往是在解决上一项技术的局限性。理解这种演进逻辑,才能预判下一个技术热点,而不是永远疲于追赶。
值得关注的是,大模型技术的迭代速度极快,工程化落地所依赖的技术栈也在持续演进。因此,理解各项技术之间的关系脉络,比孤立地啃某个单点技术更有价值。
智能体与RAG:工程化落地的两大技术核心
在工程化落地的技术体系中,有两项技术尤为关键:RAG(检索增强生成)技术和智能体(Agent)技术。
RAG技术:解决知识时效与幻觉问题
RAG(Retrieval-Augmented Generation,检索增强生成)是由Meta AI研究院于2020年提出的技术范式。其核心思路是在大模型生成回答之前,先从外部知识库中检索相关文档片段,再将这些片段作为上下文注入提示词,引导模型基于真实资料作答。这一机制有效绕开了大模型参数知识的两大硬伤:训练数据截止日期导致的知识过期,以及模型在不确定时倾向于「编造」答案的幻觉问题。
工程实现上,RAG通常依赖向量数据库(如Chroma、Milvus、Pinecone)对文档进行Embedding存储,并通过语义相似度检索召回相关片段。随着技术演进,RAG已从基础的「朴素RAG」发展出模块化RAG、Graph RAG等更复杂的变体,成为企业知识库问答、客服机器人、合规审查等场景的标配方案。在企业级应用场景中,RAG几乎是标配需求。
智能体技术:从对话工具到任务执行者
智能体(Agent)技术的核心思想源自「让LLM自主规划与行动」的研究方向,2023年随着ReAct(Reasoning + Acting)论文和AutoGPT的爆火而进入大众视野。其运作机制通常遵循一个循环:模型接收任务后,先进行思维链推理(Chain-of-Thought),分解子步骤,再选择调用合适的外部工具(如搜索引擎、代码执行器、数据库查询接口),观察工具返回结果后继续推理,直至任务完成。这一范式将大模型从被动的「回答机器」转变为主动的「任务执行者」,是当前大模型落地应用的重要突破口。
目前主流的Agent框架包括LangChain、LlamaIndex、AutoGen和CrewAI等,Multi-Agent(多智能体协作)架构也逐渐成为处理复杂工作流的重要模式。工程落地中,工具调用的稳定性、错误恢复机制和长任务中的上下文管理是核心难点。
理解这两项技术的内在逻辑——RAG解决了单纯Prompt Engineering无法引入外部动态知识的问题,而Agent又解决了RAG只能「被动检索」而无法「主动执行」的局限——并沿着技术演进的时间线梳理它们的发展脉络,是构建工程化落地能力的关键所在。技术不是孤立存在的,只有理清它们如何相互衔接、逐步演进,才能在快速变化的行业中站稳脚跟。
给求职者的四点实用建议
综合来看,想在AI大模型领域找到理想的工作机会,可以参考以下思路:
- 先明确方向:根据自身学历背景和能力,理性判断适合算法研究还是工程化落地。对大多数人而言,工程化落地是更稳妥的切入点。
- 聚焦核心技术:在工程化落地方向,优先深入掌握RAG和智能体这两大核心技术,理解其底层机制而非仅停留于API调用层面。
- 建立技术全景图:避免孤立学习单点技术,要理解各技术之间的关系与演进时间线,形成系统性认知。从Prompt Engineering到RAG,再到Agent,每一步演进都有其内在逻辑,摸清这条脉络才能举一反三。
- 持续跟进迭代:大模型技术更新极快,保持对高频技术变化的关注,是维持长期竞争力的关键。
无论选择哪条路径,清晰的方向感和系统化的技术认知,都是在这个高速发展领域站稳脚跟的前提。与其盲目追逐热点,不如先把技术脉络理清楚,再有针对性地构建自己的能力体系。
核心要点
相关推荐

Claude Code实战指南:从零搭建专属AI编程助理
基于实战教程梳理Claude Code从环境搭建、国产模型切换到Git工作流与命令体系的完整路径,帮助开发者快速搭建专属AI编程助理,少走弯路。

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。