AI代理省时还是误事?开发者社区激辩效率真相
AI代理提速明显,但返工成本可能抵消效率增益,关键在任务可验证性。
Reddit社区讨论揭示了AI代理的效率悖论:代理执行任务确实快,但修复其错误的时间有时与亲手重做相当。讨论共识认为,净收益取决于任务类型与错误可检测性——格式转换、简单脚本等易验证任务收益明显,而架构设计、长链条推理等复杂任务错误隐蔽、修复成本高。社区建议把代理当作“初级执行者”而非“资深决策者”,通过缩小任务粒度、增加中间验证步骤、保留人工审核节点来提升可靠性。文章指出,AI代理的时间账本并不总是正向,设计人机协作边界才是效率增益的关键。
AI代理(AI Agents)正以惊人的速度渗透进日常开发与办公流程,但一个尖锐的问题随之浮出水面:它们究竟帮你省下了时间,还是让你把省下的时间又花在了修复它们的错误上?Reddit社区近期的一场讨论,戳中了不少开发者的真实痛点。
效率幻觉:快是真的,返工也是真的
一位开发者在Reddit上发帖,描述了一种矛盾体验:AI代理处理任务的速度确实很快,但有时候修复它犯下的错误所花费的时间,和亲手从头做一遍差不多。他好奇其他人是否有同感,或者是否找到了让代理更可靠的方法。
这条帖子迅速引发共鸣。多位回复者表示,问题的关键不在于代理是否“快”,而在于错误出现的位置和修复成本。如果一个代理在代码生成、数据整理或自动化流程中快速产出了结果,但其中隐藏着逻辑漏洞或边界条件处理不当,那么定位和修正这些问题往往需要额外的认知负荷——甚至比原本手工操作更累。
AI代理(AI Agents) 指能够自主规划、调用工具并执行多步任务的AI系统,区别于单轮问答的聊天机器人。典型形态包括代码生成代理(如Devin、Cursor Agent)、浏览器操作代理和自动化工作流代理。其核心能力是“任务分解—工具调用—结果整合”的闭环,因此速度优势来自并行与免打断执行。但正因其自主性,错误也会沿任务链条传播:早期一步的误解会在后续步骤被放大,形成“看似完成、实则有坑”的结果。理解这一机制有助于解释为何返工成本高——修复者需要逆向还原代理的决策路径,而非简单地重做一遍。
省时与返工的临界点在哪里
讨论中浮现出一个共识:AI代理的净收益取决于任务类型和错误可检测性。对于输出结果容易验证的任务(如格式转换、简单脚本、信息检索),代理的提速效果明显,因为错误一目了然,修正成本低。而对于逻辑复杂、依赖上下文判断的任务(如架构设计、复杂业务逻辑、长链条推理),代理的错误往往更隐蔽,修复起来也更耗时。
有回复者指出,把代理当作“初级执行者”而非“资深决策者”来使用,心态上会更合理:你仍然需要为最终结果负责,代理只是加速了草稿生成。
错误可检测性是评估代理净收益的关键维度。它指任务输出被验证的难易程度:格式转换、语法检查等任务有确定性判据,错误可即时暴露;而架构设计、业务逻辑推理等任务缺乏自动判据,错误往往在集成或上线后才显现。工程上常以“验证成本/生成成本”比值衡量:比值越低,代理越划算。这也解释了为何同一代理在不同任务上口碑两极——收益并非来自模型本身,而来自任务的可验证结构。
让代理更可靠的实践方向
尽管帖子以提问为主,但回复中透露了一些提高可靠性的思路:缩小任务粒度、增加中间验证步骤、为代理提供更明确的约束条件和示例。也有开发者提到,在关键流程中保留人工审核节点,比追求全自动更务实。
这场讨论没有给出万能答案,但它揭示了一个被营销话术掩盖的事实:AI代理的时间账本并不总是正向的,而如何设计人机协作的边界,才是决定效率增益的关键。
任务粒度(task granularity) 指拆分给代理的子任务大小。粒度越细,单步输出越易验证,错误定位越精确,但拆分开销和上下文丢失风险上升;粒度过粗则验证困难、返工代价高。实践中常见的折中是“小步快跑+检查点”:每个子任务附带明确的输入输出契约和验收条件,代理完成一步即触发验证,通过后再进入下一步。这与软件工程中的持续集成思想同源,把代理执行视为一条需要质量门禁的流水线,而非一次性黑箱交付。
相关推荐
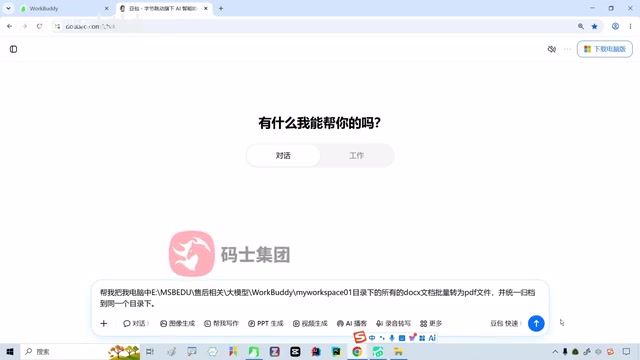
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。
AI Agent开发面试高频考点:RAG、多智能体与token优化
基于B站Agent面经视频,梳理AI Agent开发面试的高频考点:RAG评估、单/多智能体选型、token成本控制、死循环排查与项目阐述技巧,帮助理解面试官真正考察的能力维度。
AI智能体开发全流程:从技术搭建到合规上线
详解AI智能体开发全流程:教培智能体的底层架构搭建、四大教学功能模块、深度合成算法与大模型上线备案、高并发部署与长期运维,三阶段标准化流程与周期拆解。