AI导师如何破解学生学习僵局?万次对话研究揭示关键规律
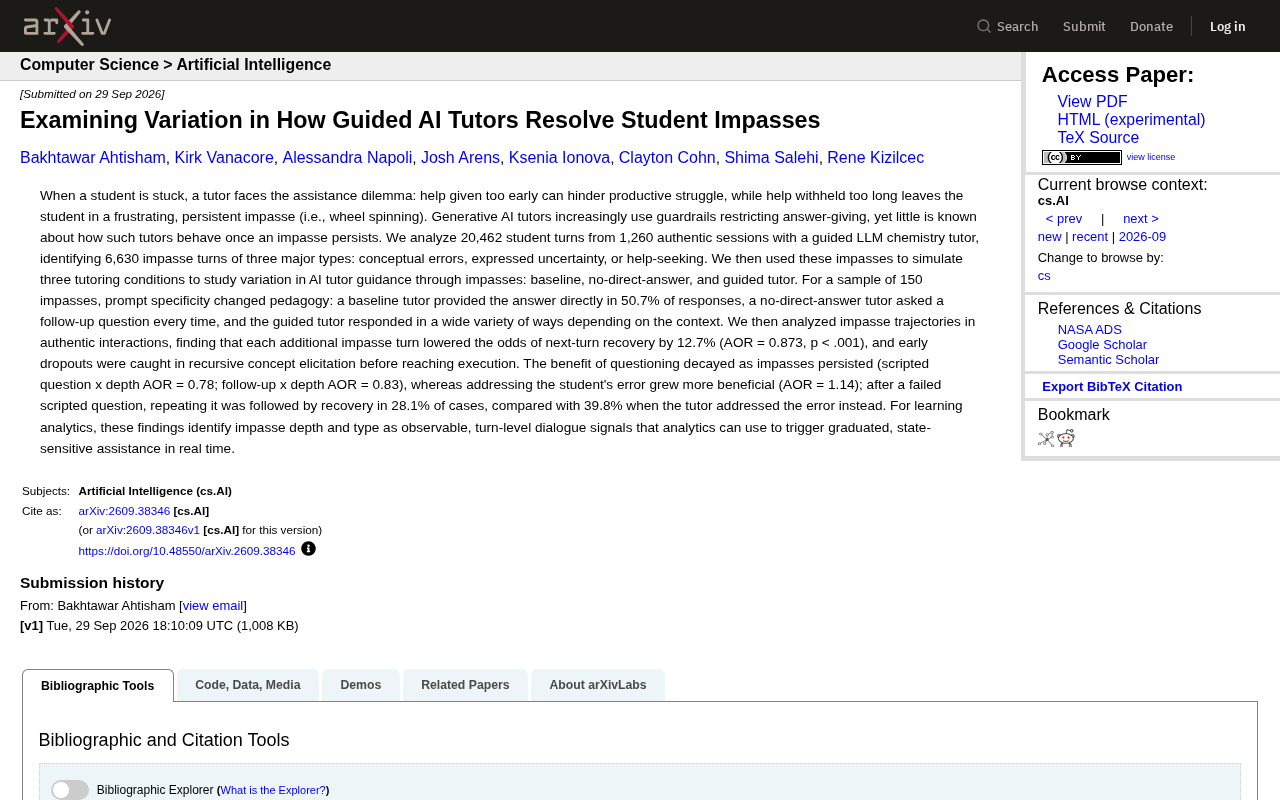
研究分析两万条AI师生对话,发现僵局越深提问越无效,及时转向直接纠错才是关键。
一项基于1260个真实学习会话的研究,系统分析了引导式AI化学导师在学生卡壳时的应对策略及其效果。研究发现,学生每多经历一个僵局回合,下一回合脱困几率就降低12.7%,僵局会累积恶化。更重要的是,不同干预策略的有效性随僵局加深而发生逆转:提问在初期有效,但持续僵局中效果衰减;而直接处理学生错误的策略,随僵局加深反而愈发有效。脚本提问失败后重复提问,学生脱困率为28.1%;若转为直接纠错,则升至39.8%。这对当前流行的「一刀切禁止给答案」式AI护栏设计提出了挑战,提示AI教育产品需要实时感知僵局状态,动态切换援助策略,而非机械执行单一规则。
当学生卡壳时,AI导师该怎么办?这看似简单的问题,背后藏着教育学中一个经典的两难困境。一篇发表在arXiv上的新研究(arXiv:2609.38346)通过分析超过两万条真实师生对话,首次系统揭示了引导式AI导师在学生陷入持续僵局时的行为模式,以及不同干预策略的实际效果差异。
辅助困境:帮早了还是帮晚了
研究开篇就点出了AI教学的核心矛盾——「辅助困境」(assistance dilemma)。帮助给得太早,会剥夺学生「有效挣扎」(productive struggle)的机会,削弱学习效果;而帮助迟迟不来,学生则会陷入令人沮丧的持续僵局,也就是所谓的「原地打转」(wheel spinning)。
如今的生成式AI导师越来越多地使用「护栏」(guardrails)机制,限制直接给出答案,试图鼓励学生独立思考。但一个被长期忽视的问题是:当僵局持续存在、学生反复卡在同一个点上时,这些AI导师究竟会如何应对?此前学界对此几乎一无所知。
「有效挣扎」(productive struggle)这一概念源自认知负荷理论与建构主义学习理论的交叉研究。心理学家Robert Bjork将其纳入「合意困难」(desirable difficulties)框架:适度的认知阻力能迫使学习者进行更深层的信息加工,从而形成更稳固的长期记忆。与之相对,「原地打转」(wheel spinning)最早由Baker等人在2011年针对智能辅助系统(ITS)的研究中正式定义,特指学生在某个知识点上反复失败却毫无进步的状态,被视为学习系统需要识别并干预的负面信号。两者共同构成了自适应学习系统长期面临的核心设计张力:系统既不能过早介入消除挣扎,也不能任由无效循环持续耗尽学生的学习动机。
两万条真实对话里的「卡壳」时刻
研究团队分析了一个引导式LLM化学导师的真实使用数据:来自1260个真实学习会话的20462个学生回合。从中他们识别出6630个「僵局回合」(impasse turns),并归为三大类型:
- 概念性错误:学生对知识点理解有误
- 表达不确定性:学生对自己的答案没把握
- 主动求助:学生直接寻求帮助
这种基于真实数据的分类,让研究不再停留在实验室假设,而是建立在学生实际遭遇的学习障碍之上。这也是该研究方法论上的一个亮点——僵局的深度和类型,本身就是可观测的、回合级别的对话信号。
提示词的「specificity」决定教学风格
为了研究AI导师在僵局中的表现差异,团队设计了三种教学条件进行模拟:基线导师(baseline)、禁止直接答题导师(no-direct-answer)和引导式导师(guided tutor)。
在150个僵局样本的测试中,提示词的具体程度直接改变了教学行为:
- 基线导师在50.7%的回复中直接给出了答案
- 禁止直接答题导师则每一次都抛出追问,机械地回避答案
- 引导式导师表现最为灵活,会根据具体语境给出多样化的回应
这组对比颇具启发性:简单粗暴的「不给答案」规则,虽然守住了护栏,却也让导师变得僵化——无论学生处于何种状态,一律用提问应对。而精心设计的引导式提示,才能让AI在「给答案」和「促思考」之间找到动态平衡。
「护栏」(guardrails)在大语言模型应用中通常指通过系统提示(system prompt)或外部过滤层对模型输出施加的行为约束。在教育场景下,这类约束往往被设计为「不直接给出答案」,目的是防止学生直接抄用AI回复而绕过学习过程。然而,提示词的粒度(specificity)决定了护栏的灵活程度:高度规则化的提示(如「永远不要给出答案」)会导致模型在任何情境下都机械执行同一策略,而精细化的情境感知提示则能让模型在不同学习状态下选择不同回应方式。这一发现与提示工程(prompt engineering)领域的研究一致——指令的清晰度与具体度,直接影响LLM的行为多样性与情境适应能力。
僵局越深,脱困越难
研究最有价值的发现来自对真实互动中「僵局轨迹」的分析。数据显示,学生每多经历一个僵局回合,下一回合成功脱困的几率就降低12.7%(调整后比值比AOR = 0.873,p < .001)。换句话说,僵局是会累积恶化的——陷得越久,越难走出来。
更关键的是,不同干预策略的有效性会随僵局加深而发生逆转:
- 提问的效果会衰减:脚本化提问与深度的交互项AOR为0.78,追问与深度的交互项AOR为0.83,都意味着随着僵局持续,提问的帮助在减弱
- 针对错误的回应则愈发有效:直接处理学生错误的策略,其效果反而增强(AOR = 1.14)
一组对比数据尤为直观:当一次脚本化提问失败后,如果导师只是重复这个问题,之后学生脱困的比例为28.1%;而如果导师转而直接处理学生的错误,脱困比例则升至39.8%。
这意味着,「一味提问」并非万能解药。在学生刚卡住时,提问能激发思考;但当学生已经深陷僵局,继续绕圈子式的追问只会加剧挫败感,此时直面并纠正错误才是更有效的出路。
研究采用的「调整后比值比」(Adjusted Odds Ratio, AOR)是一个来自逻辑回归分析的统计量,用于在控制其他变量的前提下衡量某一因素对二元结果(此处为「是否脱困」)的影响程度。AOR = 0.873意味着每增加一个僵局回合,成功脱困的概率约下降12.7%(即乘以0.873);AOR = 1.14则意味着针对错误的回应每出现一次,脱困概率提升约14%。「交互项」(interaction term)的引入尤为关键——它捕捉的不是某策略的主效应,而是该策略与僵局深度之间的联合效应,从而揭示了「同一策略在不同僵局阶段效果相反」这一反直觉结论。这种随时间演变的动态效应分析,比单纯比较策略优劣更贴近真实教学场景的复杂性。
对AI教育产品的现实启示
研究还观察到一个值得警惕的现象:早期流失的学生,往往被困在「递归式概念追问」中,始终无法进入实际的解题执行阶段。AI导师反复在概念层面打转,反而把学生逼到了放弃的边缘。
对于学习分析(learning analytics)和AI教育产品而言,这项研究提供了可操作的设计思路:僵局的深度和类型是可以实时观测的对话信号,系统可以据此触发「分级的、状态敏感的」援助。
具体来说,理想的AI导师应当做到:
- 在僵局初期,用提问鼓励学生自主探索
- 实时监测僵局深度,当发现学生反复卡壳时,及时切换策略
- 对深层僵局,果断从「提问模式」转向「直接纠错模式」,避免原地打转
这对当前主流的「一刀切禁止给答案」式护栏设计提出了挑战。真正有效的AI教学,不在于是否给答案,而在于能否根据学生的实时状态动态调整援助强度与方式。随着AI导师在教育场景中的普及,这种基于数据的精细化教学策略,或将成为区分产品优劣的关键。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。