Perplexity Pro限制收紧引众怒:AI订阅隐形降级怎么破
一位Pro用户的困惑
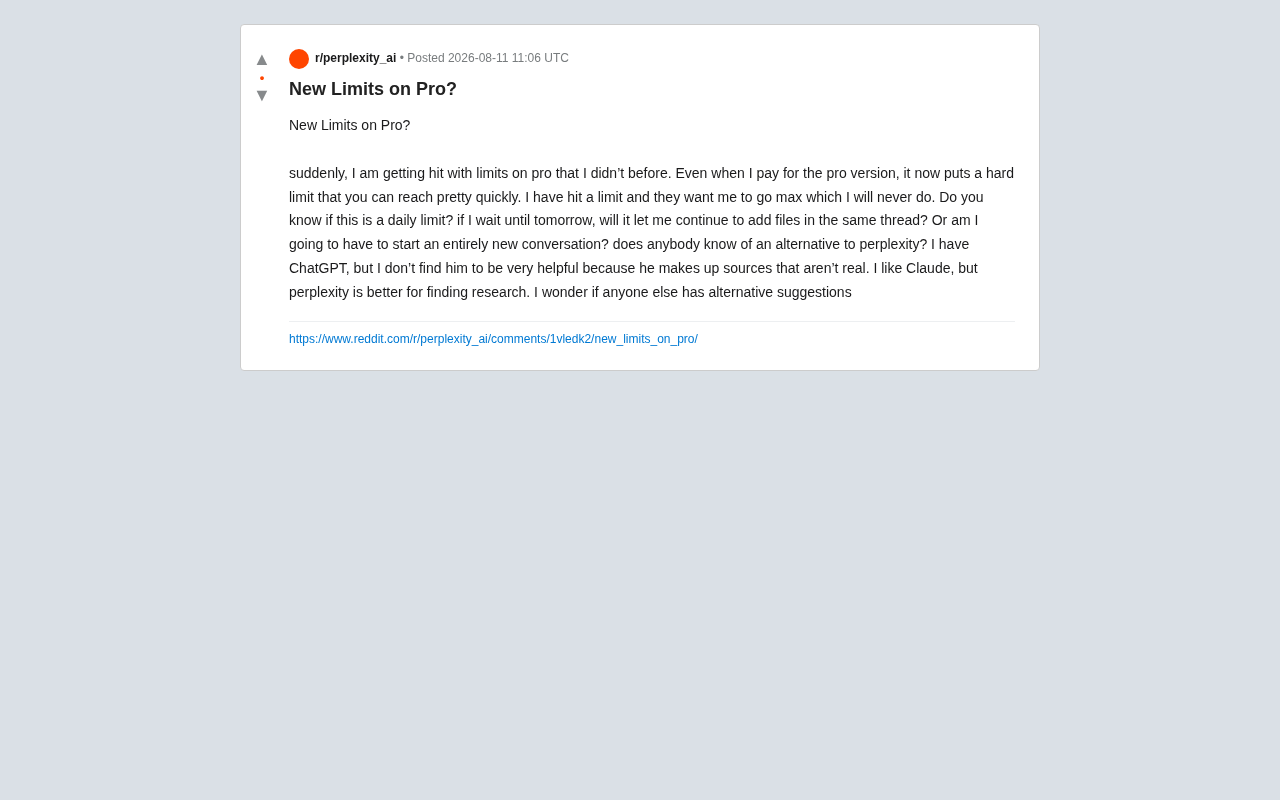
近日,一则来自Reddit的帖子引发了AI付费用户群体的广泛共鸣。一位Perplexity Pro订阅用户抱怨称,自己突然遭遇了此前从未有过的使用限制:"即使我已经付费购买了Pro版本,现在它也设置了一个硬性上限,而且你很快就能触达。"
更让这位用户感到不满的是,触及限制后,平台便开始引导其升级到更高价位的Max套餐——而这正是他明确表示"永远不会考虑"的选择。Perplexity目前采用Pro(约20美元/月)和Max(约200美元/月)的阶梯定价模式,这反映了AI行业正在从单一订阅层级向多层级分化演进的趋势。这种策略借鉴了SaaS行业的成熟做法,OpenAI的Plus与Pro、Anthropic的Pro与Max同样遵循类似的阶梯逻辑。然而,不同层级的差异主要体现在模型调用次数、可用模型种类和上下文长度等维度,当中间层级的配额被压缩以推动向上迁移时,用户可能不会选择升级,而是选择离开。这种"付了费却依然被限制,然后被推销更贵套餐"的体验,成为许多订阅用户共同的痛点。
这位用户还提出了几个非常实际的疑问:这究竟是每日限制吗?如果等到第二天,是否能在同一对话线程中继续添加文件?还是必须重新开启一段全新的对话?这些问题的模糊性,恰恰反映出许多AI产品在配额政策透明度上的不足。
订阅制AI的"隐形降级"现象
这起个案背后,折射出当前AI订阅服务领域一个值得警惕的趋势——在不调整价格的前提下,悄然收紧付费用户的使用配额。
为何AI服务商会收紧配额?
从行业视角分析,AI服务提供商面临着巨大的算力成本压力。大语言模型的推理成本高昂,尤其是涉及联网检索、文件处理、多轮对话等复杂任务时,单次请求的成本远超普通认知。
要理解这一成本压力,需要了解大语言模型的"推理"(Inference)机制。与模型训练是一次性的巨额投入不同,推理发生在每一次用户交互中——模型需要根据输入生成输出,这是一项持续性的运营开支。以GPT-4级别的模型为例,单次复杂查询的算力成本可能在几美分到几十美分之间,而当涉及联网检索、文件解析、长上下文窗口处理时,成本会进一步攀升。这意味着一个月活跃的Pro用户,其实际消耗的算力成本很可能接近甚至超过其订阅费用,这正是服务商面临的核心经济矛盾。
当用户增长与算力成本失衡时,收紧配额往往成为企业控制成本的直接手段。这种做法在商业上或许可以理解,但对用户而言却构成了实质性的"隐形降级":付费金额未变,可用价值却缩水了。更微妙的是,配额收紧常常与更高价位套餐的推出同步进行,形成一种"付费墙上移"的策略——原本Pro能满足的需求,现在被推向了Max。
配额透明度是关键
有意思的是,帖主对限制的具体机制毫不知情:不清楚是每日重置、每周重置,还是按对话线程计算。这种不透明性本身就是一个问题。健康的订阅关系应当建立在清晰的预期之上,用户有权在付费前了解自己能获得什么。当规则变得模糊且可随时变更时,信任便开始流失。
Perplexity与ChatGPT、Claude的对比
在这场讨论中,一个有趣的细节是帖主对不同AI工具的横向评价,这反映了当前主流AI产品各自的定位。
这位用户明确指出:Perplexity在研究检索方面表现最优。这正是Perplexity的核心竞争力所在——它将大语言模型与实时搜索深度结合,能够提供带引用来源的答案,非常适合学术研究、资料查证等场景。这种能力的技术基础是检索增强生成(Retrieval-Augmented Generation, RAG)架构。RAG的工作原理是在大语言模型生成回答之前,先从外部知识源(如互联网、数据库、学术文献库)中检索相关信息,然后将检索结果作为上下文输入模型,使其基于真实数据生成回答。这种架构有效缓解了纯生成式模型容易"编造"内容的问题,同时能够提供可追溯的引用来源,让用户能够验证信息的准确性。Perplexity正是将RAG做到了产品级别的极致体验,这也是它在研究场景中脱颖而出的关键。
相比之下,他对ChatGPT颇有微词:"我觉得它不太有帮助,因为它会编造根本不存在的来源。"这一评价直指大语言模型的经典问题——幻觉(Hallucination)。幻觉是当前LLM领域最棘手的技术挑战之一,其根本原因在于大语言模型本质上是概率性的文本生成系统——它们基于训练数据中的统计模式来预测下一个最可能的词元(token),而非从结构化的知识库中检索事实。当模型遇到训练数据覆盖不足的领域,或被要求提供具体引用时,它会倾向于生成"看起来正确"但实际上不存在的内容,包括虚构的论文标题、DOI编号甚至作者姓名。目前业界应对幻觉的主要策略包括RAG、思维链推理(Chain-of-Thought)以及基于人类反馈的强化学习(RLHF),但尚无根本性的解决方案。当模型缺乏可靠的检索机制约束时,这种虚构引用的问题在研究场景中尤为致命。
对于Claude,用户则给出了正面评价,认为它"很不错",但在研究检索的专项能力上仍不及Perplexity。这种评价勾勒出一个清晰的产品生态图景:不同工具在不同任务上各有所长,很难有单一产品通吃所有场景。
用户的选择困境与Perplexity替代方案
帖主最后的求助——"有人知道Perplexity的替代品吗?"——道出了许多用户在遭遇服务降级时的真实心态。
现实的替代选项
对于以研究检索为核心需求的用户,市场上确实存在多个可考虑的方向:
- 具备联网检索能力的AI工具:如ChatGPT的搜索功能、Google Gemini的深度研究模式等,虽然各有侧重,但都在强化"带来源的检索"能力。
- 专业学术工具:针对文献综述、论文查证的垂直类产品,如Semantic Scholar、Elicit、Consensus等,在特定场景下可能比通用AI更可靠。这些工具直接对接学术数据库,引用的准确性有结构化数据保障。
- 多工具组合使用:许多重度用户已经形成了"用Perplexity检索、用Claude深度分析、用ChatGPT处理特定任务"的组合策略。
AI用户忠诚度的脆弱性
这则帖子最深刻的启示在于:AI用户的忠诚度远比想象中脆弱。当帖主明确表示"永远不会升级到Max"并开始寻找替代品时,实际上意味着一次配额调整就可能导致付费用户的流失。
这种脆弱性与AI对话工具极低的切换成本密切相关。在传统软件领域,用户切换成本通常很高——数据迁移、工作流重建、团队培训等因素构成了强大的锁定效应。但当前AI对话工具的情况截然不同:用户的核心资产是自己的知识和需求,而非积累在某个平台上的数据。大多数AI工具采用对话式交互,不需要复杂的学习曲线,且各产品的输入输出格式高度标准化。唯一可能构成一定切换壁垒的是用户积累的对话历史和自定义指令(如ChatGPT的自定义GPTs或记忆功能),但这些在研究检索场景中的黏性远不如预期。
在AI工具高度同质化又快速迭代的今天,用户对某个产品的偏好,很大程度上取决于其核心场景(如研究检索)能否被稳定满足。一旦这种稳定性被打破,无论是通过涨价还是隐性降级,用户都会毫不犹豫地"用脚投票"。
结语:AI订阅时代的信任经济
这起看似普通的用户抱怨,实际上是AI订阅经济成熟过程中的一个典型缩影。随着行业从"跑马圈地"进入"精细化运营"阶段,如何在控制成本与维护用户信任之间取得平衡,将成为所有AI服务商必须面对的课题。
这一挑战的核心在于AI产品独特的成本结构:不同于传统SaaS产品边际成本趋近于零,大语言模型的每一次调用都会产生实实在在的算力开支。这意味着"无限量使用"的承诺在经济上几乎不可持续,但用户对"订阅即无限"的心理预期却根深蒂固。如何在这两者之间找到合理的平衡点,同时保持政策的透明和可预期性,是整个行业需要共同探索的命题。
对用户而言,理性的应对策略是:不过度依赖单一工具,理解各产品的能力边界,并保持对配额政策变化的警觉。而对企业而言,透明、可预期的服务承诺,或许才是留住付费用户最可靠的护城河。
核心要点
相关推荐
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
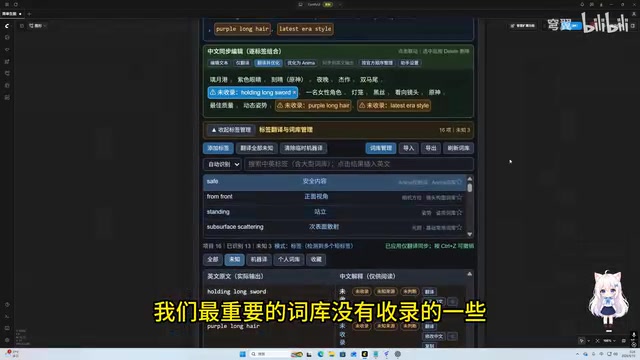
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。
16G显存跑Qwen3 27B:192K上下文+视觉实测
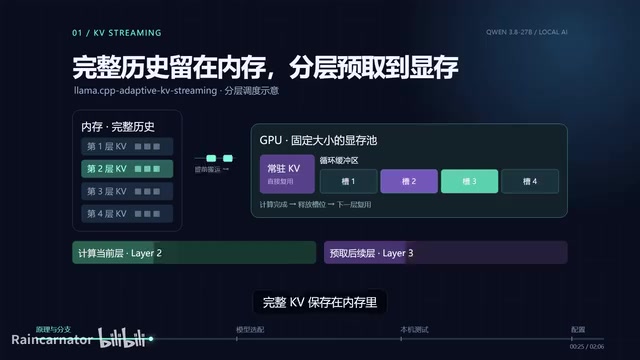
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。