AI攻克国际数学奥林匹克:最后一道难题的启示
AI推理模型从2024年答对4道到如今全解IMO六题,标志着机器长链条逻辑推理能力的历史性突破。
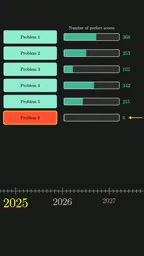
国际数学奥林匹克(IMO)长期被视为人类顶尖智力的试金石,但AI在此赛事上的进步速度令人震惊:2024年前几乎全错,2024年答对6题中的4题,2025年公开推理模型已可借助适当提示解出全部6道题。其中最后一题尤为极端——603名世界级选手中仅6人拿到满分。这道题要求在2025×2025网格上铺砖,且每行每列恰有一格未覆盖,难点不在于猜出答案,而在于严格证明该方案是最优的。AI攻克这类需要「构造解+证明最优性」的组合难题,意味着推理模型在长链条逻辑推理和形式化论证方面取得了实质性进展,也预示着更多曾被视为人类专属的高阶认知任务正在被重新定义。
AI在数学奥赛上的三级跳
国际数学奥林匹克(IMO)一直被视为人类顶尖智力的试金石,参赛者都是各国最优秀的青少年解题者。而人工智能在这项赛事上的进展,堪称近年来最具冲击力的技术叙事之一。
据3Blue1Brown(Grant Sanderson)的视频梳理,在2024年之前,AI几乎无法回答IMO级别的题目。随后,Google DeepMind推出的模型在当年的考试中答对了6道题中的4道,实现了从零到一的突破。第二年,多个机构的模型能够解答除最后一题外的所有题目。而到了今年,公开可用的推理模型只需经过适当的提示(prompting),就足以解出全部6道题。
这条进步曲线的陡峭程度令人瞩目:从「几乎全错」到「几乎全对」,AI只用了极短的时间跨度。这不仅体现了大模型推理能力的跃升,也折射出「推理模型」(reasoning models)这一技术路线的成熟。
**推理模型(Reasoning Models)**是近年大语言模型发展中的重要分支,其核心特征是在给出最终答案之前,模型会生成一段内部的「思维链」(Chain-of-Thought)过程,逐步分解问题、验证中间步骤。与直接输出答案的传统模型相比,推理模型在多步骤数学和逻辑任务上表现出显著优势。代表性产品包括OpenAI的o1/o3系列和Google DeepMind的Gemini推理版本。这类模型的训练通常引入强化学习机制,以「最终答案是否正确」作为奖励信号,鼓励模型自主探索有效的推理路径,而非简单模仿训练数据中的解题步骤。
那道难倒众人的最后一题
回看2025年的赛题,最后一道题格外耐人寻味。在603名参赛者中,每一位都是本国最优秀的6名解题高手之一,然而只有6人在这道题上拿到满分。这个比例说明,即便对世界级的人类选手而言,它也是极大的挑战。
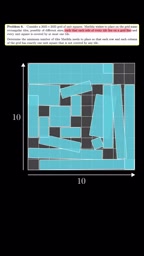
题目的设定围绕一个非常大的正方形网格展开。原题描述的是一个2025×2025的网格,为便于说明可以想象一个更小的版本。游戏规则是用瓷砖(tiles)覆盖网格,瓷砖的边缘必须与网格线对齐,瓷砖之间不能重叠。关键约束在于:每一行恰好有一个单位方格未被覆盖,每一列同样恰好有一个单位方格未被覆盖。
国际数学奥林匹克(IMO)每年举办一届,每个参赛国最多派出6名选手,参赛者通常为高中生。竞赛共6道题,分两天作答,每天3题,每题满分7分。题目涵盖代数、组合数学、数论和几何四个领域,但不涉及微积分等大学课程内容,考验的是创造性的初等数学推理。IMO被广泛认为是全球难度最高的中学数学竞赛,历届得分分布极为分散——通常只有极少数选手能拿到总分满分42分,而最后一题(P6)几乎每年都是得分最低的题目,往往只有个位数的参赛者能满分作答。
为什么这道题如此困难
这道题的难点并不在于给出一个数字答案。题目要求你找出满足上述性质所需的最少瓷砖数量——但这只是任务的一部分。
作为国际数学奥林匹克的题目,真正的挑战在于严格证明:任何其他可能的铺砖方案都必须使用更多的瓷砖。换句话说,你不仅要构造出最优解,还要用数学证明堵死所有其他可能性。
正是这种「构造 + 证明最优性」的双重要求,使得组合优化类题目成为IMO中最能区分选手水平的类型。它考验的不是套用公式的熟练度,而是从无到有构建严密逻辑链条的能力——这恰恰也是过去AI最薄弱的环节。
AI能解题,意味着什么
AI能够攻克这类题目,其意义超越了「答对一道数学题」本身。IMO难题要求的严格证明,本质上是一种可验证的、多步骤的逻辑推理。模型若能稳定完成这类任务,说明它在长链条推理、反例排除和形式化论证方面取得了实质性进展。
值得思考的是,人类顶尖选手中仅6人满分,而公开的推理模型经过提示便能求解——这并不意味着AI「超越」了人类智慧,但它确实展示了机器在特定结构化推理任务上逼近甚至企及人类最高水平的可能性。
对于关注AI能力边界的人来说,这道「AI最后无法解出的IMO题」如今被攻克,标志着一个象征性节点的翻篇。它提醒我们,那些曾被认为是人类专属的高阶认知任务,正在以出人意料的速度被重新定义。
值得注意的是,「经过适当提示便能解题」与「在竞赛现场条件下可靠解题」之间仍存在方法论差异。在研究场景中,通常允许多次采样(即让模型独立尝试多次,取最优结果),并可以针对题目类型精心设计提示词;而人类选手只有一次作答机会。因此,部分研究者区分「pass@k」(k次尝试中至少一次成功)与「单次通过率」两种指标。尽管如此,AI在这类任务上的整体能力提升是真实存在的,争议主要集中在如何更公平地量化和比较人机之间的差距。
结语
从2024年答对4题,到如今全部解出,AI在数学奥赛上的进步既是技术能力的展示,也是一次关于「什么才算真正的推理」的公开检验。而那道曾经难倒机器、也难倒绝大多数人类选手的组合难题,其解题过程本身就是一段美妙的直觉与发现之旅——这也是理解AI进展时值得深入品味的部分。
相关推荐
在太空能硬拉小行星吗?质量与重量的物理真相
在太空能硬拉小行星吗?本文用通俗的物理解析揭示质量与重量的本质区别:微重力下百吨巨石几乎无重量,却仍有全部惯性,移动1米需20秒;而小行星上一跳就可能逃逸。
希腊总理坦言:政府尚未为AI冲击做好准备
希腊总理米佐塔基斯罕见坦言没有政府为AI冲击做好准备,用"我们还在打昨天的仗"形容治理与技术的错位。本文分析AI治理面临的结构性困境及其对各国的启示。
OpenWiki 真能提升输出质量吗?一场社区讨论的深度解读
OpenWiki 真能提升输出质量吗?本文围绕一则 Reddit 社区讨论,剖析成本节约与质量提升的区别,并给出评估这类开源知识协作工具的实用方法。