AI独立攻克前沿数学难题,与人类研究成果不谋而合

一则声明背后的AI数学突破
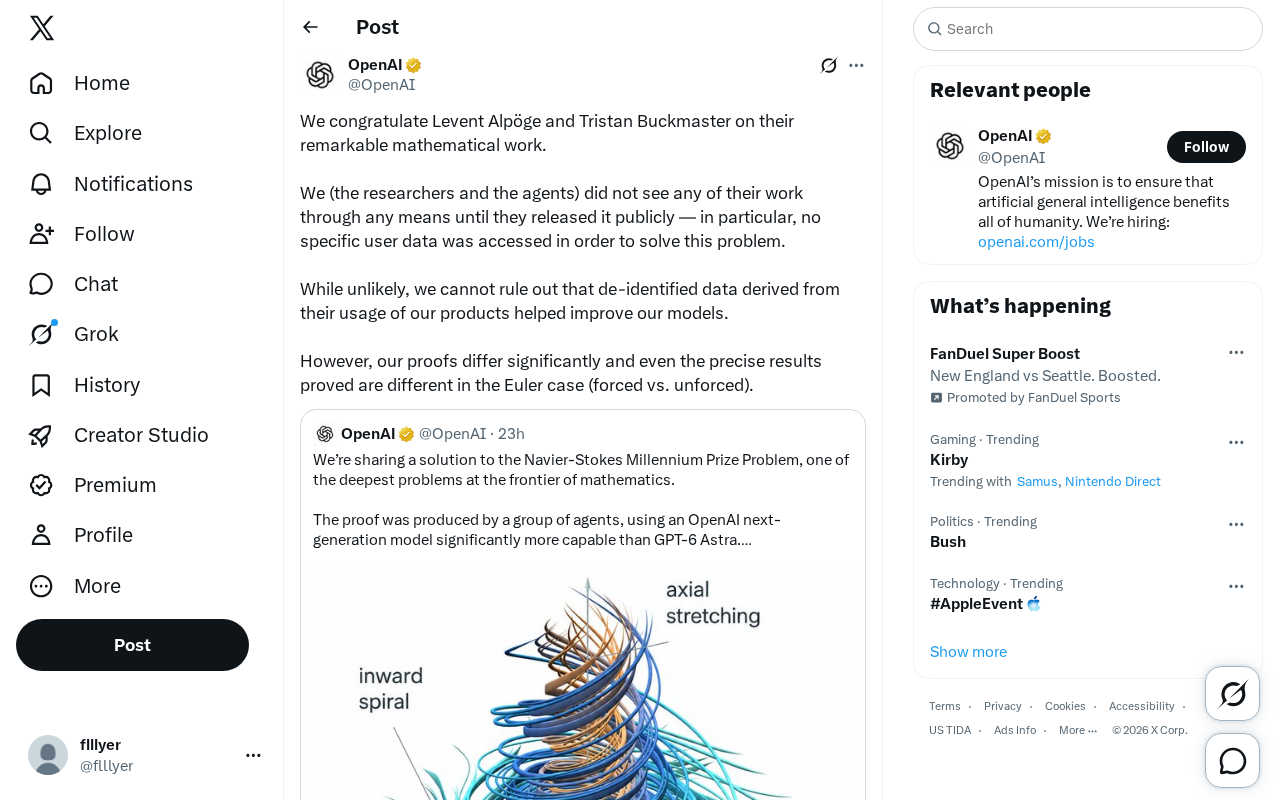
近日,某AI研究团队在社交平台发布了一则引人注目的声明,向数学家Levent Alpöge和Tristan Buckmaster的杰出数学工作表示祝贺,同时也澄清了一个关键问题:AI系统在解决相关数学问题时,并未接触到这两位数学家的任何研究成果。
这则看似简短的声明,实际上触及了当前AI发展中一个极为敏感且重要的话题——当AI能够独立解决前沿数学问题时,我们该如何界定它的"原创性"?又如何确保它不是在"抄袭"人类研究者尚未公开的成果?这一问题并非空穴来风:学术界的原创性与优先权争议由来已久,最著名的案例莫过于牛顿与莱布尼茨关于微积分发明权的百年之争,以及达尔文与华莱士在自然选择理论上的同时独立发现。在科学社会学中,不同研究者几乎同时突破同一瓶颈的现象被称为"多重发现"(multiple discovery)。社会学家罗伯特·默顿(Robert K. Merton)在1961年的经典研究中系统梳理了数百个案例,发现几乎所有重大科学突破都有多人几乎同时独立完成的记录。这背后的深层逻辑是:当学科发展到某个临界点,基础工具和前置知识都已就位时,突破就变得"水到渠成"。然而,AI的加入使这一问题变得前所未有地复杂——AI的"知识基础"来源于对人类已有文献和数据的大规模学习,其"独立性"的哲学含义与两位人类研究者各自独立思考有本质不同。AI可能接触过海量包含人类研究者思想痕迹的训练数据,其"独立性"的界定远比两位人类研究者之间的独立性更加模糊,这使得传统的学术优先权判定标准面临根本性挑战,也正是该团队需要如此详细说明数据隔离措施的根本原因。
声明核心:数据隔离与独立验证机制
未访问任何特定用户数据
声明中最关键的一句话是:"我们(研究人员和智能体)在他们公开发布之前,没有通过任何方式看到他们的工作——特别是,没有为解决这个问题而访问任何特定的用户数据。"
这一表态直击AI研究可信度的核心。在AI能力日益强大的今天,一个自然而然的质疑是:如果AI恰好解决了某位人类研究者正在攻克的难题,是否可能是因为它"偷看"了对方的工作过程?尤其是当研究者本身可能使用了该AI产品作为辅助工具时,这种担忧就更加合理。
团队明确划清界限,强调解题过程中没有访问任何特定用户数据,这是维护AI研究学术诚信的重要举措。
坦诚面对无法完全排除的间接影响
你可能没注意到,声明并没有把话说满。团队坦诚地承认:"虽然可能性不大,但我们无法排除源自他们使用我们产品所产生的去标识化数据,可能帮助改进了我们的模型。"
这种严谨的表述反映了大模型训练的复杂现实。现代AI模型通过海量数据训练,其中可能包含经过去标识化处理的用户交互数据。去标识化(de-identification)是数据处理中的关键环节,指的是移除或混淆数据中可用于识别特定个人的信息,如用户名、IP地址、时间戳等。在技术实践中,去标识化包含多种层次:最基础的是假名化(pseudonymization),即用随机标识符替换真实身份信息;更高级的方法包括k-匿名化(k-anonymity)、l-多样性(l-diversity)和差分隐私(differential privacy)等。差分隐私由微软研究员Cynthia Dwork于2006年提出,通过向数据或查询结果中注入精确校准的随机噪声,从数学上保证单个数据点的加入或移除不会显著改变输出结果,是目前被认为最具理论严谨性的隐私保护框架,已被Apple、Google和美国人口普查局等机构采用。
然而,去标识化并不等同于数据的完全匿名化——在某些极端情况下,去标识化数据仍可能通过交叉关联被重新识别。更值得关注的是,即便采用了差分隐私等严格手段,当模型规模足够大、训练数据足够丰富时,模型仍可能通过"记忆化"(memorization)现象保留某些训练样本的特征,这也是近年来模型隐私研究中的核心关注点之一。即使单条去标识化数据无法追溯到具体用户,大量此类数据在模型训练过程中的累积效应仍可能间接反映某些用户的思维模式或研究方向。即便团队主观上没有针对性地使用某人的数据,这些数据在宏观层面对模型能力的提升仍可能产生难以量化的间接贡献。
这种诚实的自我审视,恰恰体现了负责任的AI研究应有的态度。
证明路径差异:AI独立性的有力佐证
方法论存在显著不同
为了进一步证明AI工作的独立性,团队指出:"我们的证明存在显著差异,甚至在欧拉方程的情形中,所证明的精确结果也不同(强迫 vs. 非强迫)。"
这是一个技术含量很高的佐证。在数学证明中,即便最终结论相同,不同的证明路径往往反映出研究者独立的思考方式。如果AI的证明与人类数学家的证明高度雷同,反而会引发抄袭嫌疑;而两者在方法论上的显著差异,恰恰说明它们是各自独立得出的成果。
值得注意的是,AI参与数学证明并非全新的事物,但近年来的能力跃升令人瞩目。自动定理证明的历史可以追溯到1956年Allen Newell和Herbert Simon开发的"逻辑理论家"(Logic Theorist),它成功证明了《数学原理》中的38个定理。此后,形式化证明助手经历了数十年的发展:Coq(1989年)基于构造性类型论,Isabelle(1986年)采用高阶逻辑框架,而Lean(2013年由微软研究院的Leonardo de Moura发起)则以其现代化设计和活跃社区成为近年来的明星工具。2017年Kevin Buzzard发起的Mathlib项目在Lean上构建了庞大的形式化数学库,为AI与形式化数学的结合奠定了基础。这些早期系统主要依赖符号推理和穷举搜索,擅长验证已知证明的正确性,但缺乏创造性。
2024年以来,基于大语言模型的AI系统开始展现出在数学推理上的突破性表现——DeepMind的AlphaProof结合AlphaZero式的强化学习与Lean形式化验证,在国际数学奥林匹克级别的问题上达到了银牌水平,而多家研究机构的模型也开始尝试攻克前沿的开放数学问题。这些系统的核心能力并非简单的模式匹配,而是通过大规模预训练获得的数学直觉与推理链构建能力,结合强化学习和搜索算法来探索证明空间。两条技术路线——基于形式化验证的符号推理与基于自然语言的直觉推理——正在加速融合。此次事件中AI能够独立找到与人类数学家不同的证明路径,标志着AI数学推理正从"验证工具"向"发现引擎"转变。
欧拉方程中"强迫"与"非强迫"的关键区别
声明特别提到了欧拉方程(Euler equations)情形中"强迫"(forced)与"非强迫"(unforced)的区别。欧拉方程由瑞士数学家莱昂哈德·欧拉于1757年提出,是描述无黏性理想流体运动的偏微分方程组,也是流体力学中最基础的方程之一。它是纳维-斯托克斯方程(Navier-Stokes equations)在忽略黏性项后的简化形式。纳维-斯托克斯方程的光滑解存在性问题被列为克雷数学研究所七大千禧年问题之一,悬赏百万美元至今未解。欧拉方程虽然形式更简洁,但其解的正则性(即解是否会在有限时间内产生奇点或爆破)同样是数学界的核心开放问题。
近年来,凸积分(convex integration)方法在欧拉方程研究中发挥了革命性的作用。凸积分最初由数学家John Nash在1954年用于解决等距嵌入问题,后由Mikhail Gromov在1980年代大幅推广为一套强大的几何分析工具。2009年,Camillo De Lellis和László Székelyhidi Jr.将凸积分引入流体力学,开创性地用它构造了不可压缩欧拉方程的非唯一弱解,这一工作直接回应了Lars Onsager在1949年提出的关于湍流能量耗散的著名猜想。Tristan Buckmaster与合作者在此基础上进一步推进,证明了更强的非唯一性结果,深刻改变了数学界对流体方程解的理解——它表明在足够弱的意义下,方程的解可以具有极大的自由度,甚至可以"任意"构造。这也使得关于如何选择"物理上正确"的解这一问题变得更加紧迫。
所谓"强迫"与"非强迫",指的是方程中是否包含外部作用力项。非强迫方程(也称齐次方程)描述系统在没有外部能量输入时的自由演化行为,其解完全由初始条件和内在动力学决定。强迫方程则在方程右端添加了一个外力项(forcing term),代表外部能量或扰动的持续注入。从数学难度上看,两者差异巨大:非强迫情形下证明解的某些性质(如爆破、非唯一性)通常更为困难,因为系统行为完全内生;而强迫情形则允许研究者通过精心设计外力项来引导解的行为。因此,AI解决的是强迫情形,而人类数学家解决的是非强迫情形,这不仅证明了独立性,也暗示它们在技术难度和数学意义上可能存在层次差异。
这一细节上的差异表明,AI所解决的问题与人类研究者所解决的问题在数学本质上就不完全相同。这不仅证明了独立性,也从侧面说明AI在处理前沿数学问题时已经具备了真正的推理与建构能力,而非简单的模式匹配或复制。AI能够介入这一涉及偏微分方程理论中最精微分析技巧的研究领域,本身就是一个里程碑式的信号。
这则声明的深层意义
AI科研诚信的新范式正在形成
随着AI在科学发现中扮演越来越重要的角色,学术诚信问题正在从人类研究者之间的规范,扩展到"人机协作"乃至"机器独立研究"的全新领域。
这则声明实际上为AI参与前沿科研树立了一个值得参考的透明度标杆:
- 主动澄清数据来源:明确说明未访问特定用户数据
- 坦诚承认不确定性:不回避去标识化数据可能带来的间接影响
- 提供独立性证据:通过证明方法的差异来佐证工作的原创性
对未来AI数学研究的启示
当AI开始能够解决人类顶尖数学家正在研究的难题时,如何建立一套可信、可验证的评估机制,将成为整个领域面临的重要课题。
未来,我们可能需要更完善的机制来记录AI的推理过程、追溯其能力来源,并在AI取得重大发现时进行独立的第三方验证。建立AI科研成果的可信验证体系涉及多个技术层面。在证明正确性方面,Lean 4等现代形式化证明语言已具备将自然语言数学证明翻译为机器可验证代码的能力,Meta AI的"形式化数学声明自动化"(autoformalization)项目正致力于降低这一翻译过程的门槛——如果AI生成的数学证明能够被形式化验证系统完整检验,则其正确性可以得到数学层面的绝对保证,尽管原创性问题仍需额外机制来解决。在原创性追溯方面,区块链时间戳和可验证计算(verifiable computation)等技术可以为AI推理过程提供不可篡改的时间线记录。在训练数据审计方面,数据溯源(data provenance)工具和模型归因(model attribution)技术正在发展中,目标是回答"模型的某个特定能力究竟来源于哪些训练数据"这一关键问题。然而这些技术目前都远未成熟,尤其是对于数千亿参数模型的训练数据归因,在理论和工程上都面临巨大挑战。
只有这样,AI的科学贡献才能获得学术界的充分认可,同时避免陷入无休止的原创性争议。
结语
这则简短的声明虽然只有寥寥数语,却折射出AI在科学研究领域快速崛起所带来的一系列深层问题。在向Levent Alpöge和Tristan Buckmaster的杰出工作致敬的同时,AI团队也展现了在原创性、透明度和学术诚信方面应有的审慎态度。
当机器智能开始触及人类知识的最前沿,如何在推动技术进步的同时守住诚信底线,将是每一个AI从业者都必须认真对待的命题。这则声明,或许正是这一新时代的一个重要缩影。
相关推荐

Antigravity调用Gemini报错真相:IP风控实测与应对
Google Antigravity IDE调用Gemini模型频繁报错?实测发现同一账号仅切换IP即可恢复,且同IP在AI Studio仍可正常使用。本文解析这一基于IP的风控策略、成因推测及排查应对思路。
AI超级员工系统拆解:营销自动化工具的能力与风险
一款宣称"全接管基础岗位"的AI超级员工系统在B站流传,本文拆解其视频生成、数字人克隆、智能体和批量获客等功能,并客观分析其中的合规与安全风险,提醒用户警惕"免费领取"营销套路。
群像才是团体的灵魂:内娱几首氛围感满满的合唱盘点
从07届快男到NINE PERCENT,盘点内娱几首氛围感满满的群像合唱歌曲。相比单人高光与数据热度,一群人并肩同行的情谊才是团体无可替代的灵魂。