AI记忆孤岛难题:8120星开源工具ai-memory五大机制拆解

ai-memory用Markdown文件做记忆本体,解决AI编程助手换工具即丢上下文的痛点。
AI编程助手记忆各自为政,换工具或换机器就意味着上下文清零——这是每天在多个编码助手间切换的开发者的共同痛点。ai-memory是一个用Rust编写、四个月斩获8120星的开源项目,以五大机制应对这一问题:Agent生命周期钩子实现静默记录、Markdown文件作为记忆本体(数据库仅作索引)、默认无需API Key的零成本检索、分层可逆遗忘机制,以及协议化任务交接以支持跨工具无缝切换。它兼容超过三十种编码Agent,支持自建服务实现跨机器与团队协作。与同类工具追求语义理解和"记得聪明"不同,ai-memory优先保证数据"拿得回来",适合长期多工具项目场景。
换个工具就得重讲一遍:AI编程的记忆孤岛
每天在多个编码助手之间切换的开发者,大概都体会过同一种痛:在 Claude Code 里调了三天的架构方案、踩过的采坑记录,换到 Cursor 全部清零,从头再讲一遍。换台电脑更狠,整个项目的上下文直接归零。
问题出在产品侧。各家厂商把记忆存在各自的目录和专有格式里,互不相通——Claude Code 的笔记锁在 Claude Code,Cursor 的记忆锁在 Cursor,中间没有任何工具替你跨库搬运。每家都在自建一堵墙。
据 B 站 UP 主「1024 工程笔记」的分析,DeepSeek广告 的 Harness 官方之所以对记忆功能"故意留白",正是把这块空白留给了社区。而填补这块空白的,是一个四个月前才建库、如今已冲到 8120 星、且仍以每天百余颗星速度上涨的 Rust 项目——ai-memory。
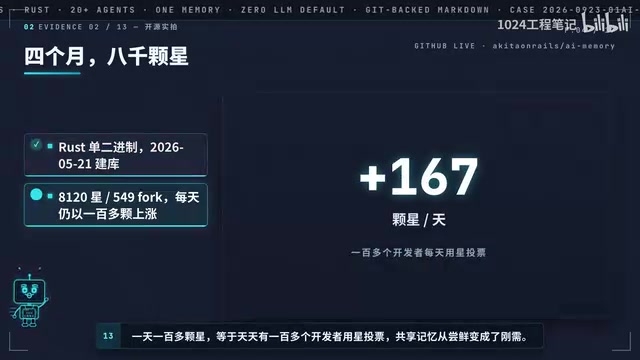
每天 100 多颗星,等于每天有 100 多个开发者用真实使用为它投票。共享记忆,正在从锦上添花的长线功能,变成刚需。
五大机制:让记忆真正属于你
机制一:静默地记,不需要指令
市面上多数记忆工具都要你专门下一道"记住"的指令。ai-memory 走的是另一条路——它挂在 Agent 的生命周期钩子上。Agent 每执行一步都会自动触发这个挂点,你说过的话、调用过的工具、断掉的会话,全部自动入库,不用你交代一个字。
「生命周期钩子」(lifecycle hook)是软件工程中一种常见的扩展机制:在某个流程的特定节点预留回调接口,让外部代码无侵入地嵌入逻辑。Agent 框架通常会在「收到指令」「调用工具前」「工具返回后」「会话结束」等节点暴露这类钩子。ai-memory 挂载其上,意味着它不需要修改 Agent 的主干代码,也不要求用户改变操作习惯——整个记录行为对使用者完全透明。这与传统「用户主动触发保存」的模式形成对比:后者依赖人的自律,前者把可靠性交给了机制本身。
机制二:文件是本体,索引只是目录
这被视为整套设计里最高明的一环。记忆本体是一个 Git 仓库里的 Markdown 文件,能被 grep、能扔进 Obsidian、能手动改、还能同步到别的机器。数据库只承担索引角色——即便索引被删光,也能从原始文件重建。
主次分明是关键:文件是原文,索引是目录,目录丢了照着原文再编一份即可。能导出的记忆才真正属于你,锁在专有格式里的记忆,等于被人扣押。
机制三:默认零成本,不依赖大模型
默认路径下,记录、检索、交接三件事全都不需要 API Key。原理并不复杂:钩子记下的本来就是文本,检索走关键词和链接匹配,全程用不上大模型。如果你愿意,也可以让模型来整理笔记,但那是可选项,不加照样完整。
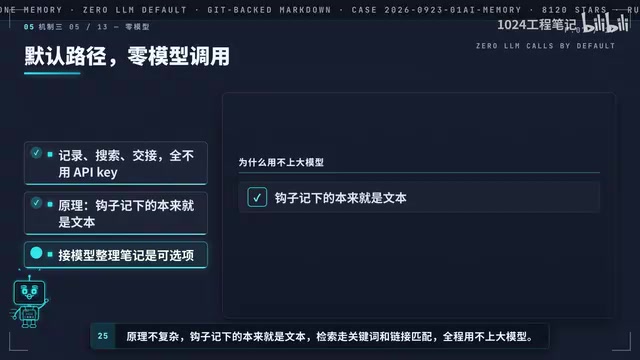
对成本敏感的开发者来说,这意味着一套记忆系统不必为每次检索付费。
机制四:会遗忘,而且可逆
容易被忽略的一点是——它会主动遗忘,并且分了层级。常用的记忆衰减得慢,冷门的笔记会被压缩成几条摘要。但要注意:即便当时定下的方案后来被判定为"路走不通",原始记录一条不删,全在 Git 的版本链里,一条命令即可恢复。
遗忘从头到尾可逆。记和忘都做到了稳定,这在长期项目里尤为重要。
机制五:协议化交接,换工具不丢上下文
你在 Claude Code 里干到一半,目录不用换,直接开 Codex 接着改。交接的内容很具体:干到了哪一步、哪些路走不通、哪些问题还开着。
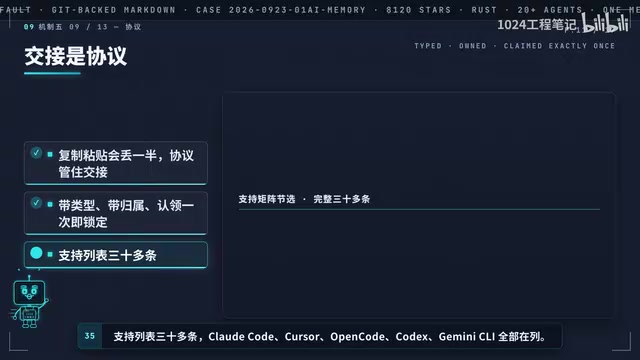
如果只靠复制粘贴,换工具照样丢一半信息。而协议管理的是"活"本身——任务带类型、带归属,认领一次即锁定,两个 Agent 同时伸手也抢不了同一个任务。支持列表超过三十条,Claude Code、Cursor、Open Code、Codex、Gemini CLI 等全部在列。
「协议化」在这里指的是任务状态的结构化表达:每条任务不只是一段文本,而是带有类型(如 bug、feature、refactor)、归属(由哪个 Agent 认领)、状态(待办、进行中、阻塞、完成)等字段的结构化记录。这类设计借鉴了分布式系统中的「幂等锁」思路——认领操作是原子的,两个 Agent 并发读取同一任务时,只有一个能成功写入「已认领」状态,另一个会读到锁定标记并跳过。这解决了多 Agent 并行协作时的经典竞争问题,也让跨工具切换时的任务交接有了可机读的明确语义,而不只是依赖人工理解的自由文本。
进阶场景:跨机器与团队协作
把服务架在自己机器上,台式机干到一半的活,笔记本可以接着干。团队指向同一个服务时,一个人踩过的坑,全组的 Agent 都能查到,多用户权限和审计日志全部内置。
UP 主分享了自己的真实场景:主力用 Claude Code,测试时开 Open Code 和 Codex,每换一次工具就要花十分钟重新交代背景。主力加测试每天切两三回,一个月下来白白搭进去半天。切换工具的真实代价其实只有一项——上下文清零。
装还是不装:三个问题对号入座
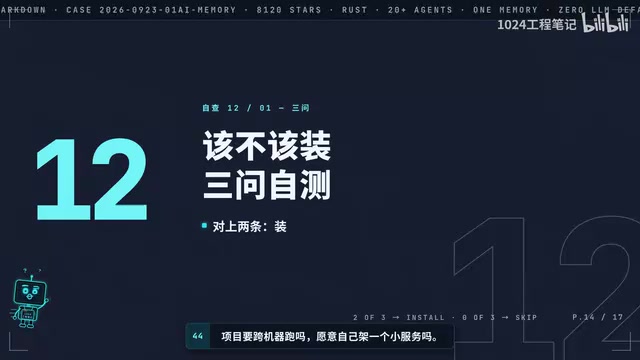
是否值得折腾,UP 主给出了三个判断标准:
- 你是否在几个 Agent 之间来回切?
- 项目是否要跨机器跑?
- 你是否愿意自己架一个服务?
对上两条就装,一条都对不上就别折腾——各家内置的记忆已经够用了。
与同类工具的路线差异
市面上同类工具不少,逐句事实抽取、时间线、知识图谱、托管服务,各走各的路。这些路线的共同追求是"记得聪明"。
ai-memory 选了另一条路:文件是本体,索引是目标。它先保证"拿得回来",再谈聪明。对长期干活的开发者而言,拿得回来比记得聪明更要紧。
回顾五大机制——静默地记、Markdown 存本体、模型可选、分层遗忘、协议化交接。DeepSeek Harness 留下的那块空白,ai-memory 补上了。至于你手上的编码 Agent 自带记忆够不够用,答案就取决于上面那三个问题。
文中提到的「知识图谱」路线,代表工具如 Mem0、Zep 等,其核心思路是将对话中的实体(人、项目、决策)和关系(依赖、冲突、替代)结构化为图节点与边,检索时沿图游走以召回关联记忆。「逐句事实抽取」则更接近 RAG(检索增强生成)的预处理阶段,把长对话切成原子事实后向量化存储。这两种方案对模型调用的依赖都较深——无论写入还是查询,都需要模型参与理解和匹配。ai-memory 选择关键词与链接匹配,牺牲了部分语义召回能力,换来的是完全离线可用、无 API 成本、以及与 Git 工具链天然兼容的可移植性。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。