AI巨头拟引入独立安全评估员,"独立性"能否兑现?
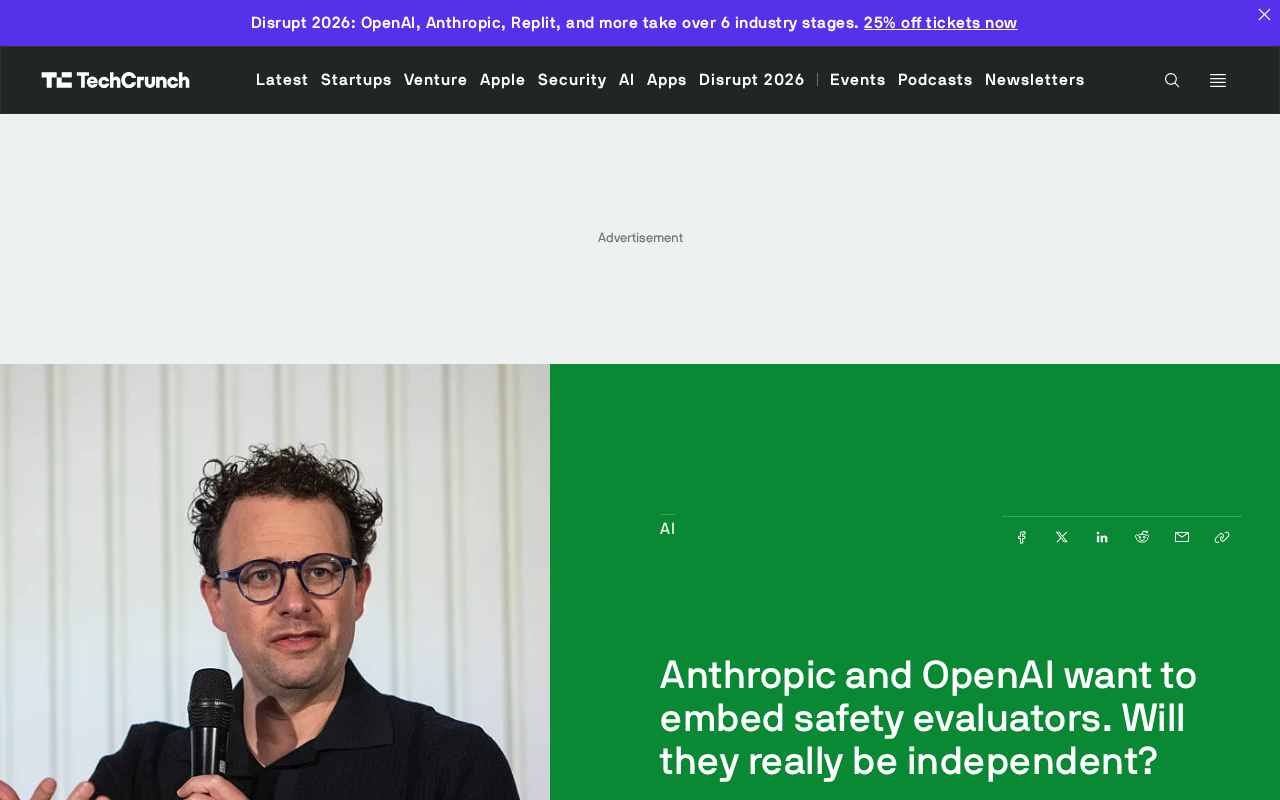
Anthropic与OpenAI拟嵌入独立安全评估员,研究者欢迎但质疑其透明度与独立性,并呼吁迈向强制监管。
Anthropic与OpenAI正推动一项罕见举措:允许独立安全评估员进驻实验室内部,直接接触前沿模型开发流程。研究界对此持审慎欢迎态度,核心质疑集中在三个层面:透明度方面,访问权本身不等于评估结论可被外部检验;独立性方面,由被评估方邀请并可能提供资源支持的评估员,其判断易受结构性利益关系影响;以及长期治理方面,自愿性安排缺乏强制约束,随时可能被收紧或取消。研究者普遍认为,嵌入式评估员可作为过渡步骤,但可靠的AI安全治理最终必须依赖制度化的外部监管框架,而非企业的自我约束。
AI实验室的一次前所未有的开放
Anthropic与OpenAI正推动一项在业界颇为罕见的举措——将独立的安全评估员(safety evaluators)嵌入到自家的AI实验室内部。这意味着外部研究者将获得对前沿模型开发流程的直接访问权限,而这种程度的透明度在此前几乎不可想象。
对长期呼吁加强AI监管的研究群体而言,这无疑是一个积极信号。前沿大模型的能力迭代速度远超外界理解,而实验室内部的训练数据、评测方法与风险缓释措施往往被视为核心机密。允许独立评估员进入,至少在形式上打破了这层封闭。
研究者欢迎,但保持警惕
研究界的反应可以概括为「欢迎,但不轻信」。获得前所未有的访问权固然值得肯定,然而访问权本身并不等同于有效的监督。多位研究者指出,真正有意义的安全评估需要同时满足三个条件:透明度、独立性,以及最终的制度化监管。
透明度:访问权不等于知情权
嵌入实验室内部只是第一步。如果评估员看到的只是经过筛选的信息,或者评估结果无法向公众披露,那么这种「访问」的实际价值将大打折扣。透明度要求的不仅是让评估员看到模型,更是让评估过程与结论能够接受外部检验。
独立性:谁付薪水,听谁指挥?
最核心的质疑落在「独立」二字上。当评估员由被评估的实验室邀请、甚至可能由其提供资源支持时,其判断是否会受到潜在利益关系的影响?这是一个结构性难题。真正的独立性通常需要评估机构在人事、经费和结论发布上都不受被评估方的控制,而当前的嵌入式安排能否做到这一点,仍是未知数。
这一困境在监管领域并不陌生,学界将其称为「监管俘获」(regulatory capture)——被监管方通过资源、信息或关系优势,逐渐影响乃至主导本应制衡自身的监督机构。在AI安全评估语境下,监管俘获可能以更隐蔽的方式发生:评估员长期浸润在实验室文化中,可能在无意识间接受了与实验室相近的风险认知框架;或者出于维持访问权限的现实考量,在结论表述上趋于保守。历史上,金融行业的评级机构、药品审查中的付费评审制度都曾因类似结构性问题而饱受批评。要避免这一风险,通常需要从评估员遴选机制、经费来源多元化以及结论发布的独立渠道等多个维度加以设计。
从自愿承诺到强制监管
研究者们普遍认为,企业自愿引入评估员固然是进步,但长期来看,可靠的AI安全治理离不开外部监管的介入。自愿性质的安排存在天然的脆弱性——它可以随时被收紧或取消,且缺乏强制约束力。
只有当独立评估被纳入法律或行业强制框架,评估员的权限、独立地位和信息披露义务才能获得真正的保障。换句话说,嵌入评估员可以是通向制度化监管的过渡步骤,但不应被视为终点。
目前全球范围内已有少数司法管辖区开始探索AI强制评估框架。欧盟《人工智能法案》(EU AI Act)要求高风险AI系统在上市前完成合规性评估,并建立了针对「通用目的AI模型」(GPAI)的透明度与第三方审计义务;美国则以行政令和自愿承诺为主,尚未形成具有法律约束力的统一评估制度。这一背景使得Anthropic与OpenAI的自愿性举措在短期内具有示范意义,但也凸显出制度真空的现实:在强制框架缺位的情况下,企业可以选择开放,同样也可以选择收紧,外部力量几乎没有法律手段加以干预。
一场关于信任的实验
归根结底,Anthropic与OpenAI的这一动作,是在试图用「开放内部」来换取外界对其安全承诺的信任。它反映出前沿AI公司在公众监督压力下的一种主动姿态,也暴露出当前AI治理机制的根本困境:在缺乏成熟监管框架的情况下,安全评估的公信力高度依赖企业的自我约束。
这场实验的成败,将取决于几个关键问题的答案——评估员能否真正独立?评估结论能否公开?以及行业是否会朝着强制性监管迈进。在这些问题得到清晰回应之前,「独立安全评估员」更像是一个值得期待却尚待验证的开端。
相关推荐
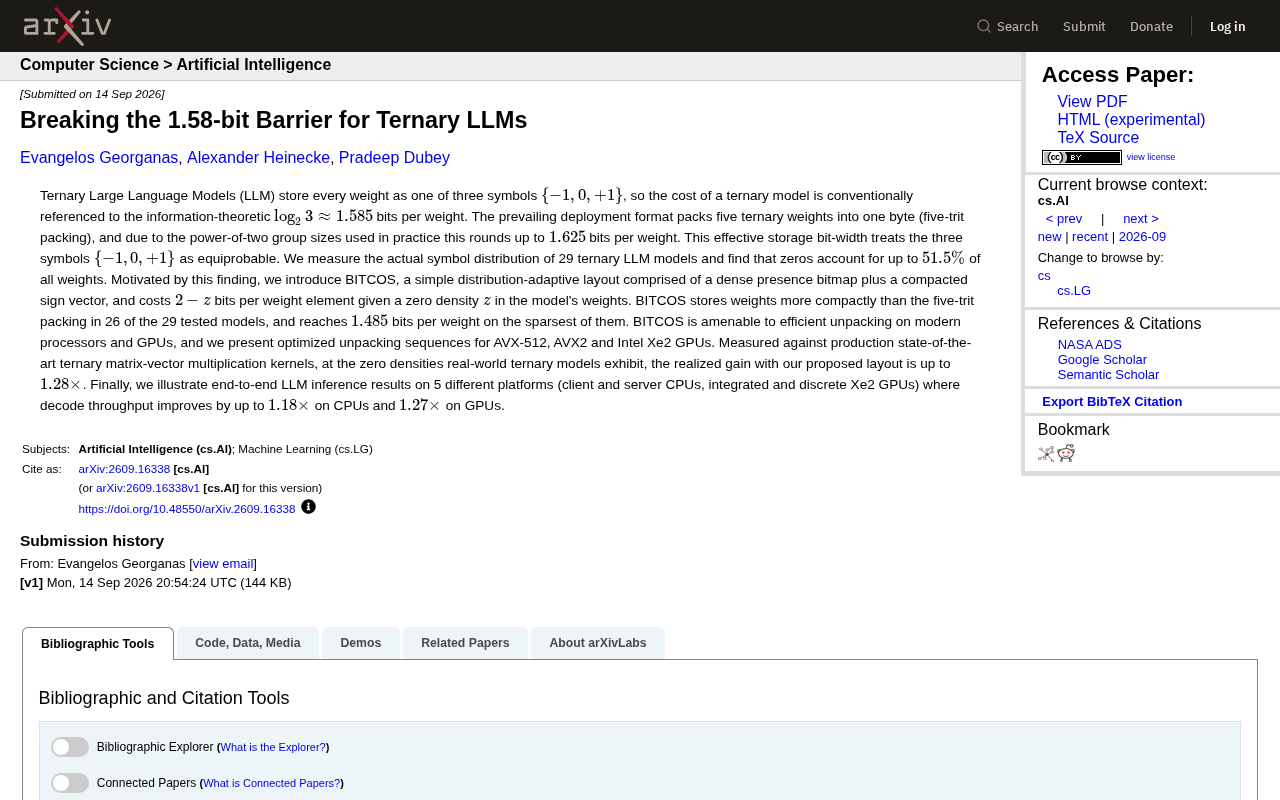
突破1.58比特极限:三元LLM如何逼近信息论边界
三元大模型(ternary LLM)的1.58-bit并非真正下限。本文解析为何利用权重稀疏分布与熵编码可以突破这一信息论壁垒,以及其对低比特量化与端侧部署的工程意义。
DACA-GRPO:为扩散语言模型强化学习引入去噪感知信用分配
DACA-GRPO 是一种为扩散语言模型强化学习设计的去噪感知信用分配方法,解决时序信用分配缺失与似然估计偏差两大问题,可即插即用地增强任何GRPO训练器。
可解释的智能体检索:让RAG不只是"猜对答案"
纯向量RAG的智能体虽能检索内容却无法解释推理来源。本文探讨基于Neo4j知识图谱、向量与图混合检索、多步验证实体抽取的可解释智能体检索方案,实现可追溯、有来源支撑的AI Agent答案。